HTTPの教科書
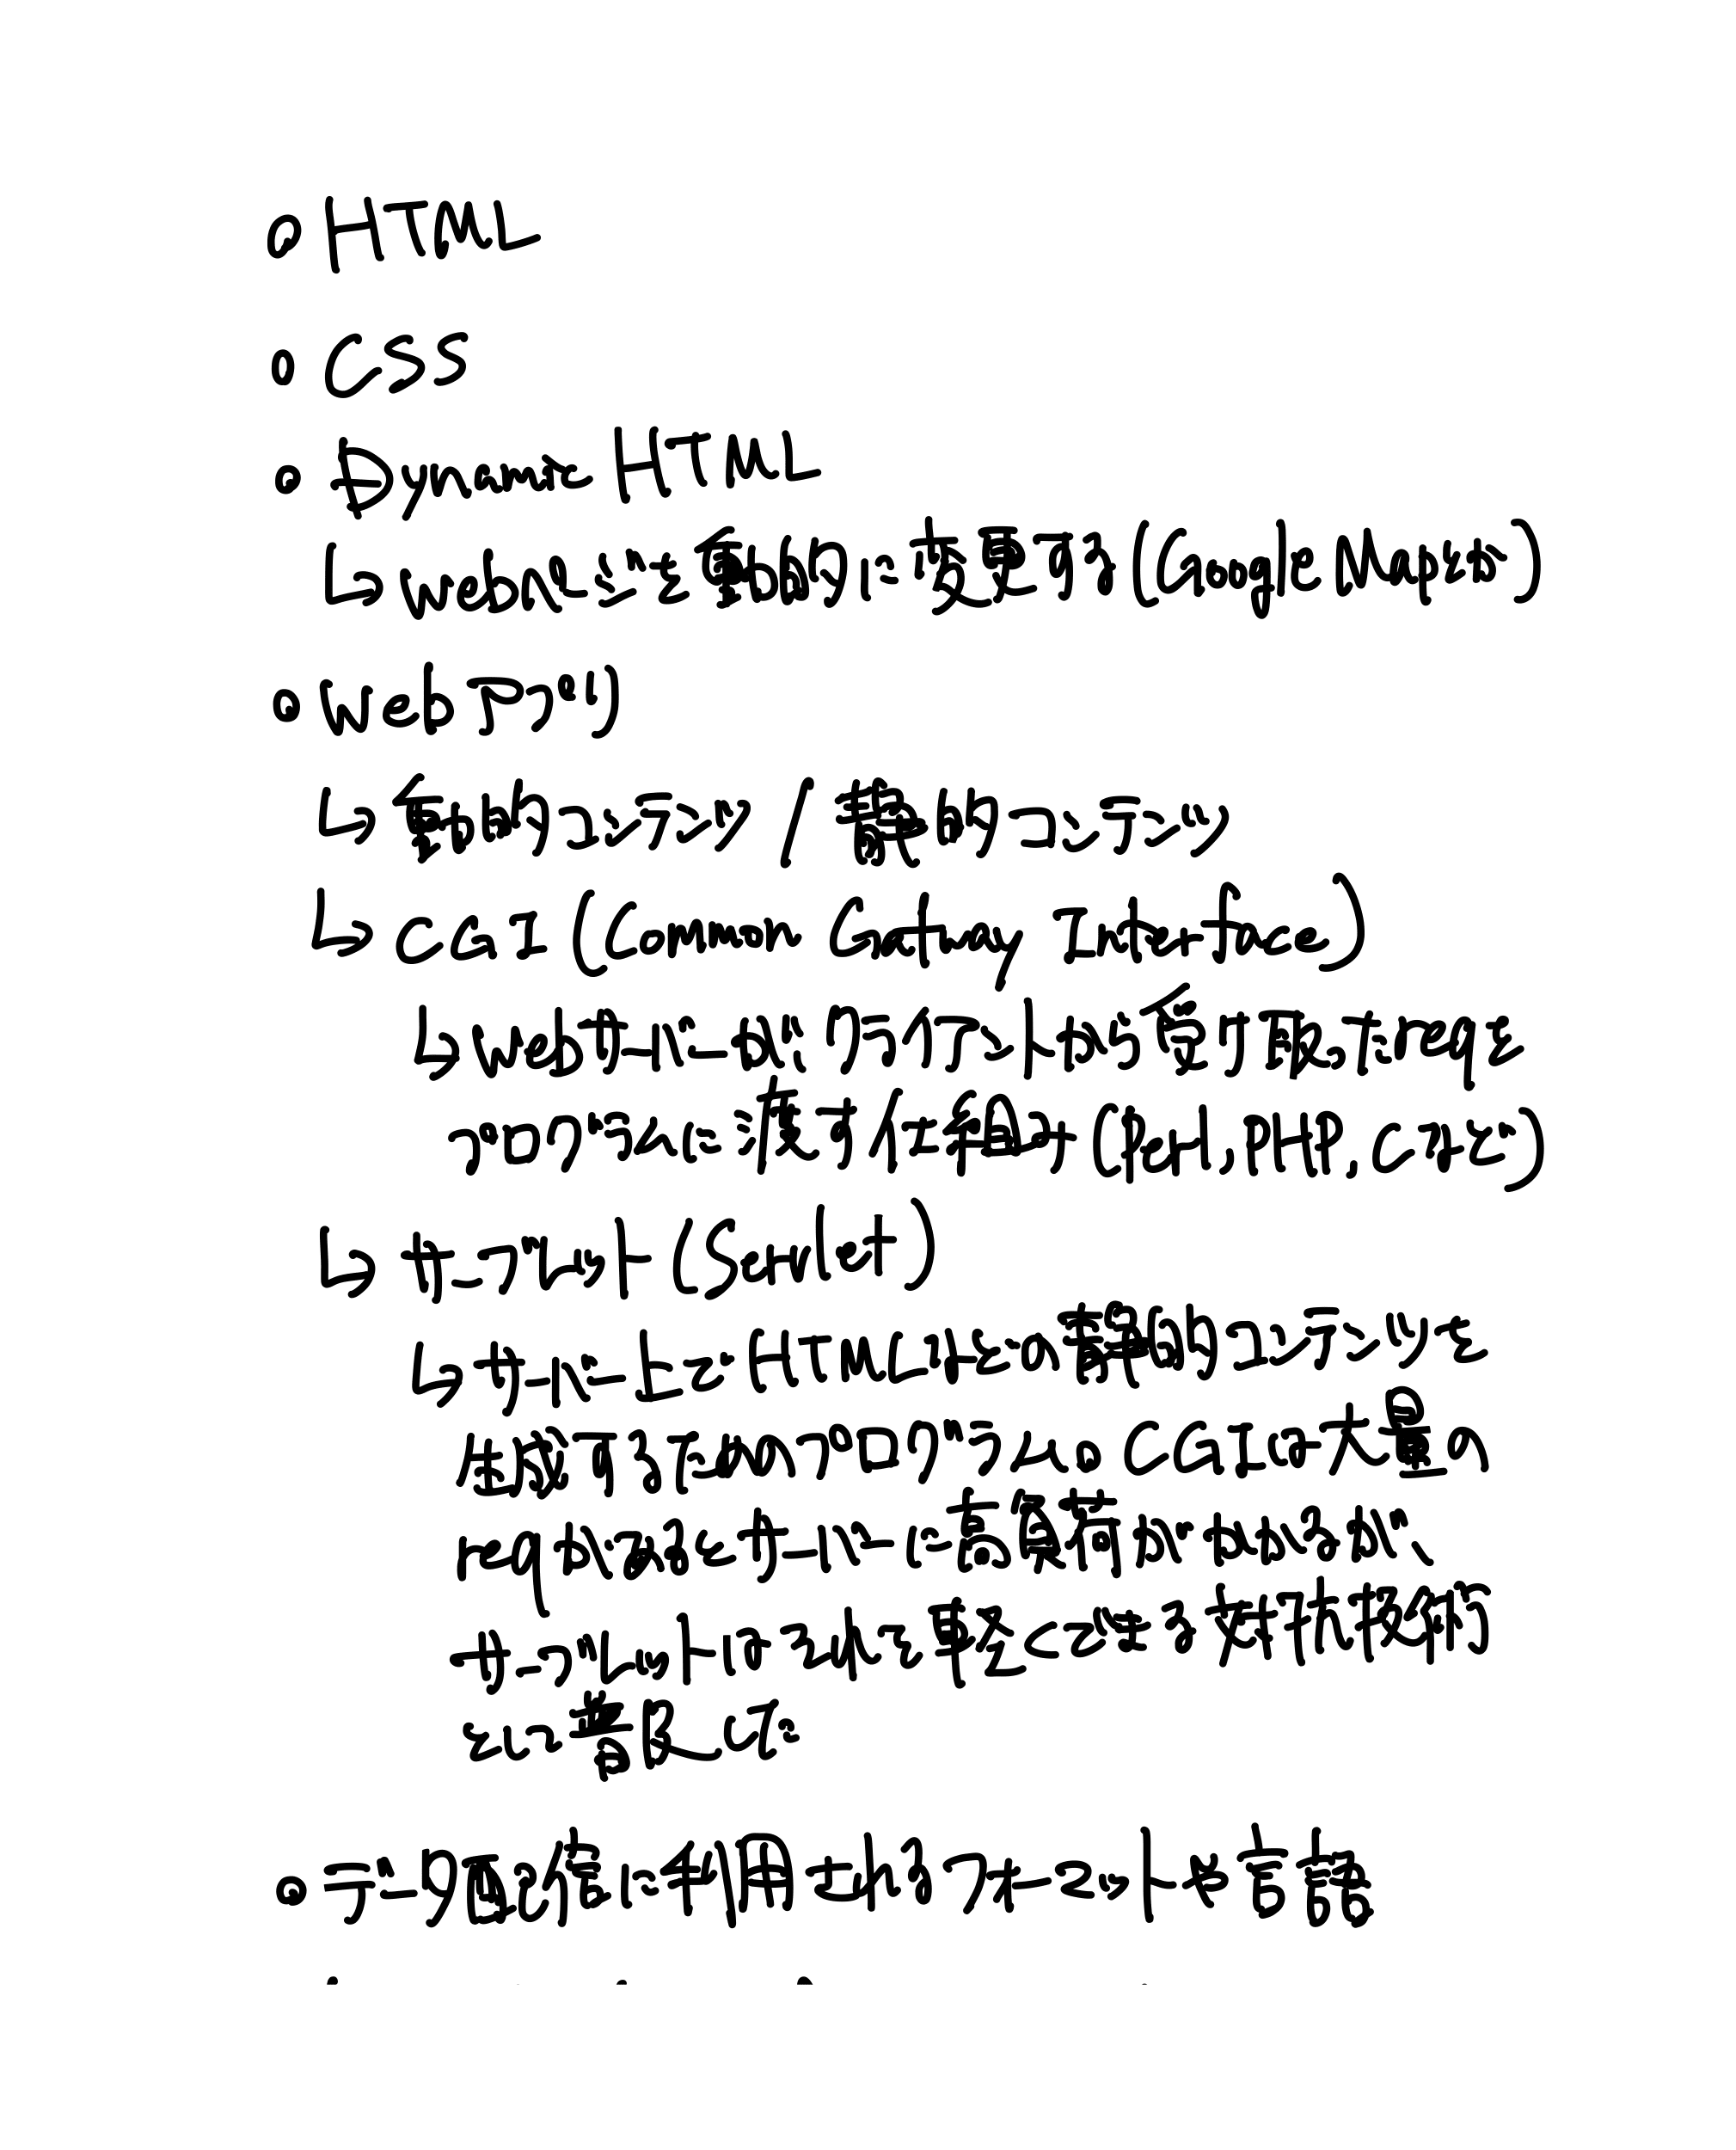
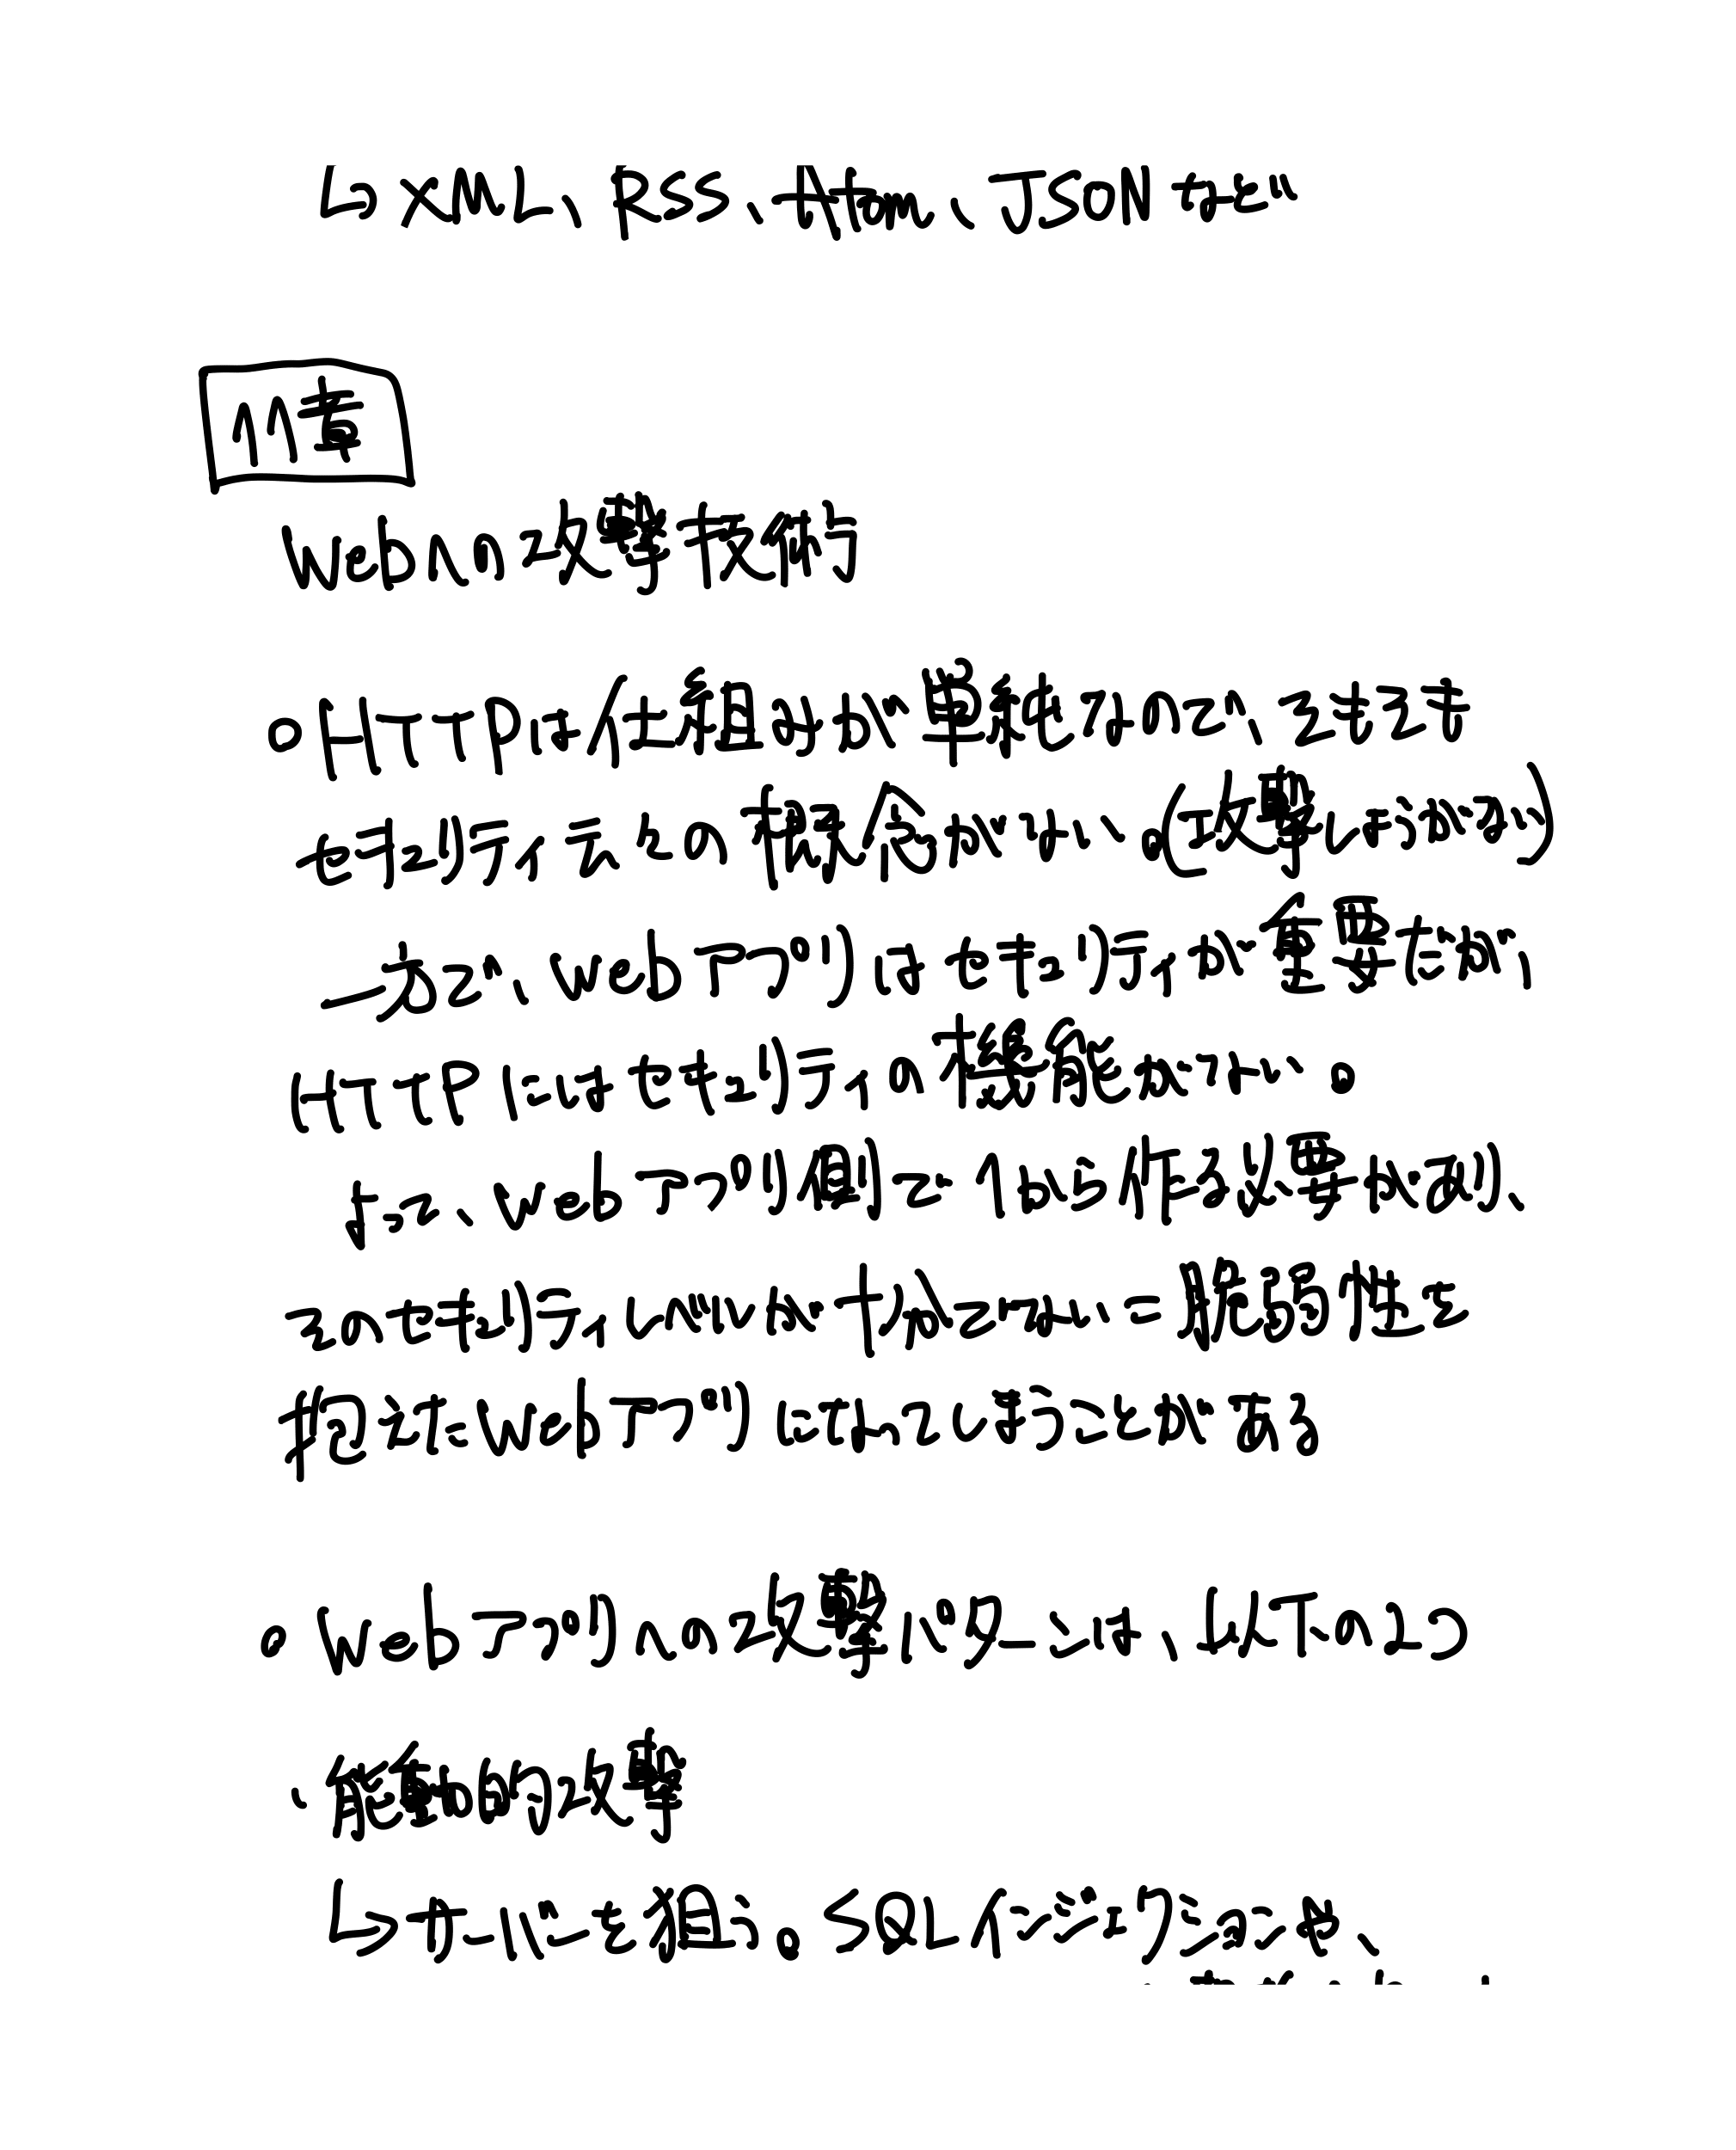
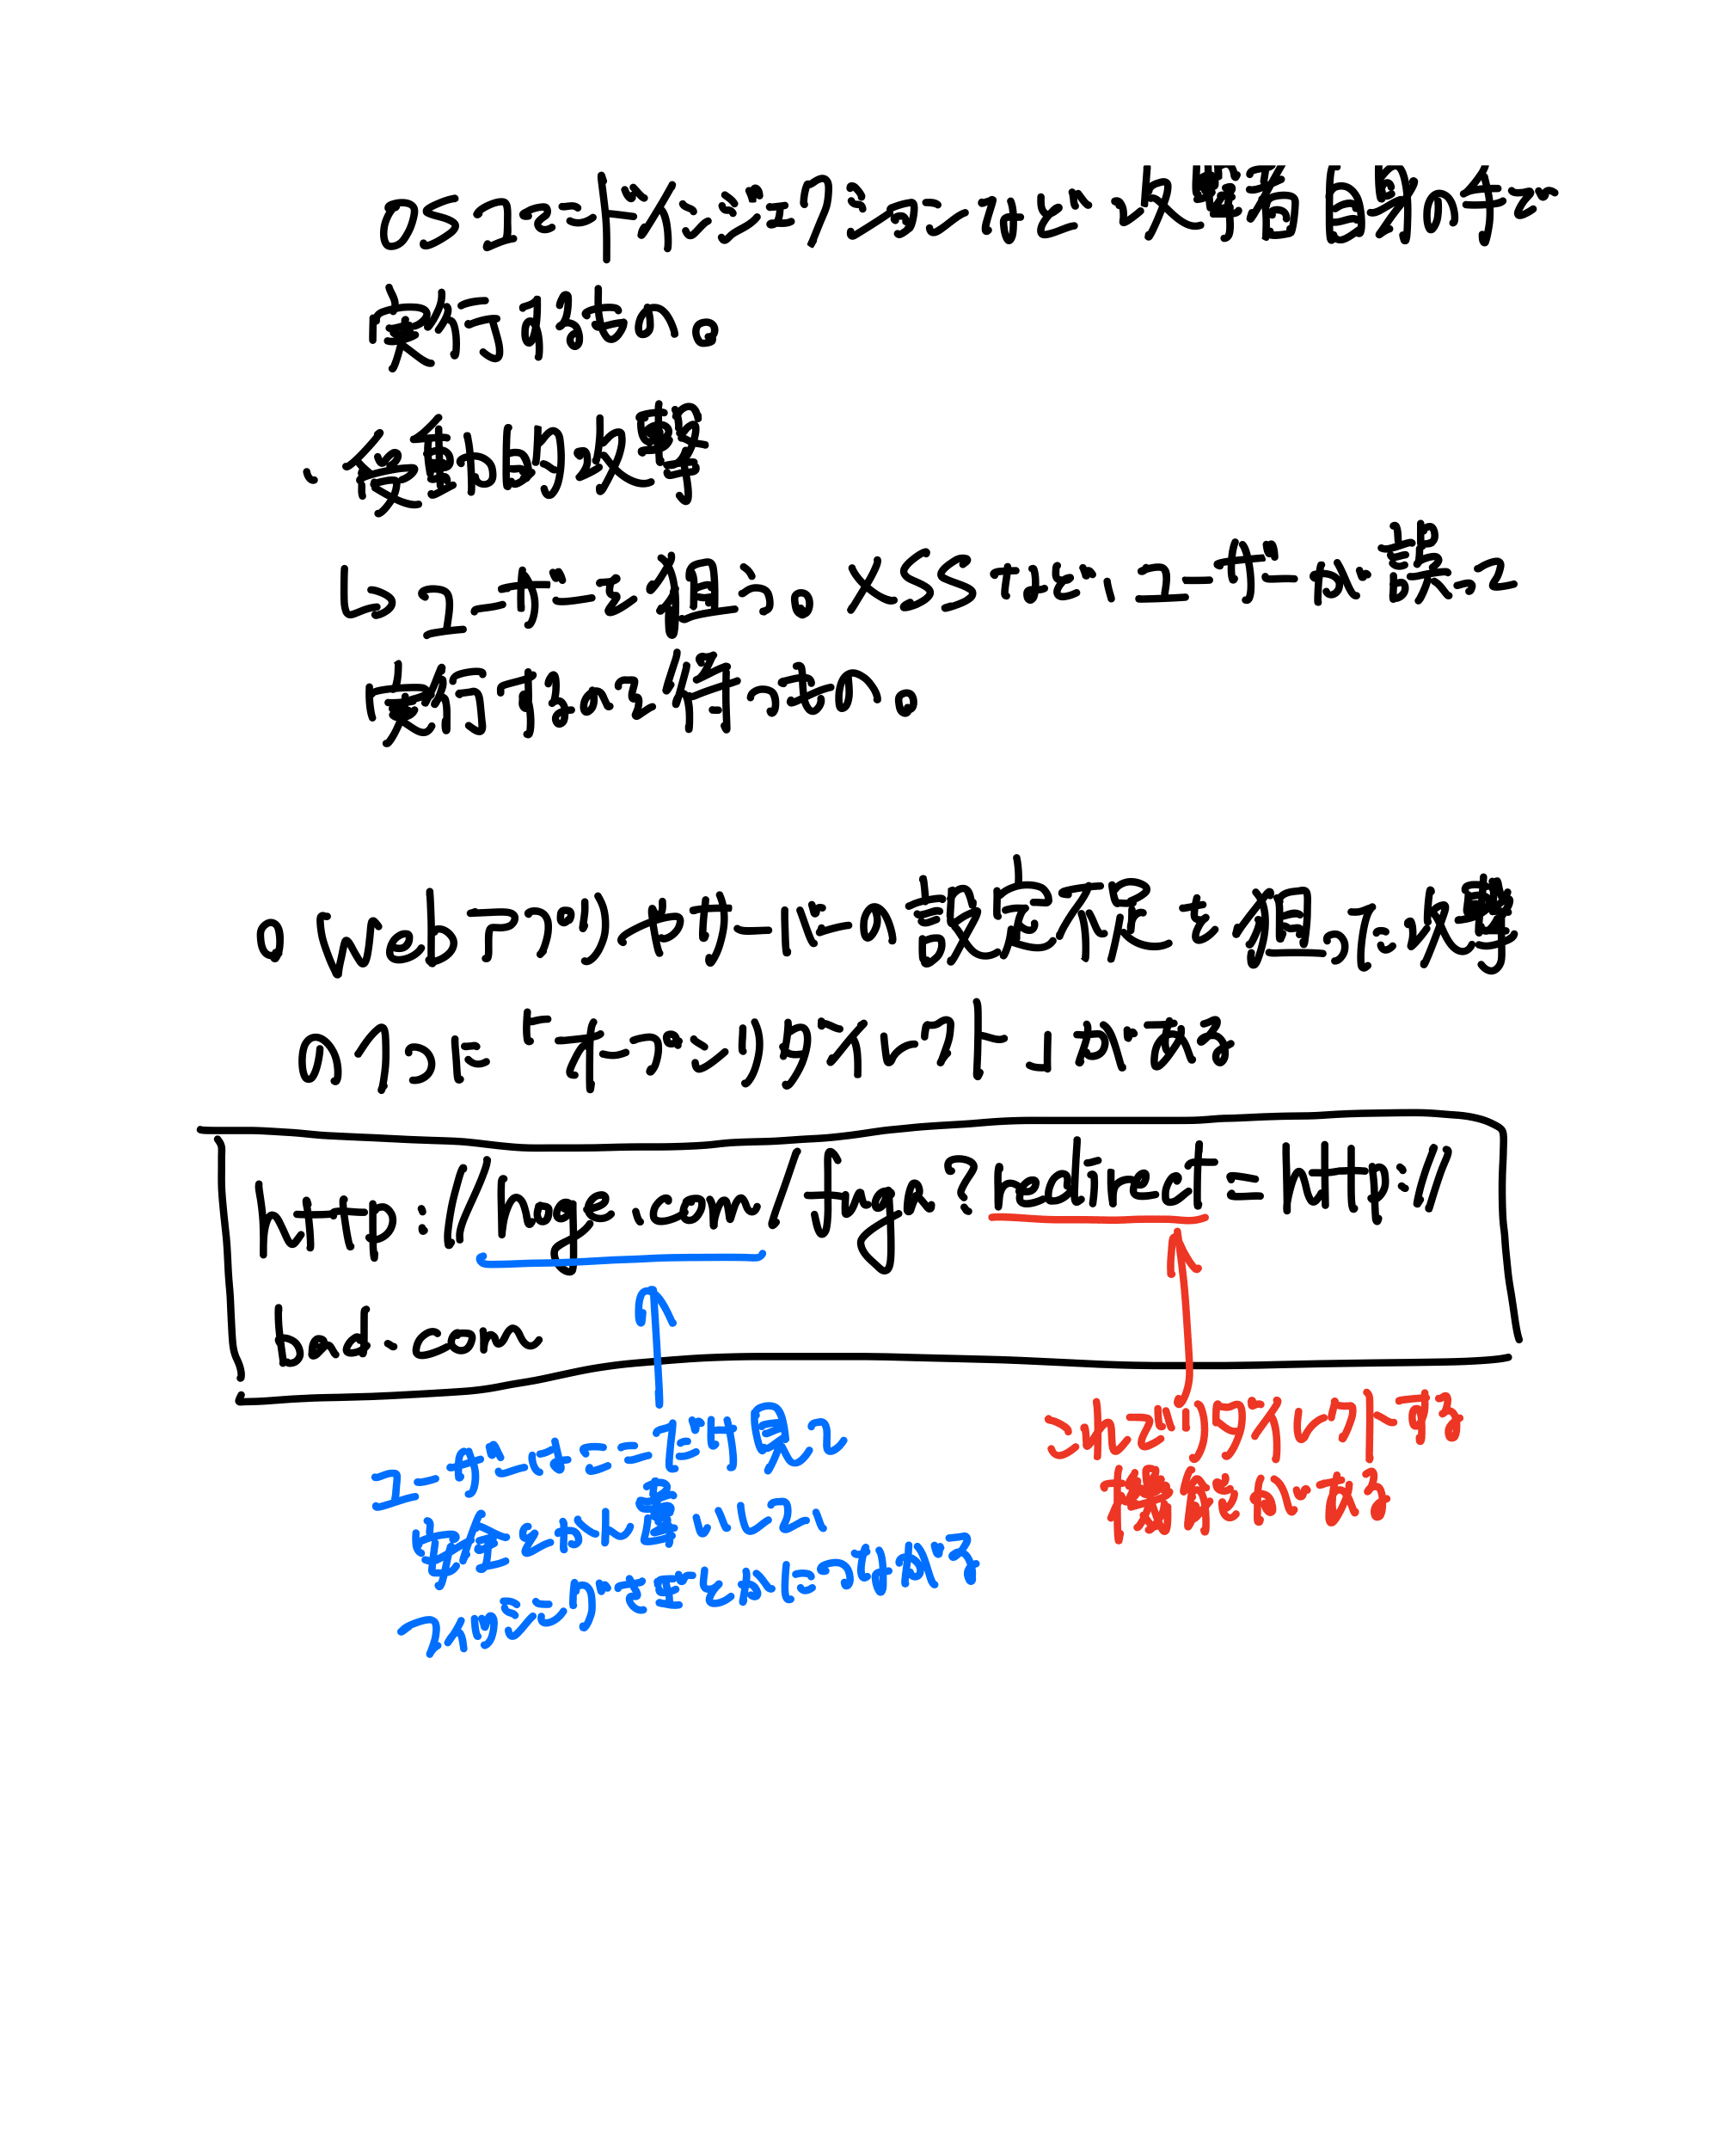
『HTTPの教科書』の手書きノートを文字起こししたまとめ。TCP/IP・HTTPメッセージ・ヘッダー・HTTPS・認証・SPDY/WebSocket・攻撃技術まで、1〜11章分。
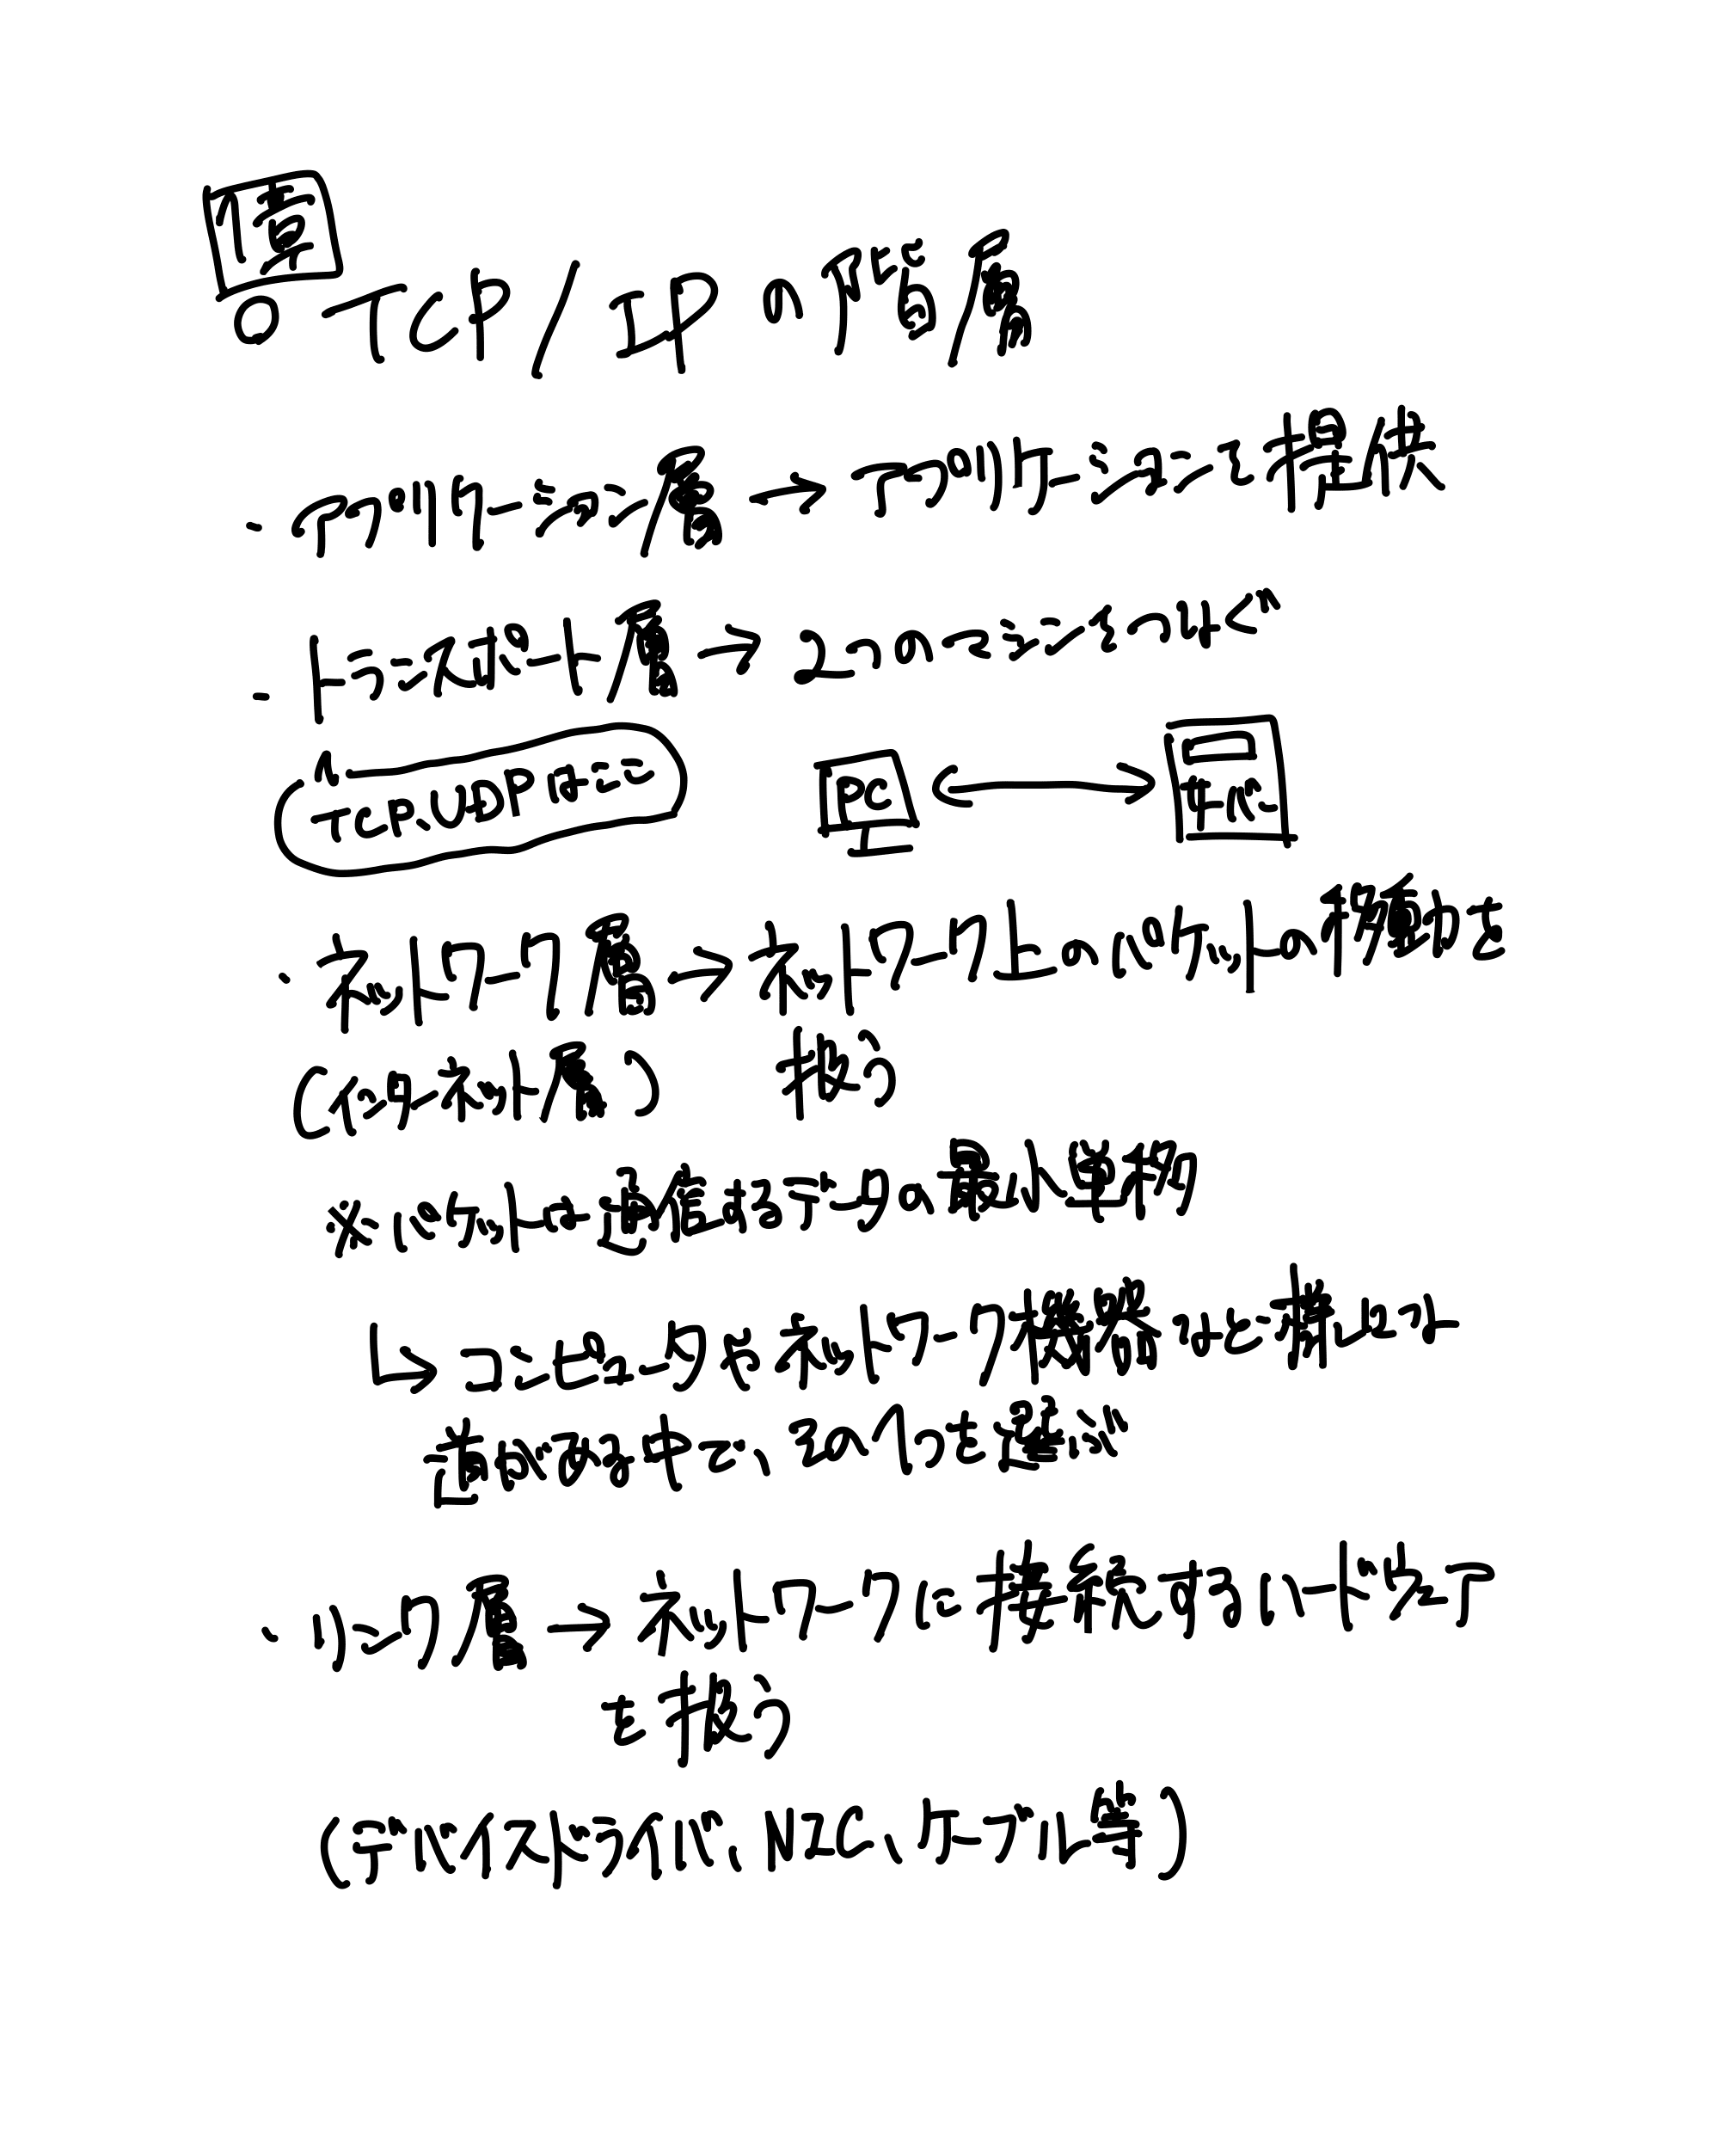
1章 TCP/IP の階層
- アプリケーション層 → アプリケーションを提供
- トランスポート層 → 2つのマシンをつなぐ(TCP、UDP はここ)
- ネットワーク層(インターネット層)→ ネットワーク上のパケットの移動を扱う
- ※パケットは通信されるデータの最小単位
- → コンピュータやネットワーク機器など様々ある中で、その1つを選ぶ
- リンク層 → ネットワークに接続するハードウェアを扱う(デバイスドライバ、NIC、ケーブル等)
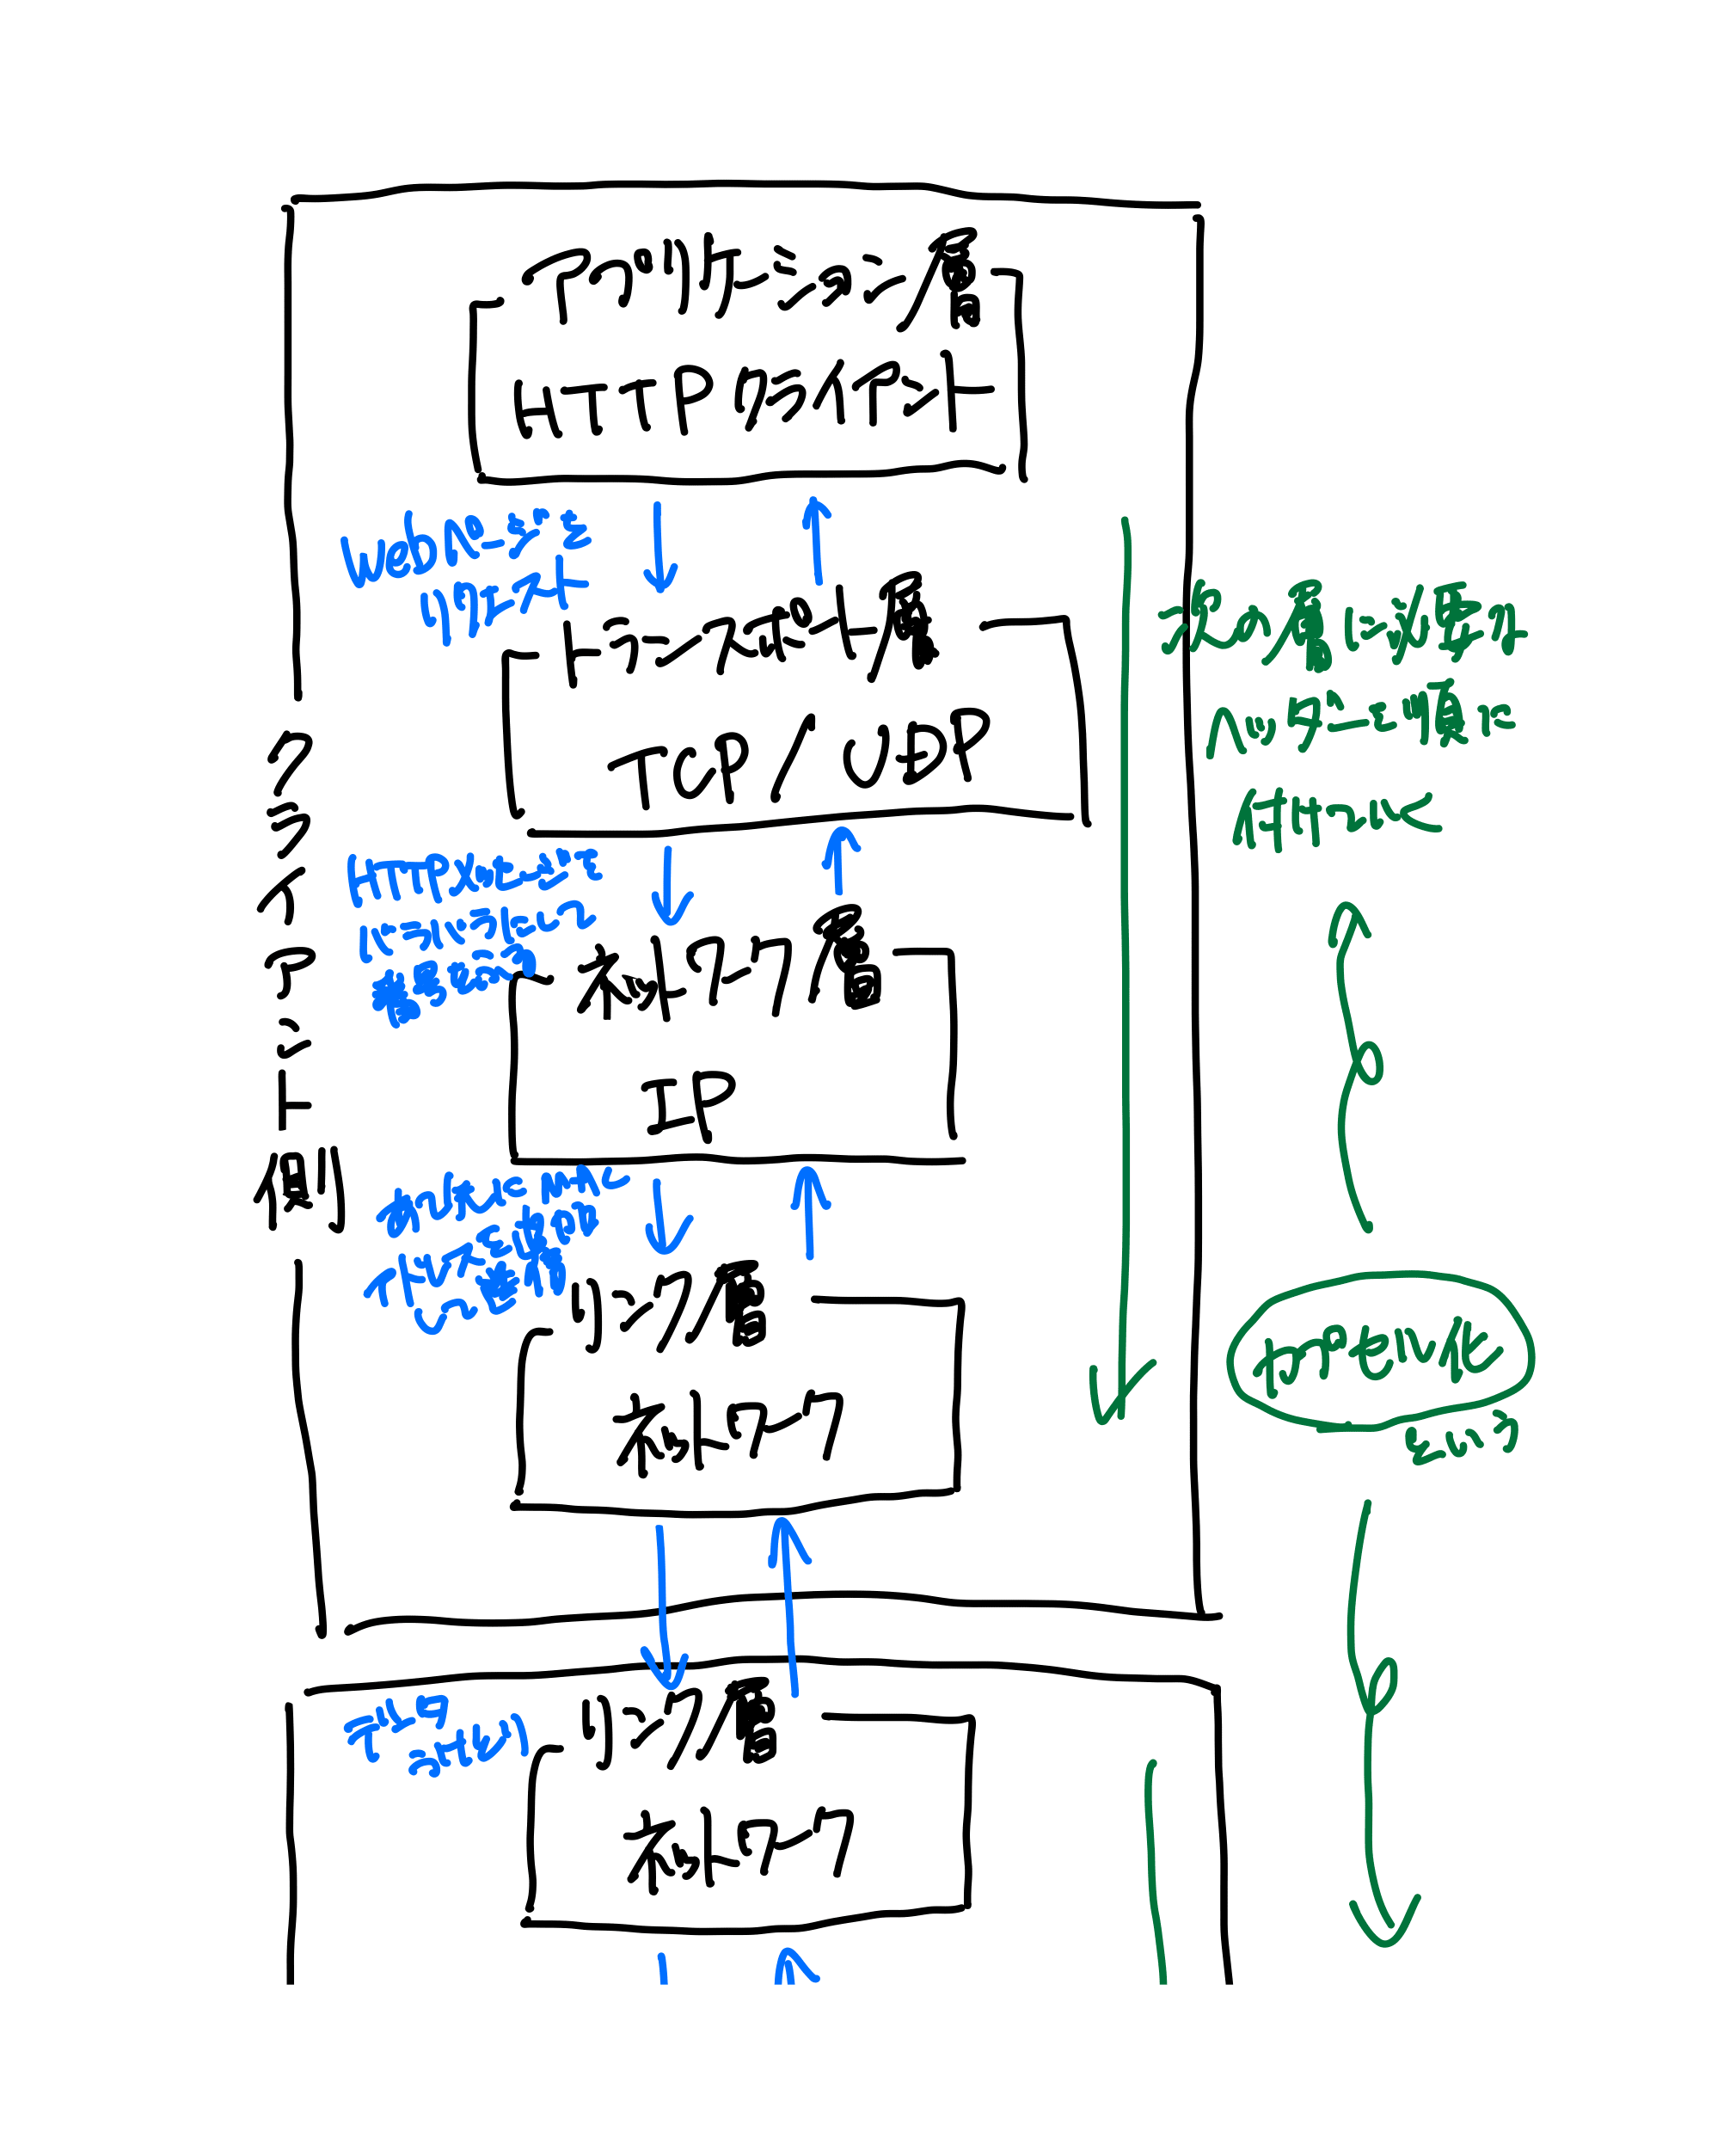
クライアント側(カプセル化)
- アプリケーション層 / HTTPクライアント → Webページをリクエスト
- トランスポート層 / TCP/UDP → HTTPメッセージをバラバラにして構造化
- ネットワーク層 / IP → 相手の MAC アドレスに向けていざ通信
- リンク層 / ネットワーク → デジタルからアナログへ
- 次の層に必要なヘッダーを順に付けていく → これを「カプセル化」という
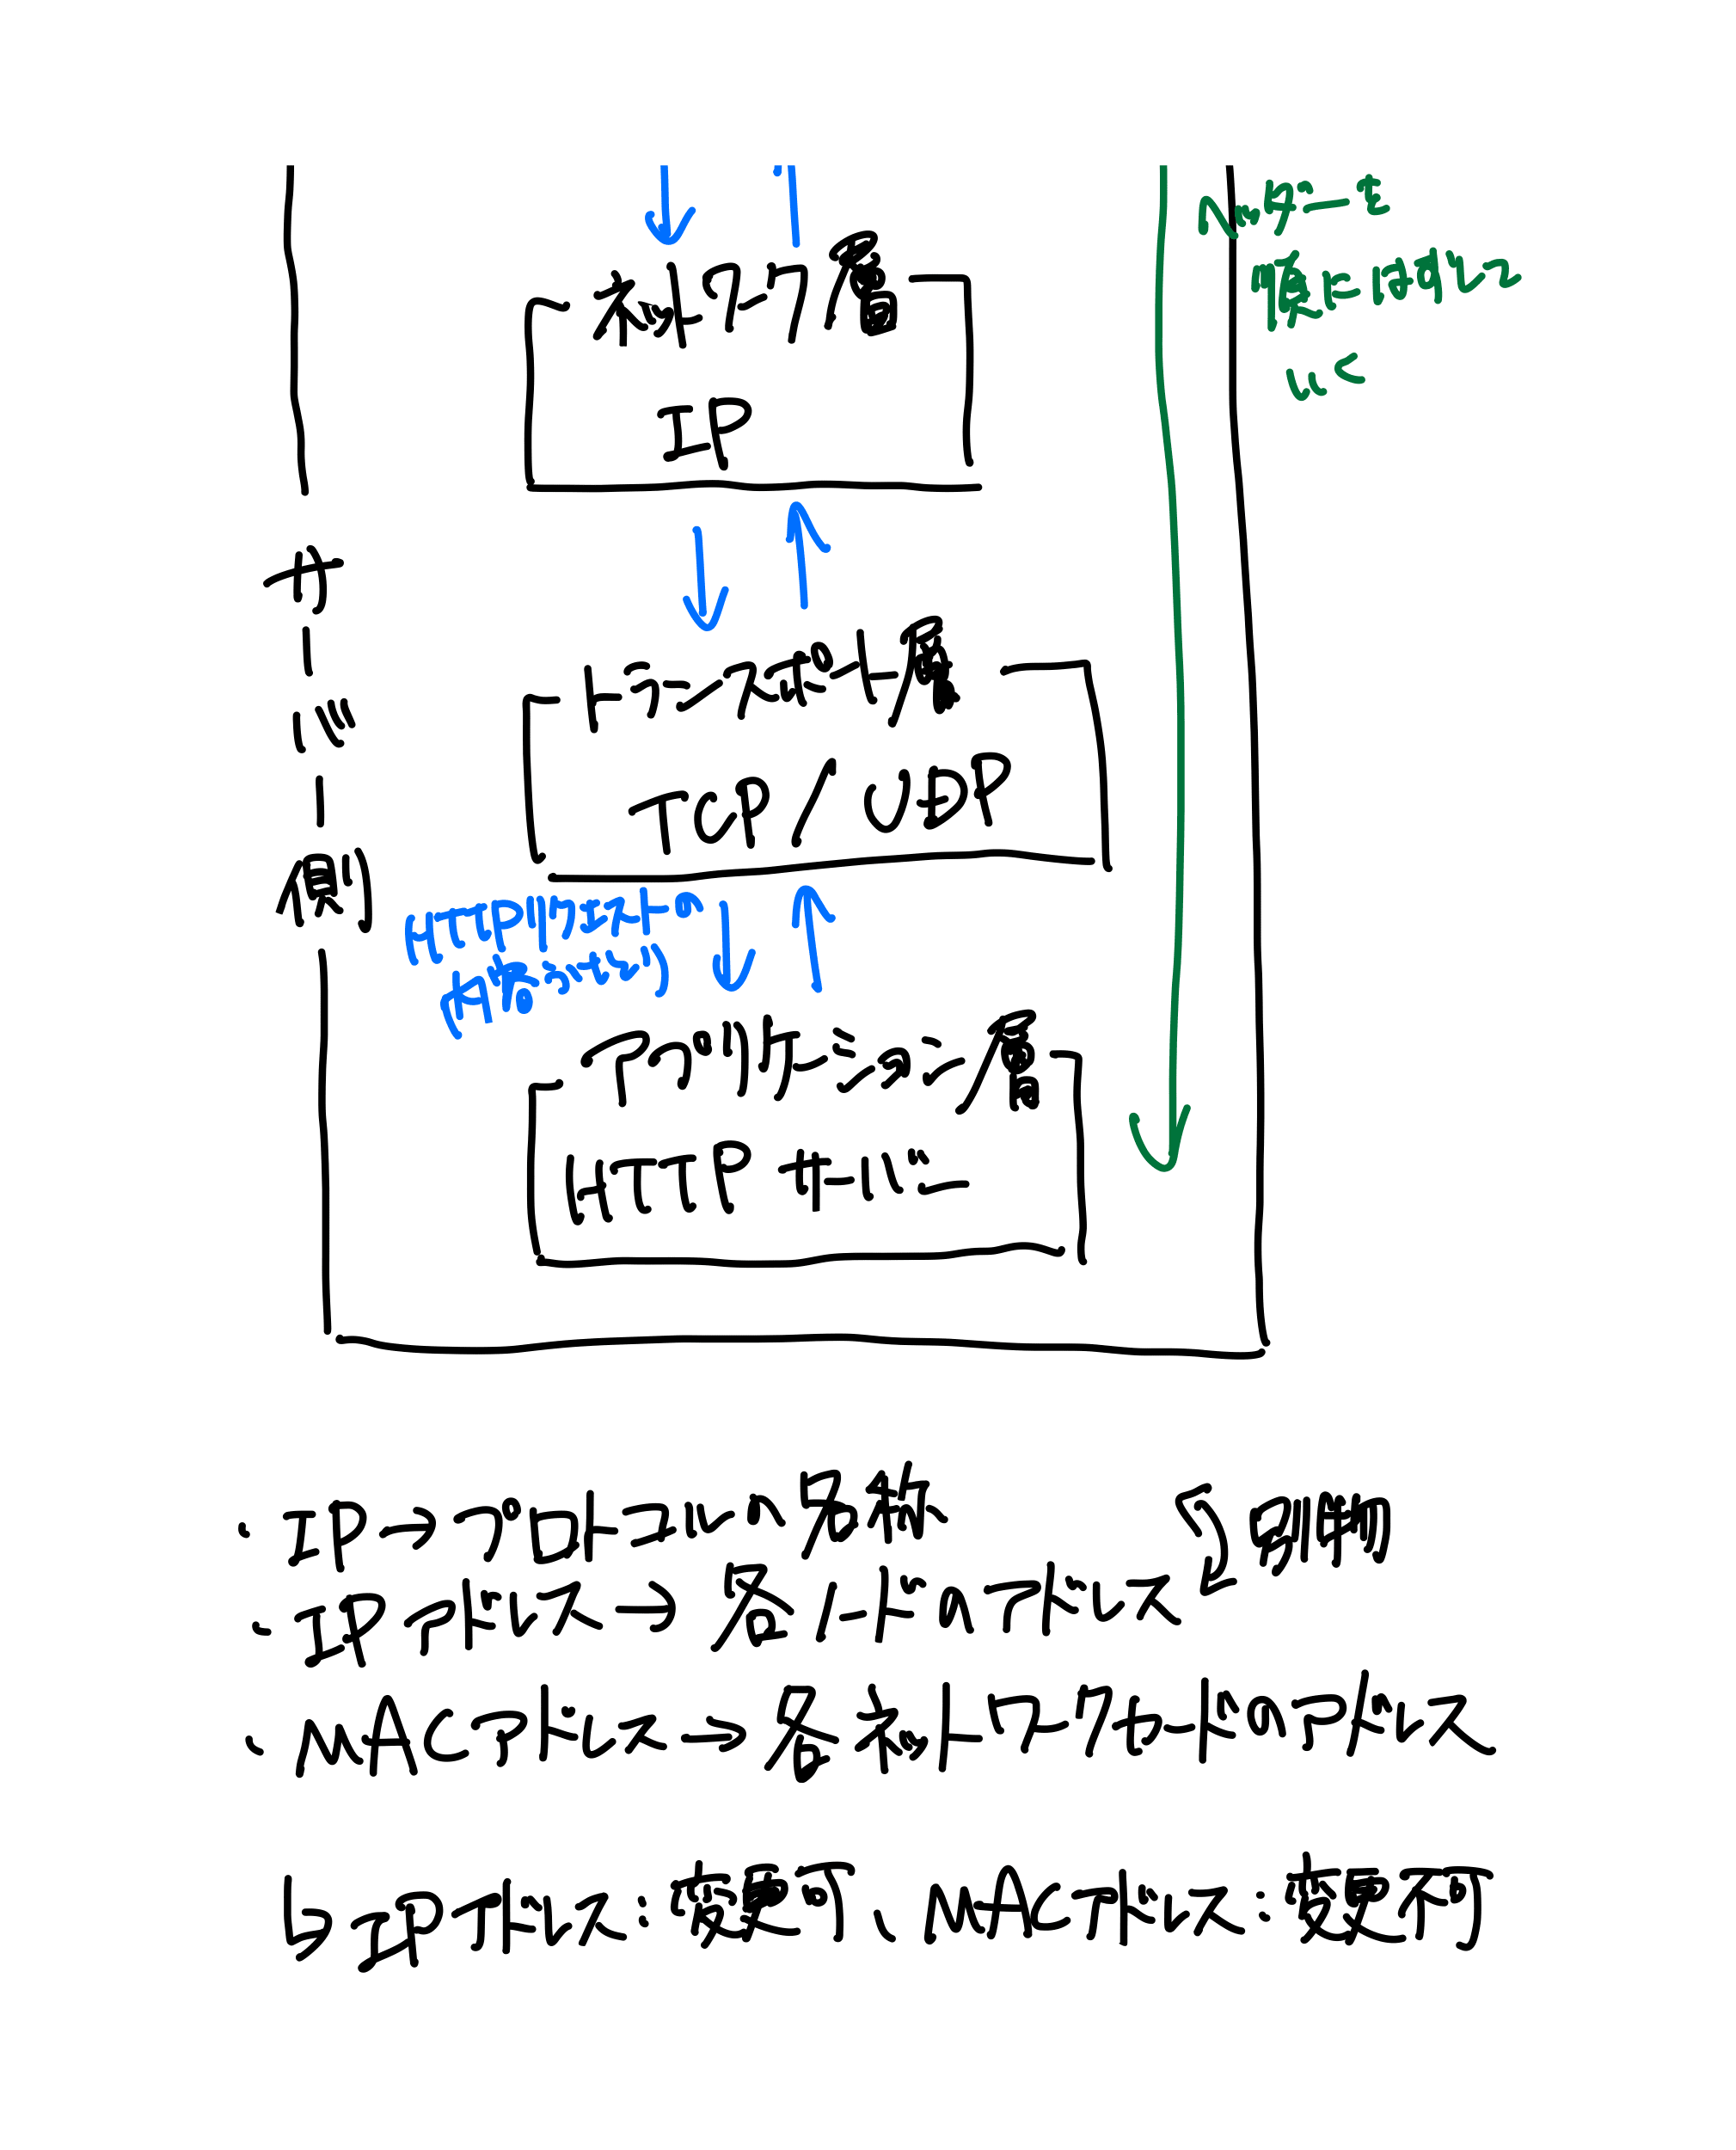
サーバー側
- ネットワーク層 / IP → トランスポート層 / TCP/UDP → アプリケーション層 / HTTPサーバー(HTTPリクエストの内容を分析)
- ヘッダーを順にはずしていく
- IP → プロトコルの名称、IPアドレス → 各ノードのアドレス(別物)
- MACアドレス → 各ネットワークカードのアドレス
- → IPアドレス:変更可、MACアドレス:変更不可
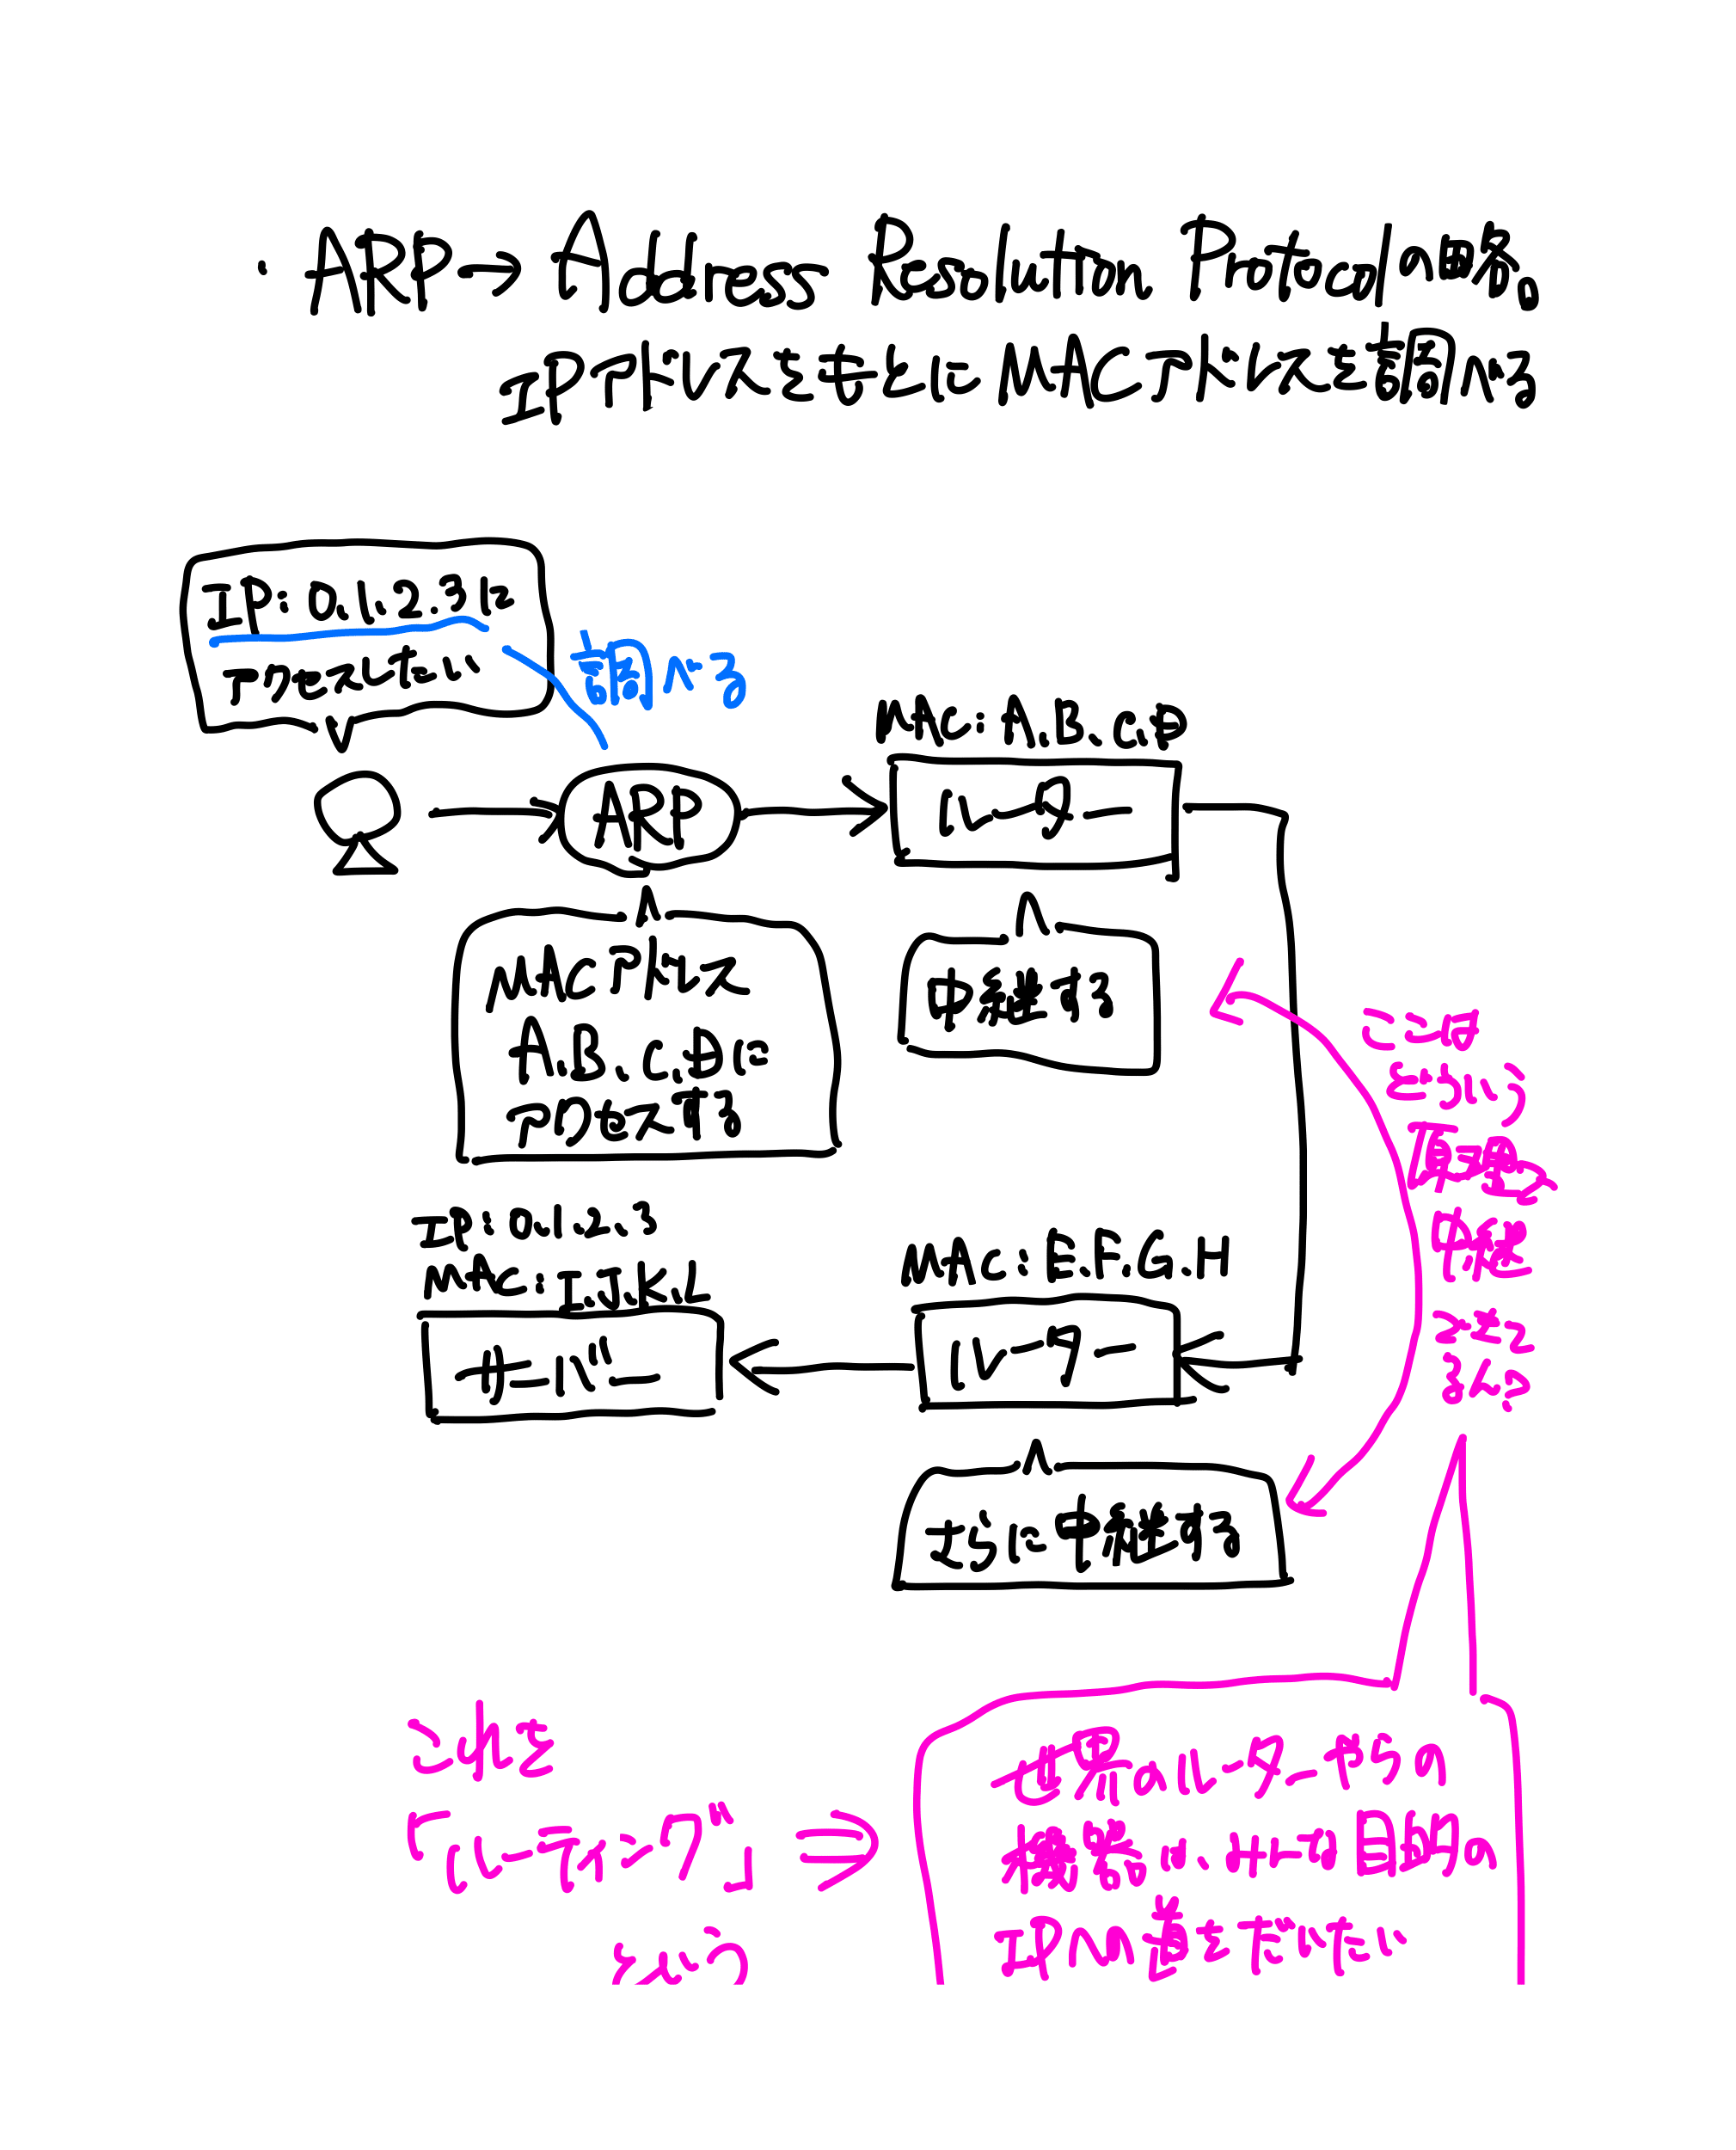
ARP(Address Resolution Protocol)
- IPアドレスをもとに MACアドレスを調べるプロトコル。
- IP: 0.1.2.3 にアクセスしたい → ARP で調べる → ルーター(MAC)へ → 中継 → ルーター → 中継 → サーバー(IP・MAC)に到達。
- どういう順序で中継される? → 世界のルーターなどの機器は、目的のIPへの道をだいたい知っている。
- これを「ルーティング」という。
TCP
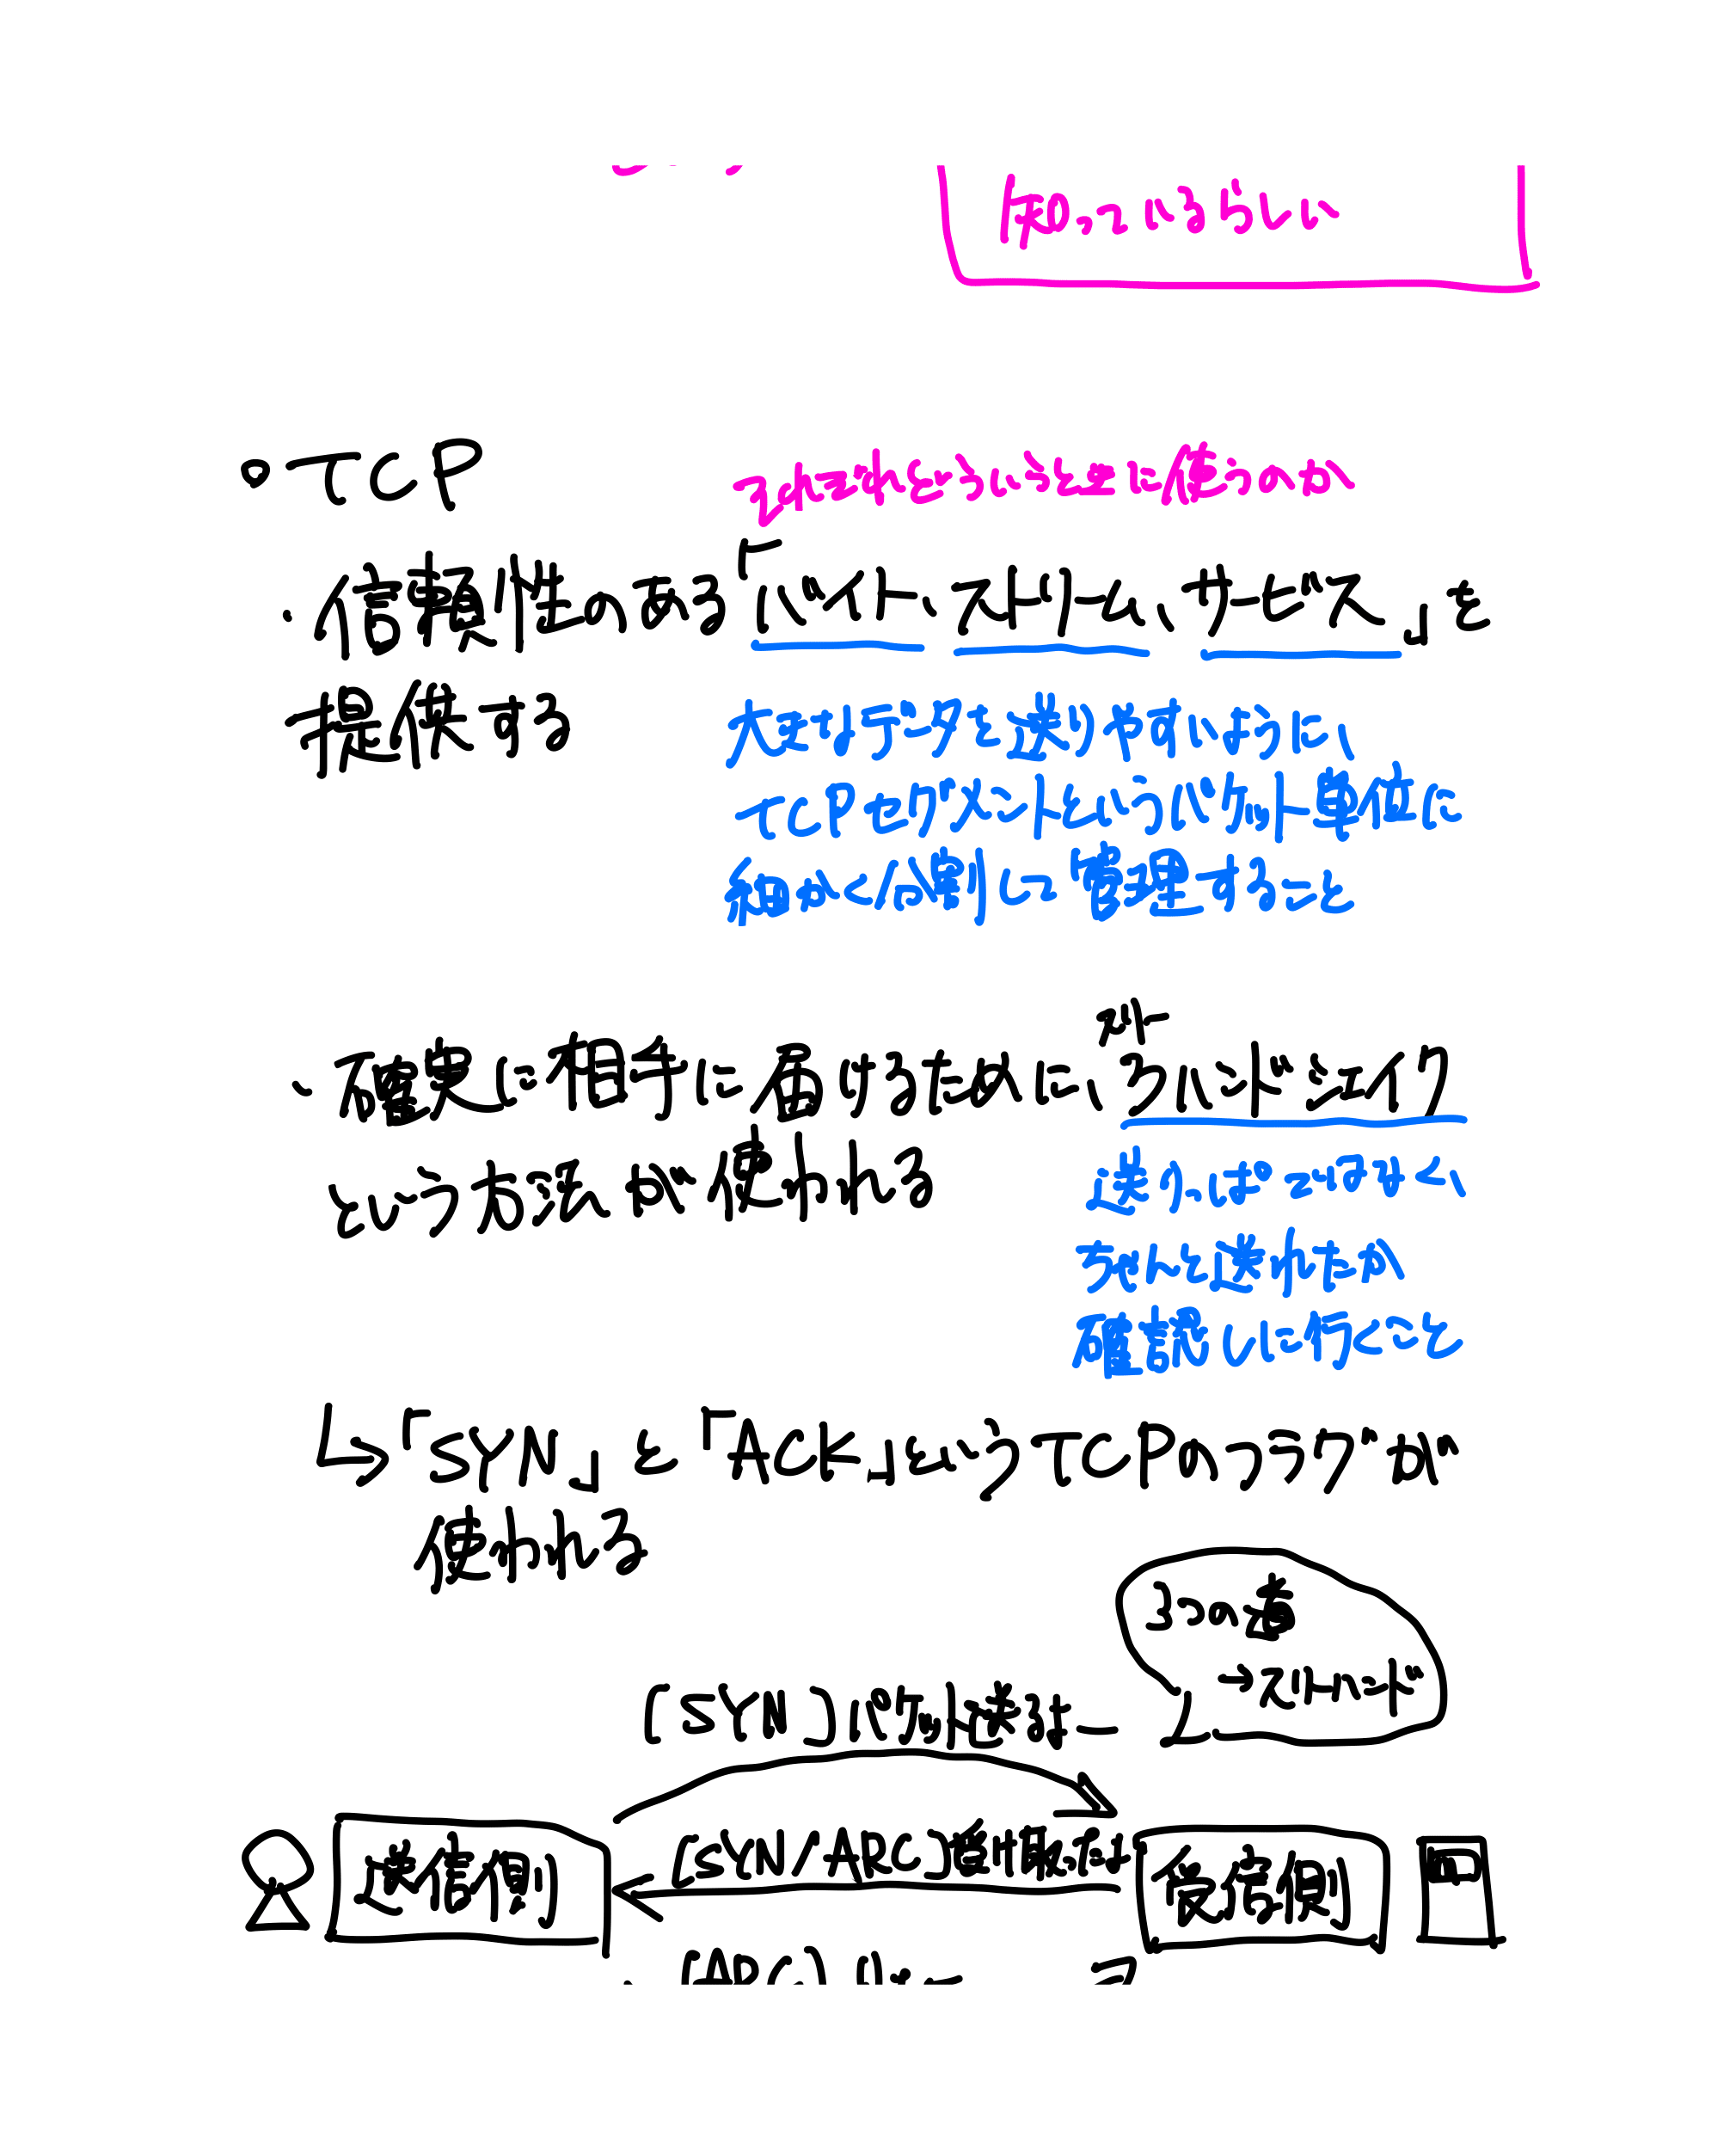
- 信頼性のある「バイトストリームサービス」を提供する。
- 大量のデータを送りやすいように、TCPセグメントというパケット単位に細かく分割して管理する。
- 確実に相手に届けるために、スリーハンドシェイク(3way)という方法が使われる(送りっぱなしではなく、ちゃんと送れたか確認しに行く)。
- 「SYN」と「ACK」というTCPのフラグが使われる。
- 送信側 →「SYN」パケット送る→ 受信側
- 送信側 ←「SYN/ACK」返却された← 受信側
- 送信側 →「ACK」→ 受信側
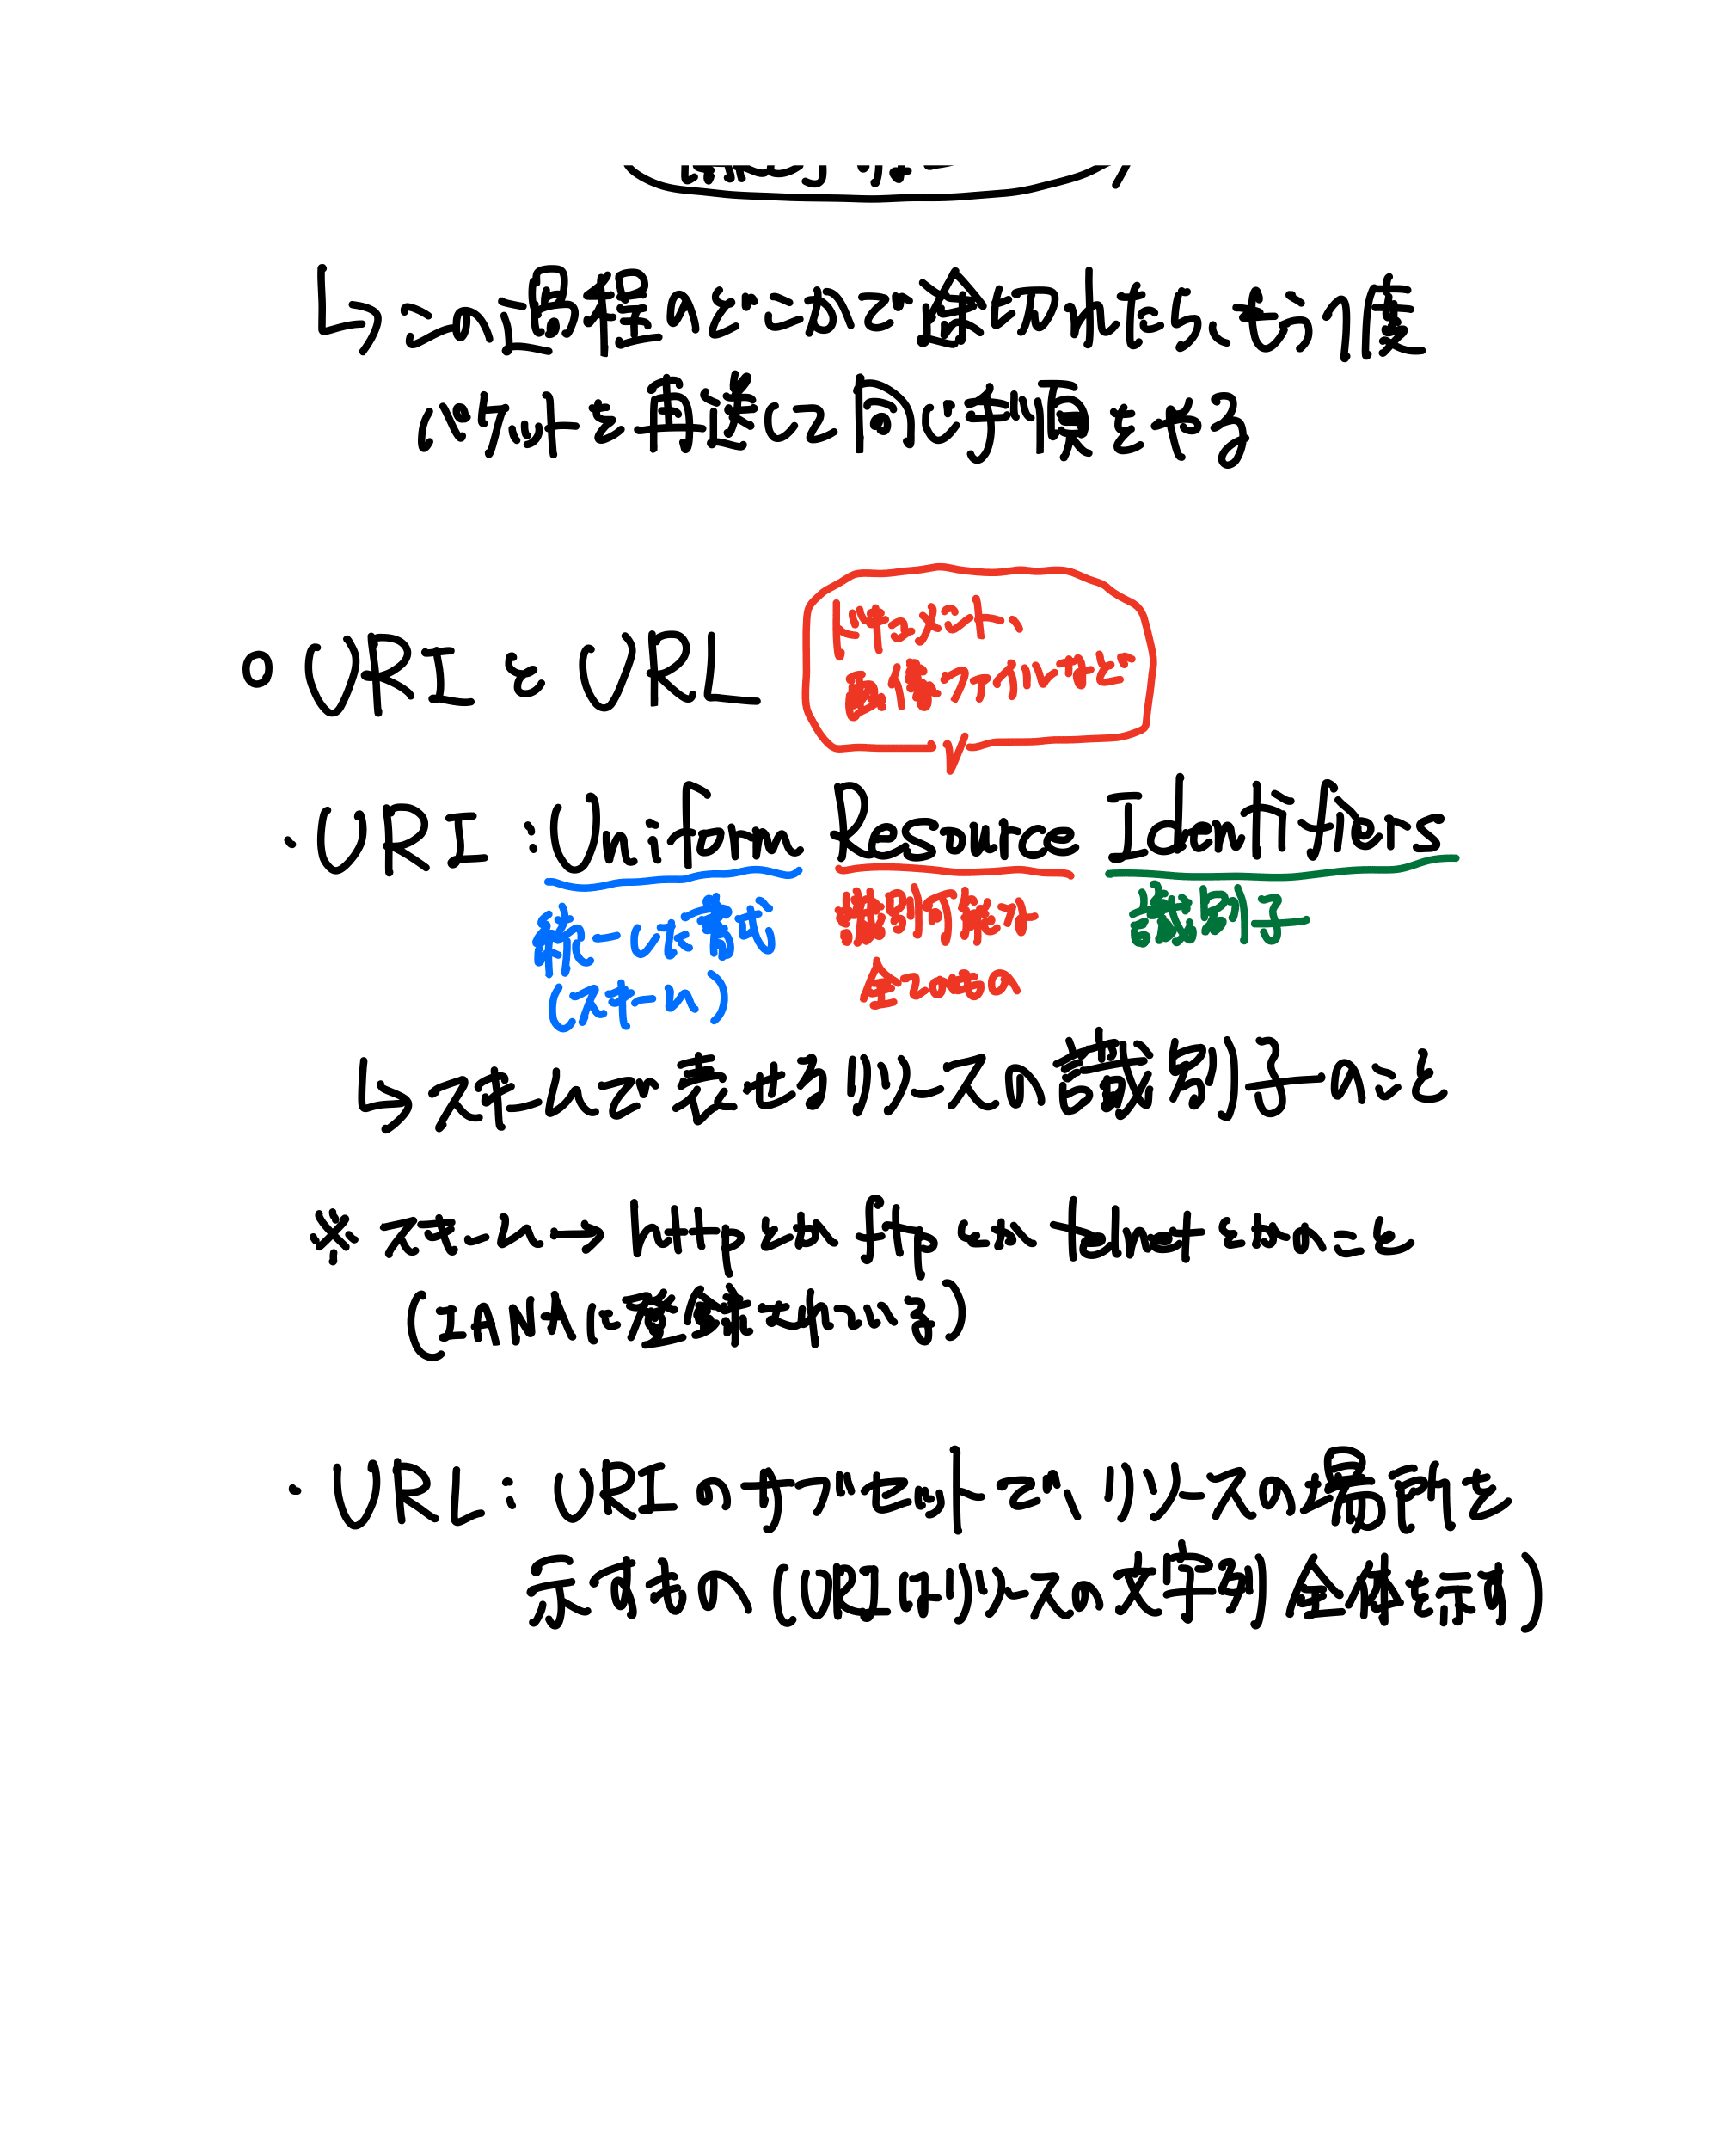
- この過程のどこかで途切れたら、もう1度パケットを再送して同じ手順をやる。
URI と URL
- URI:Uniform Resource Identifiers
- Uniform(統一した書式(スキーム))/ Resource(識別可能な全てのもの)/ Identifiers(識別子)
- → スキームで表せるリソースの識別子のこと(ドキュメント、画像ファイルなど)
- ※スキーム → http、ftp、telnet などのこと(IANA に登録されている)
- URL:URI のサブセットで、リソースの場所を示すもの(URIはリソースの文字列全体を示す)
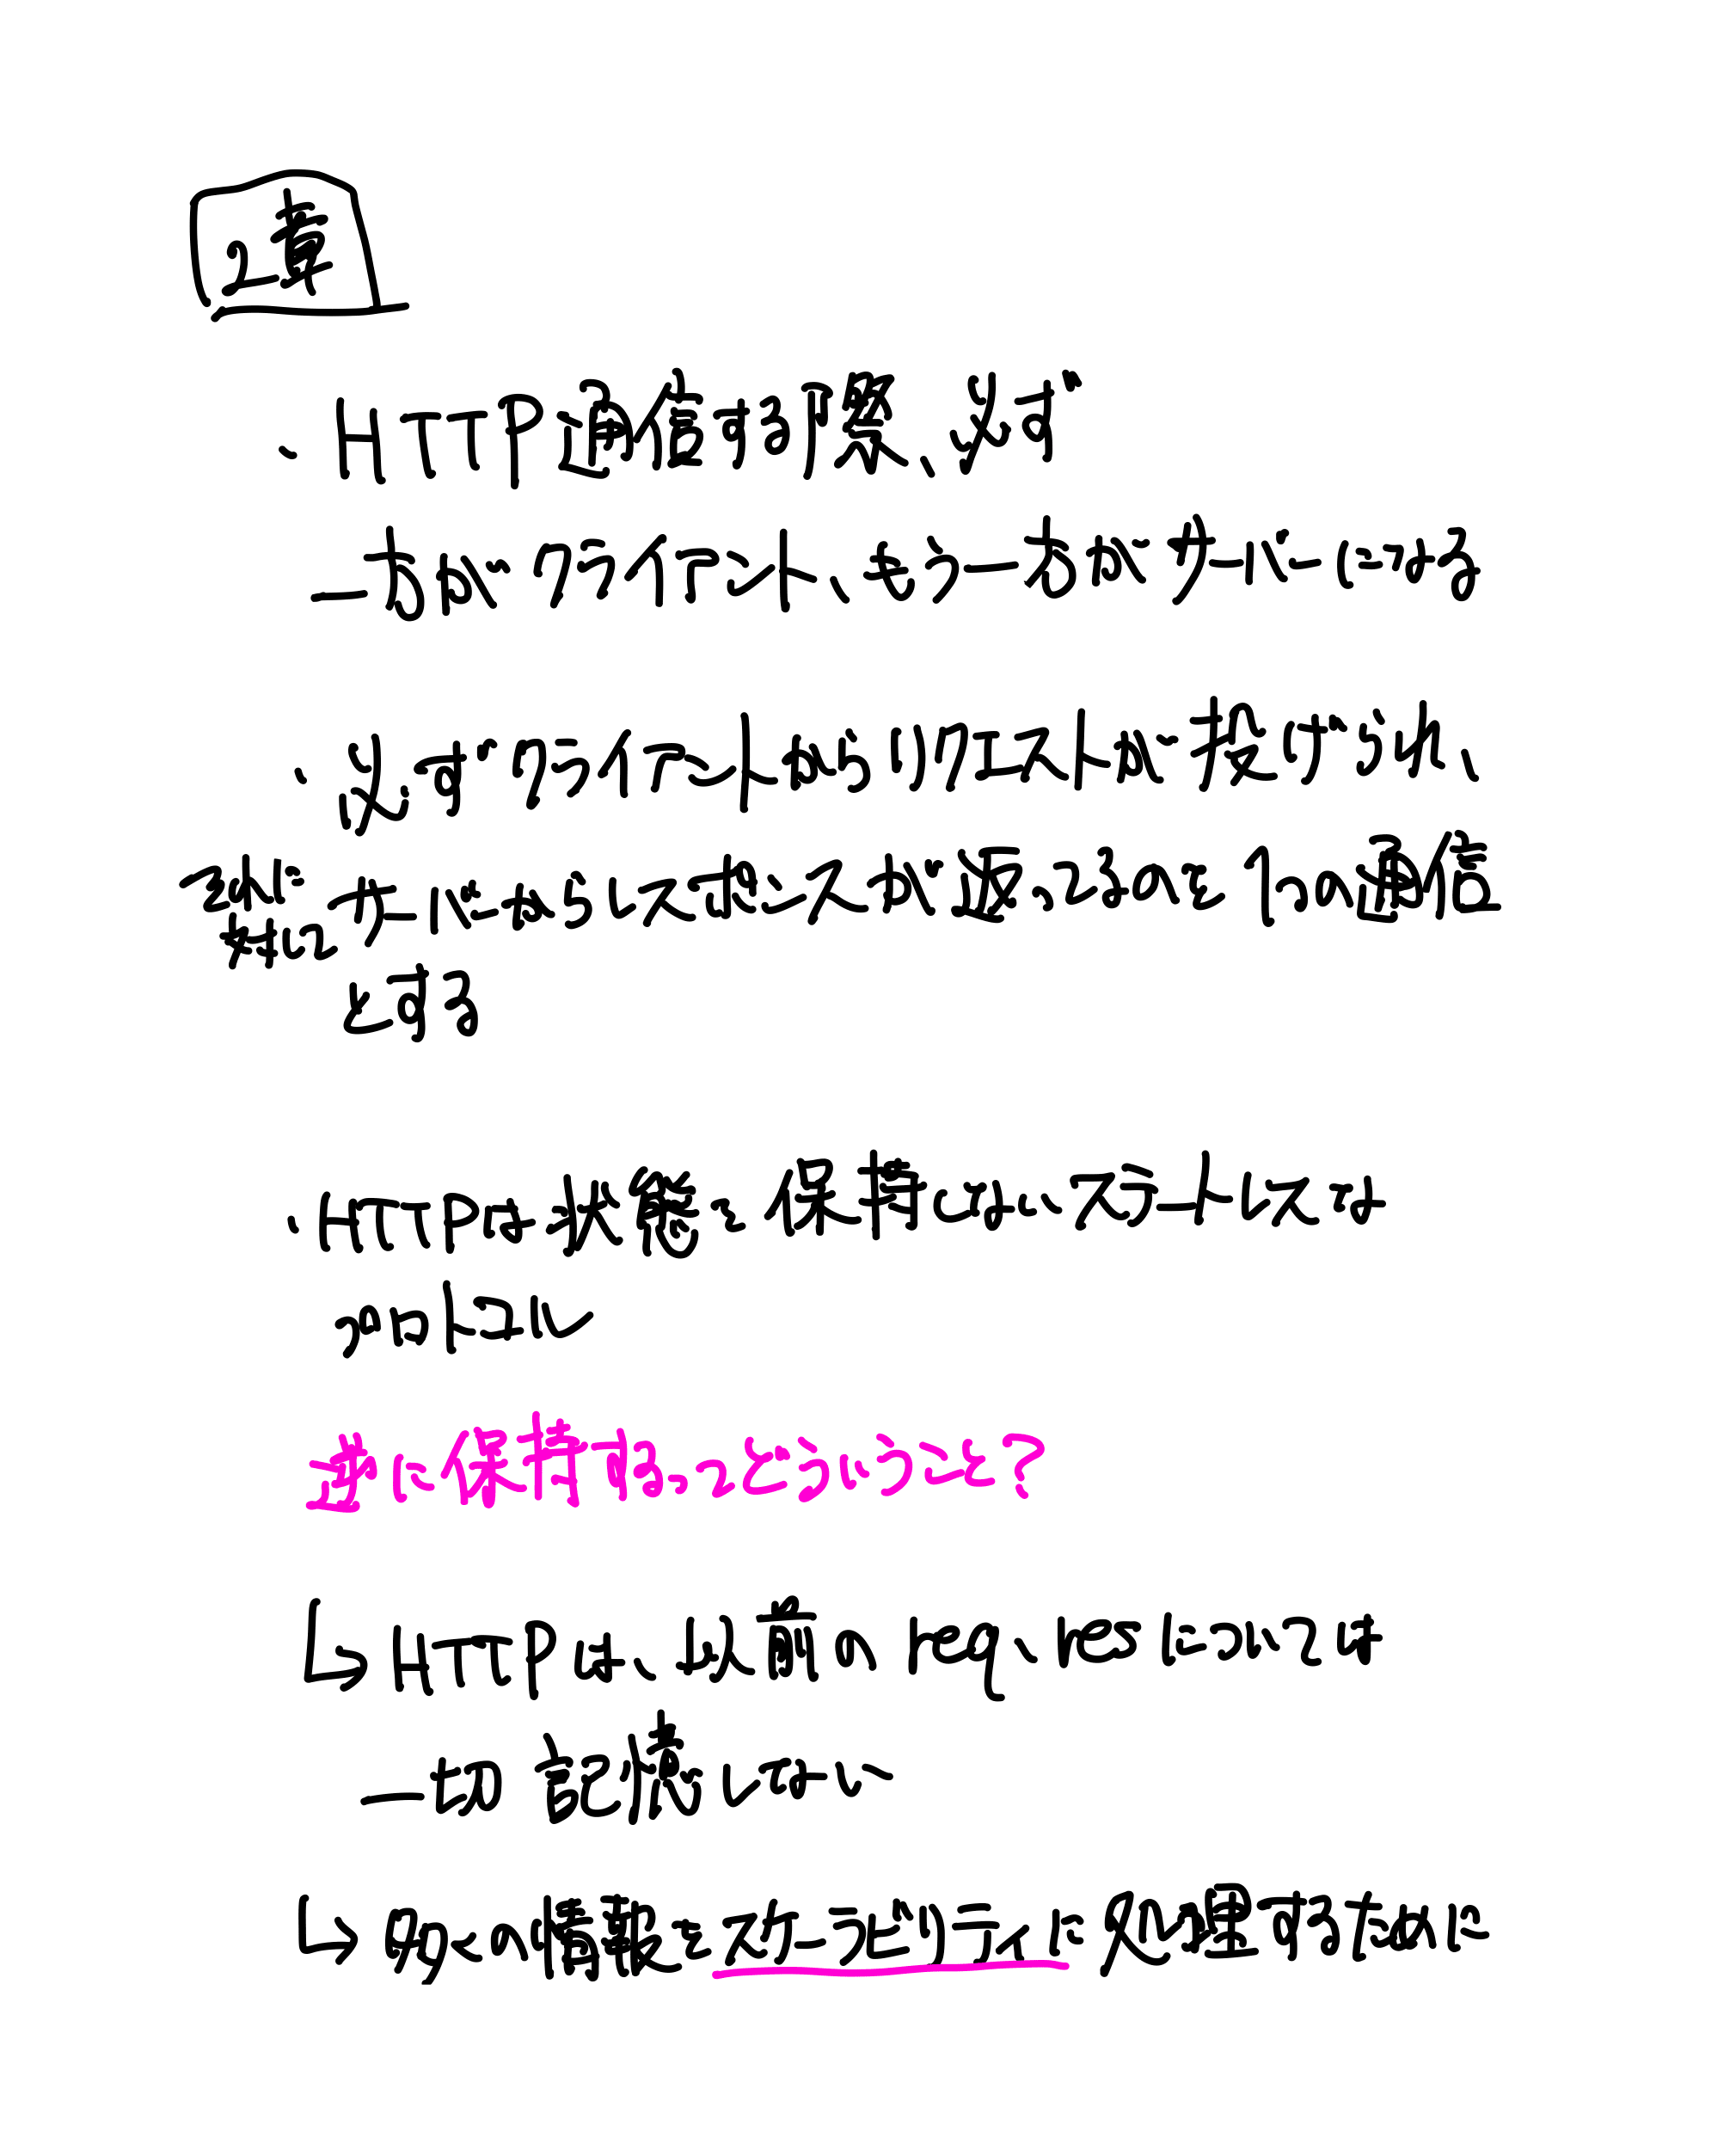
2章 HTTPの基本
- HTTP通信する際、必ず一方がクライアント、もう一方がサーバーになる。
- 必ずクライアントからリクエストが投げられ、それに対しサーバーからレスポンスが返ってくるのを1つの通信とする。
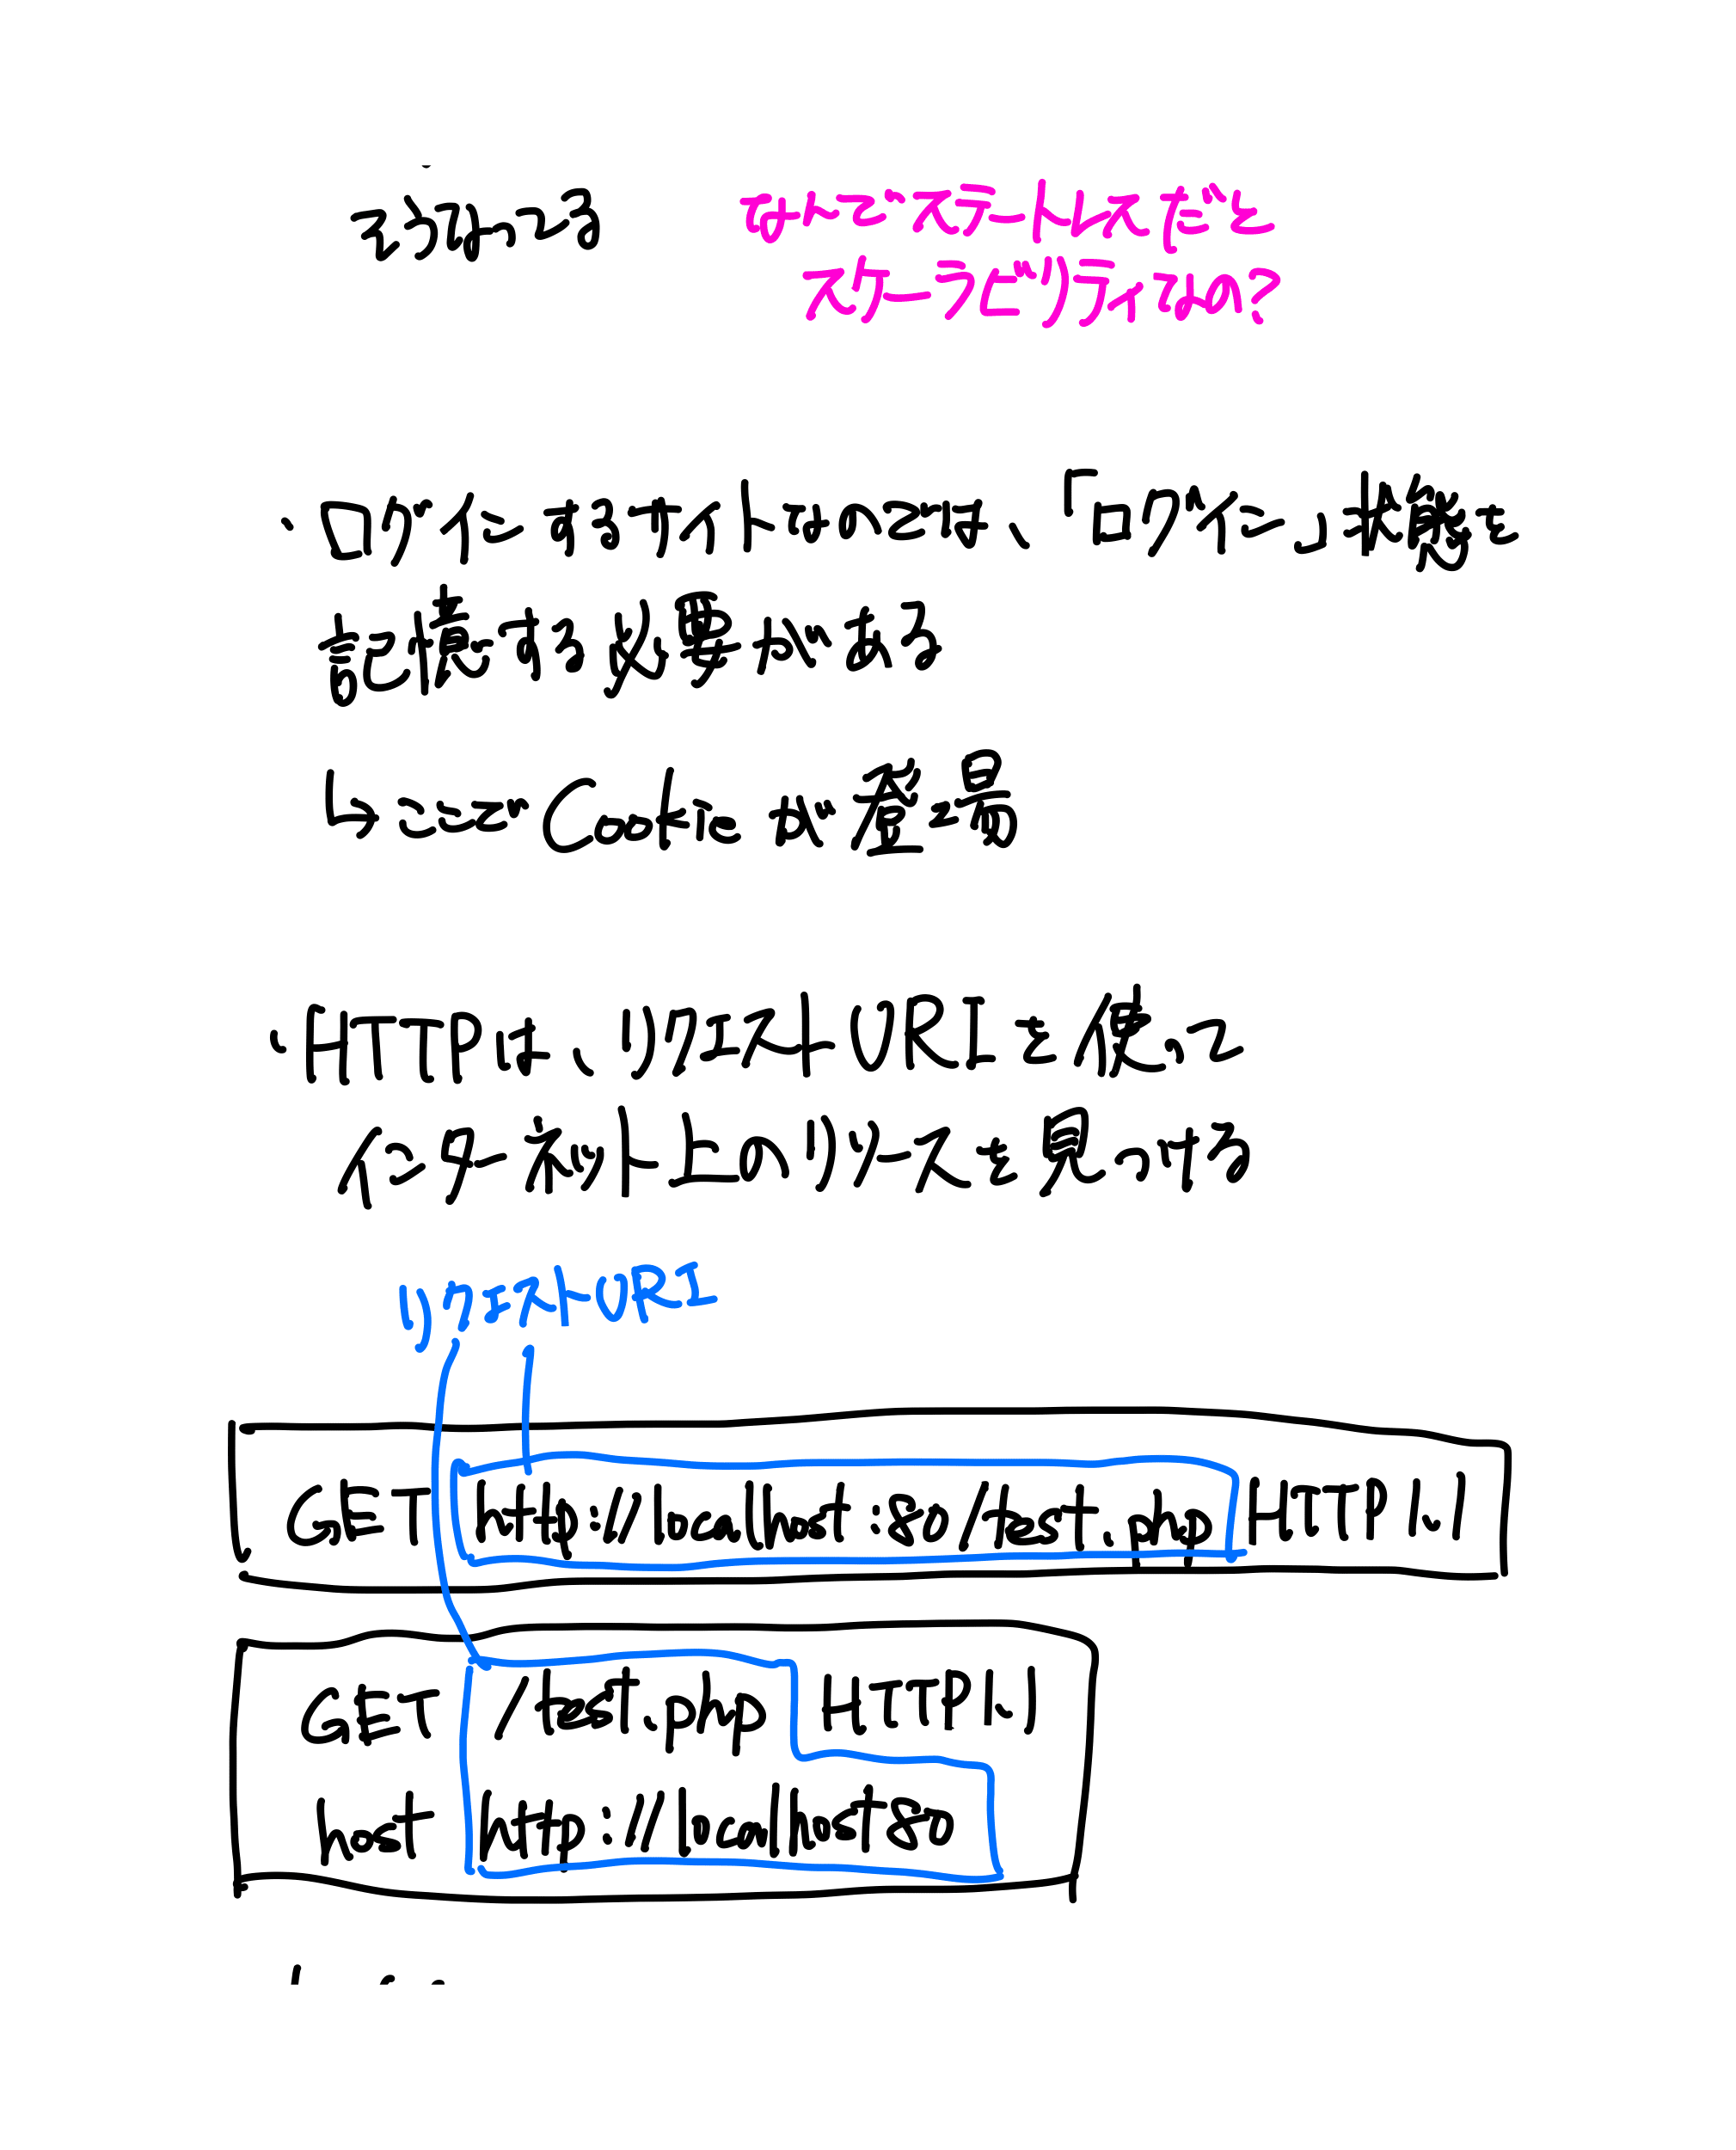
- HTTPは状態を保持しないステートレスなプロトコル。以前の req、res については一切記憶しない → 多くの情報をスケーラブルに処理するため。
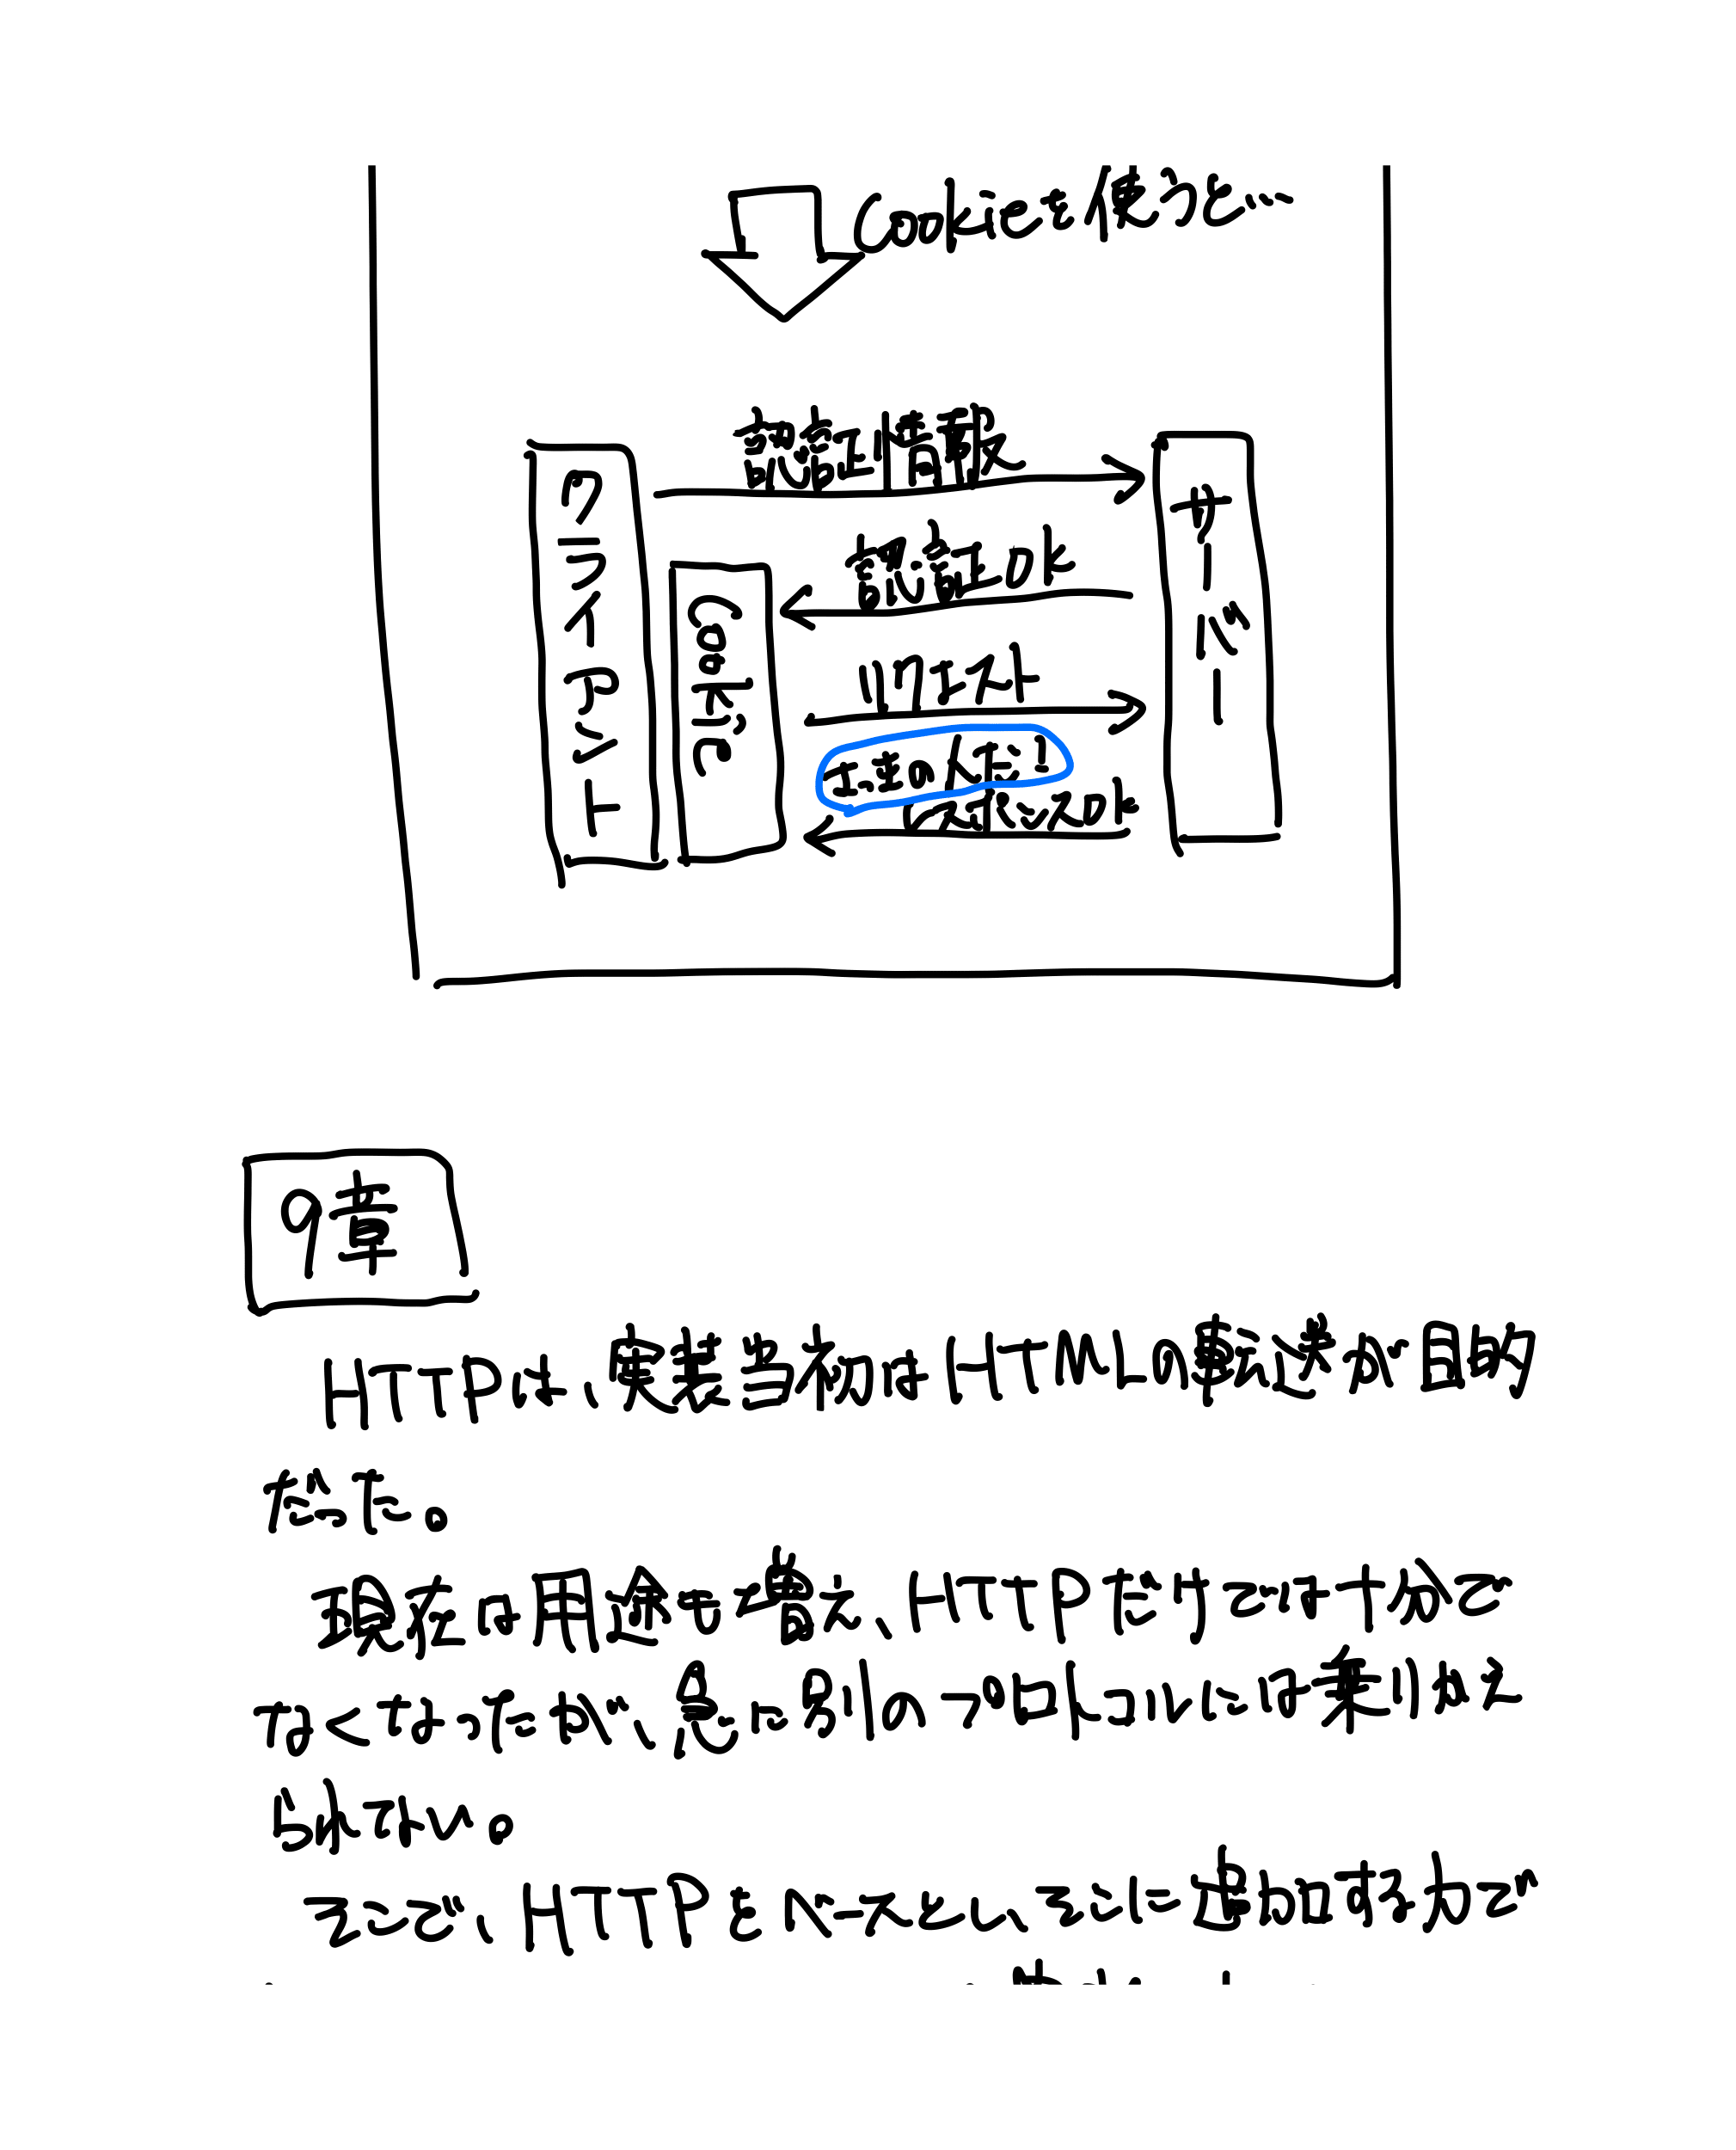
- ログインするサイトなどでは「ログイン」状態を記憶する必要がある → ここで Cookie が登場。
- HTTPは、リクエスト URI を使ってインターネット上のリソースを見つける。
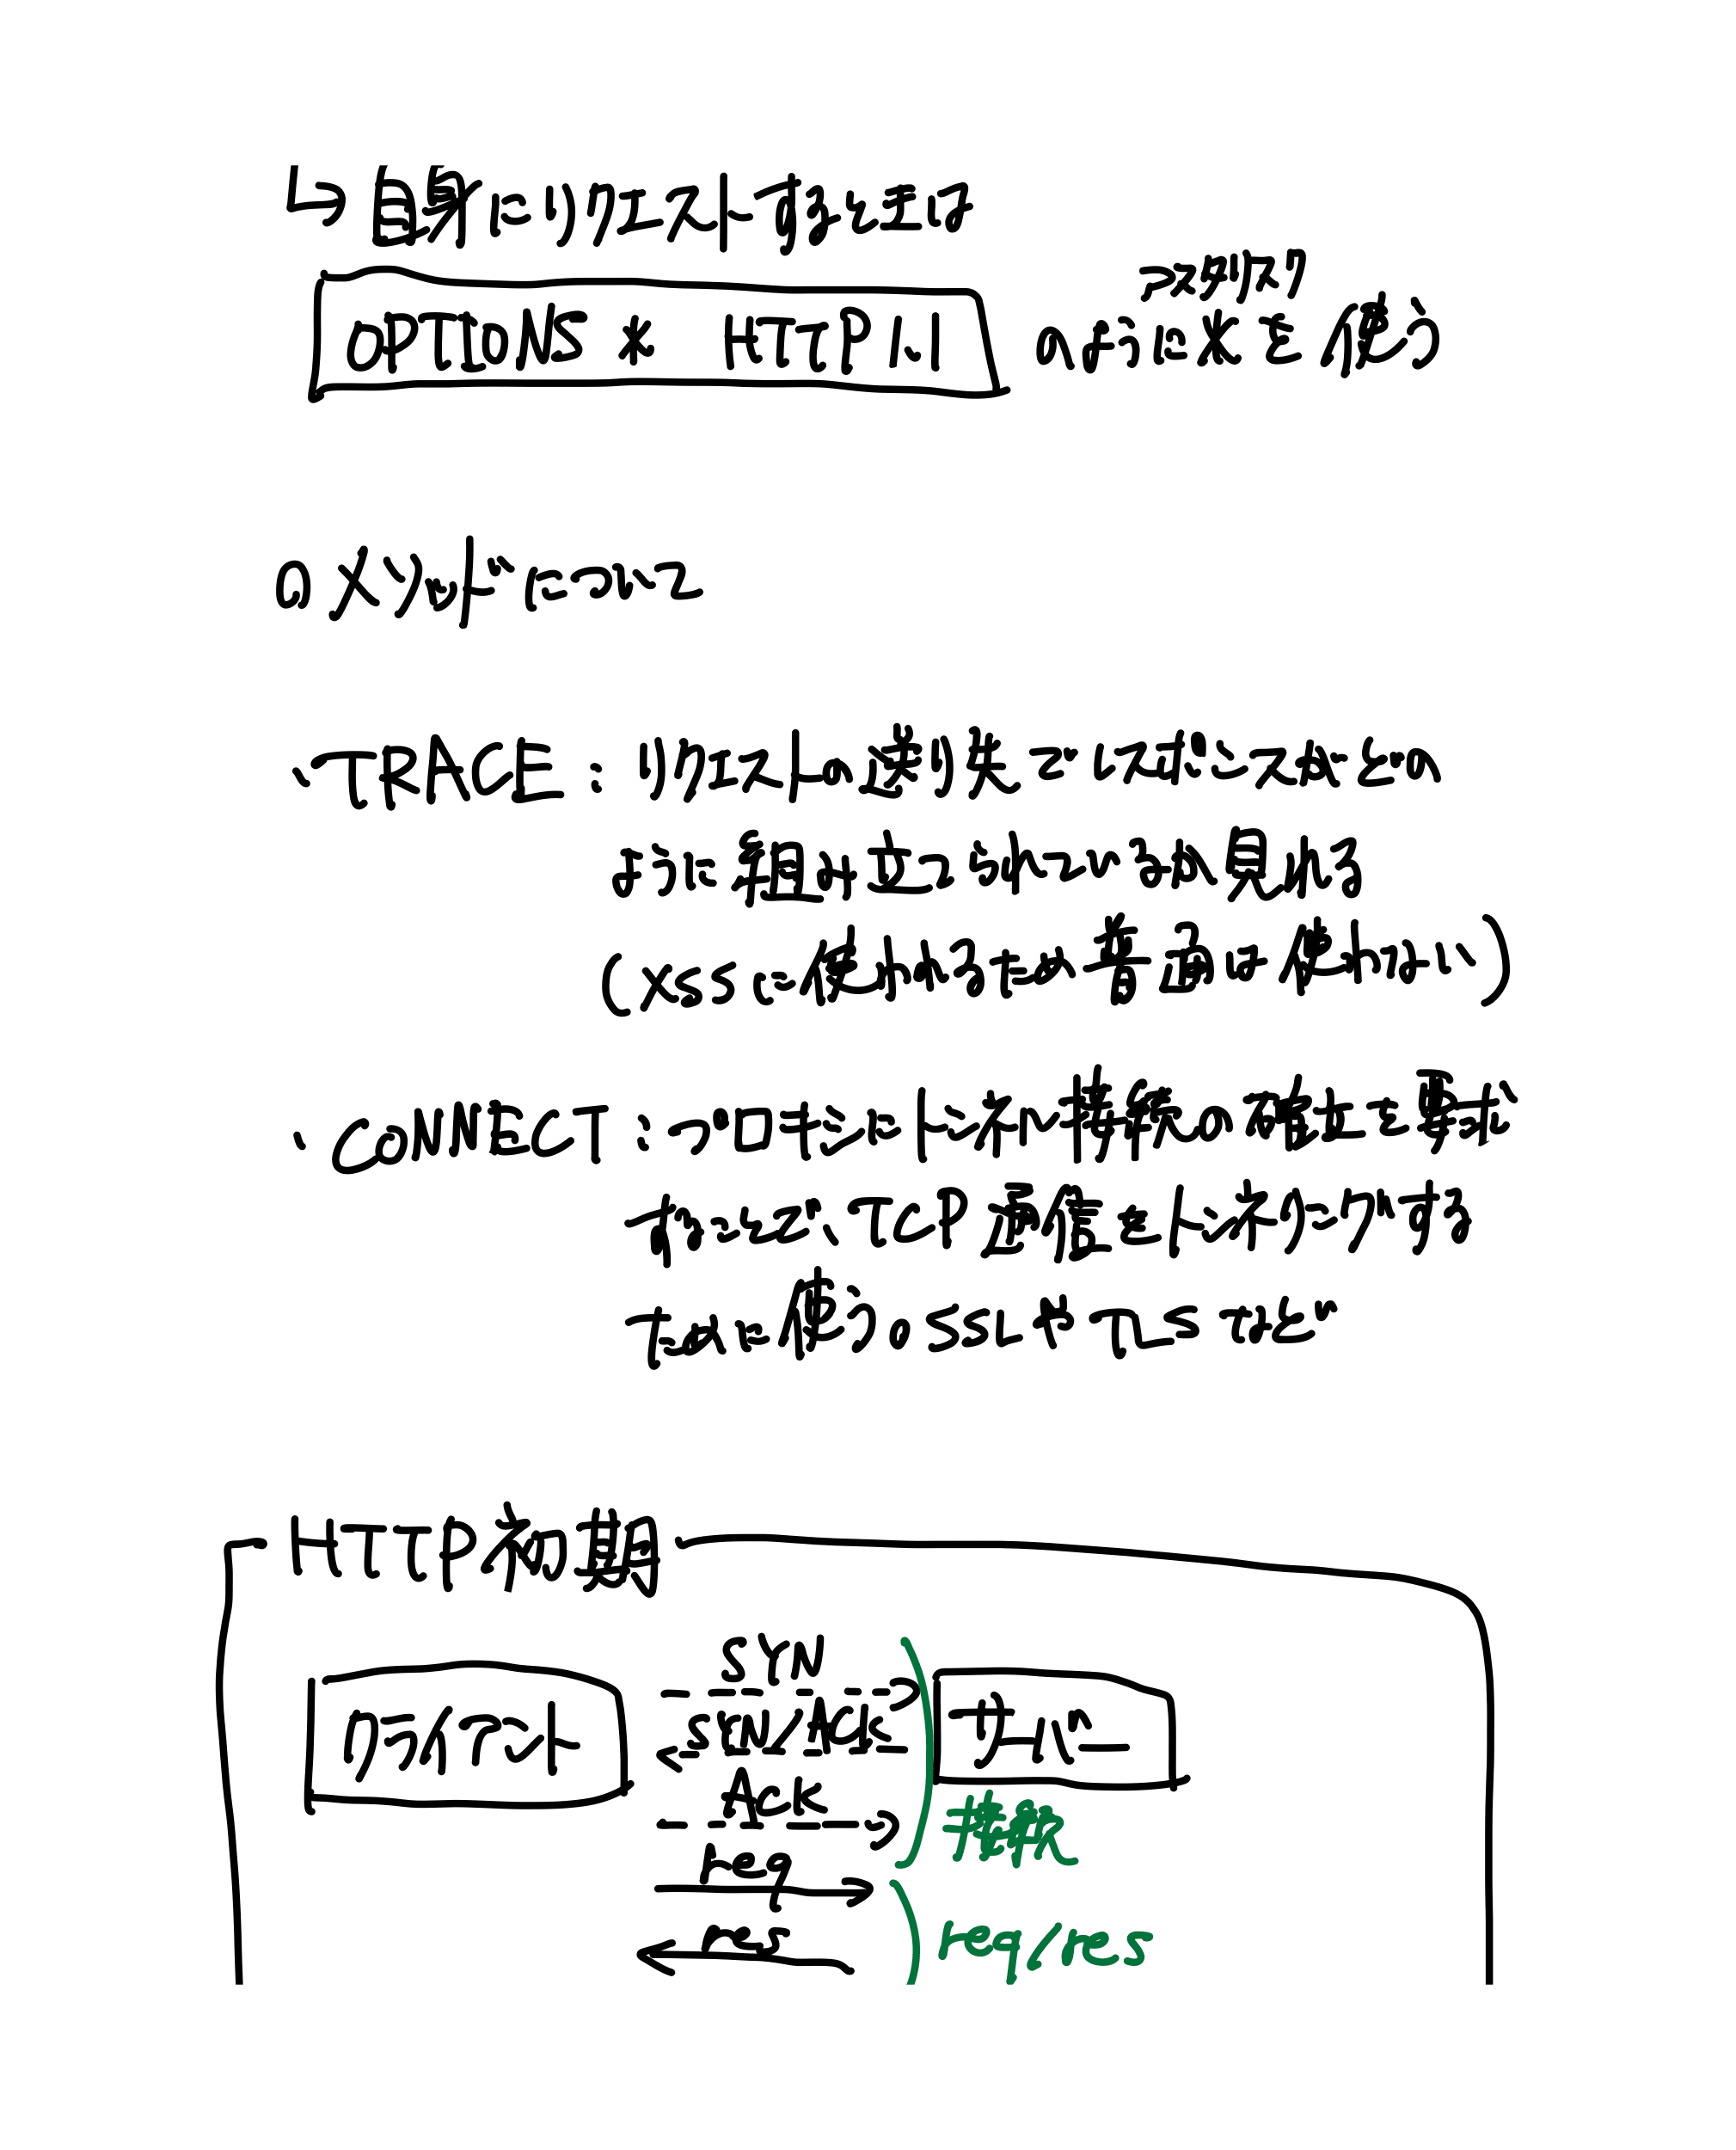
GET http://localhost:80/test.php HTTP1.1GET /test.php HTTP1.1(Host: http://localhost:80)- 自身にリクエストするときは
OPTIONS * HTTP1.1のように *(アスタリスク)を使う。
メソッドについて
- TRACE:リクエストの送り先でレスポンスがどのように組み立てられているか見れる(XSSに使われるため普通は使わない)。
- CONNECT:プロキシにトンネル接続の確立を要求し、TCP通信をトンネリングするために使う(SSLやTLSなど)。
接続の変遷
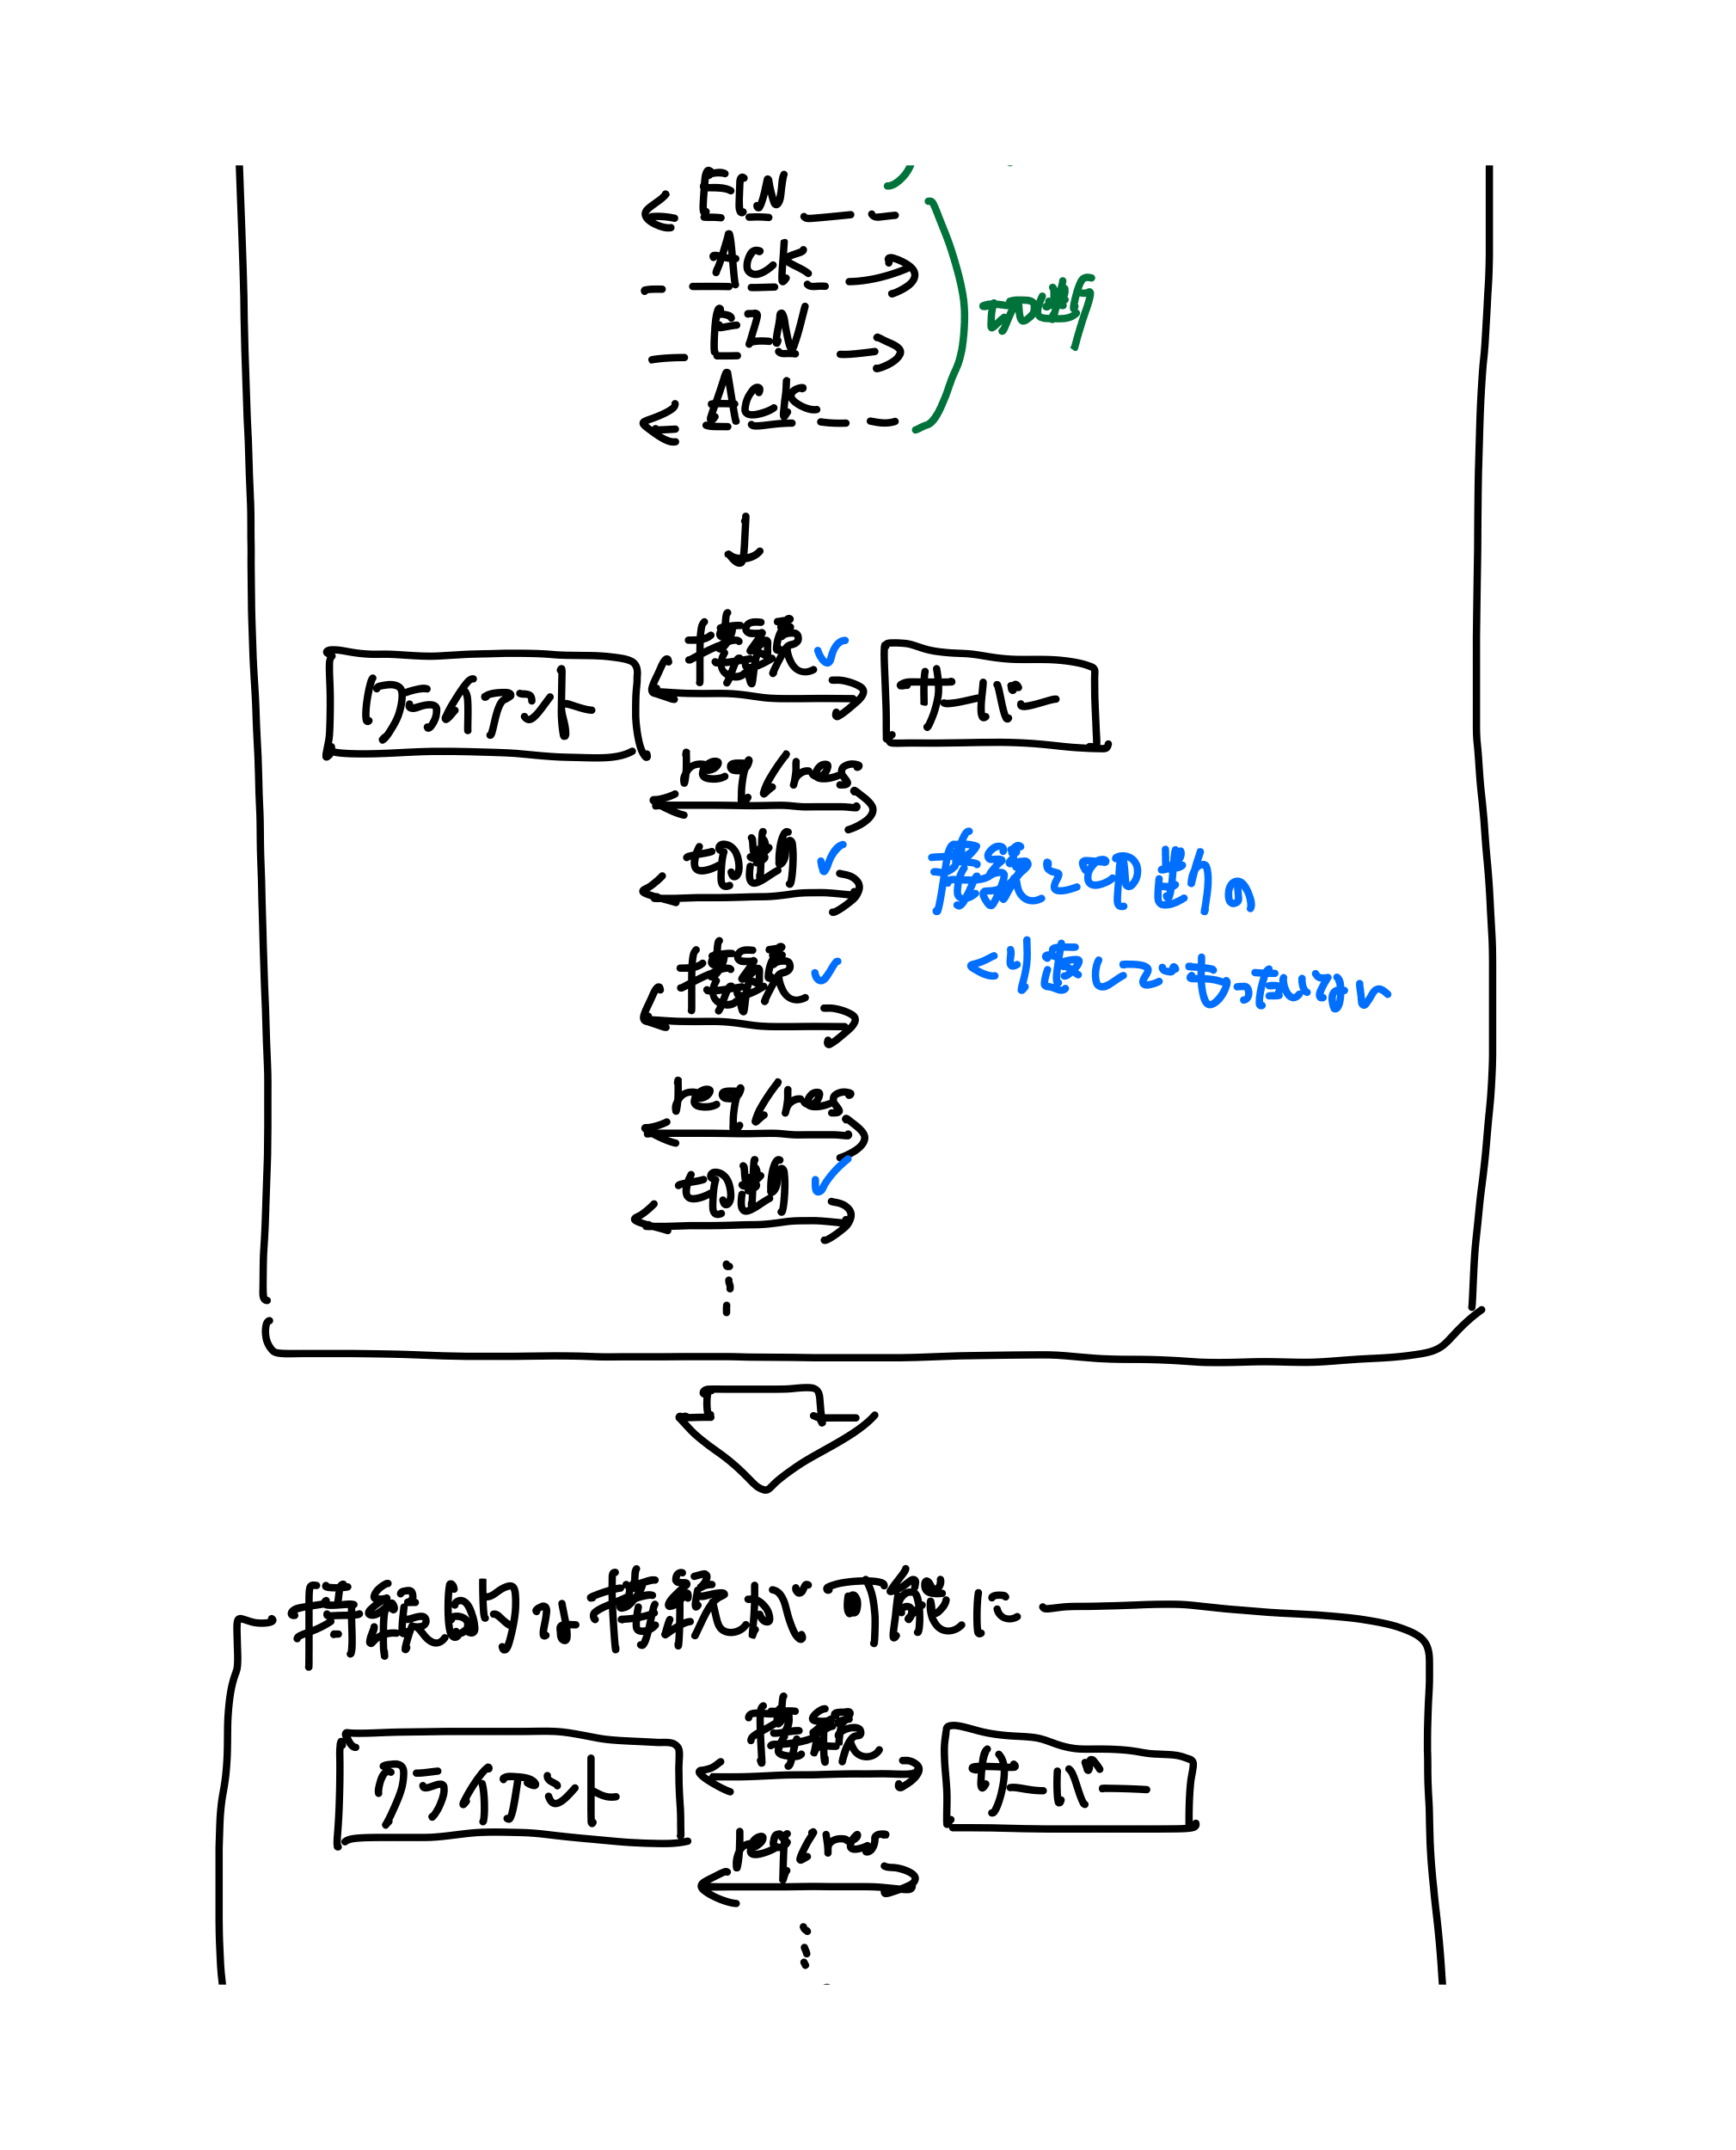
- HTTP初期:接続(SYN → SYN/ACK → ACK)→ req/res → 切断(FIN → ACK → FIN → ACK)を毎回くり返す。接続と切断のくりかえしでもったいない。
- 持続的接続:一度つないだ接続を維持して req/res をくり返す。
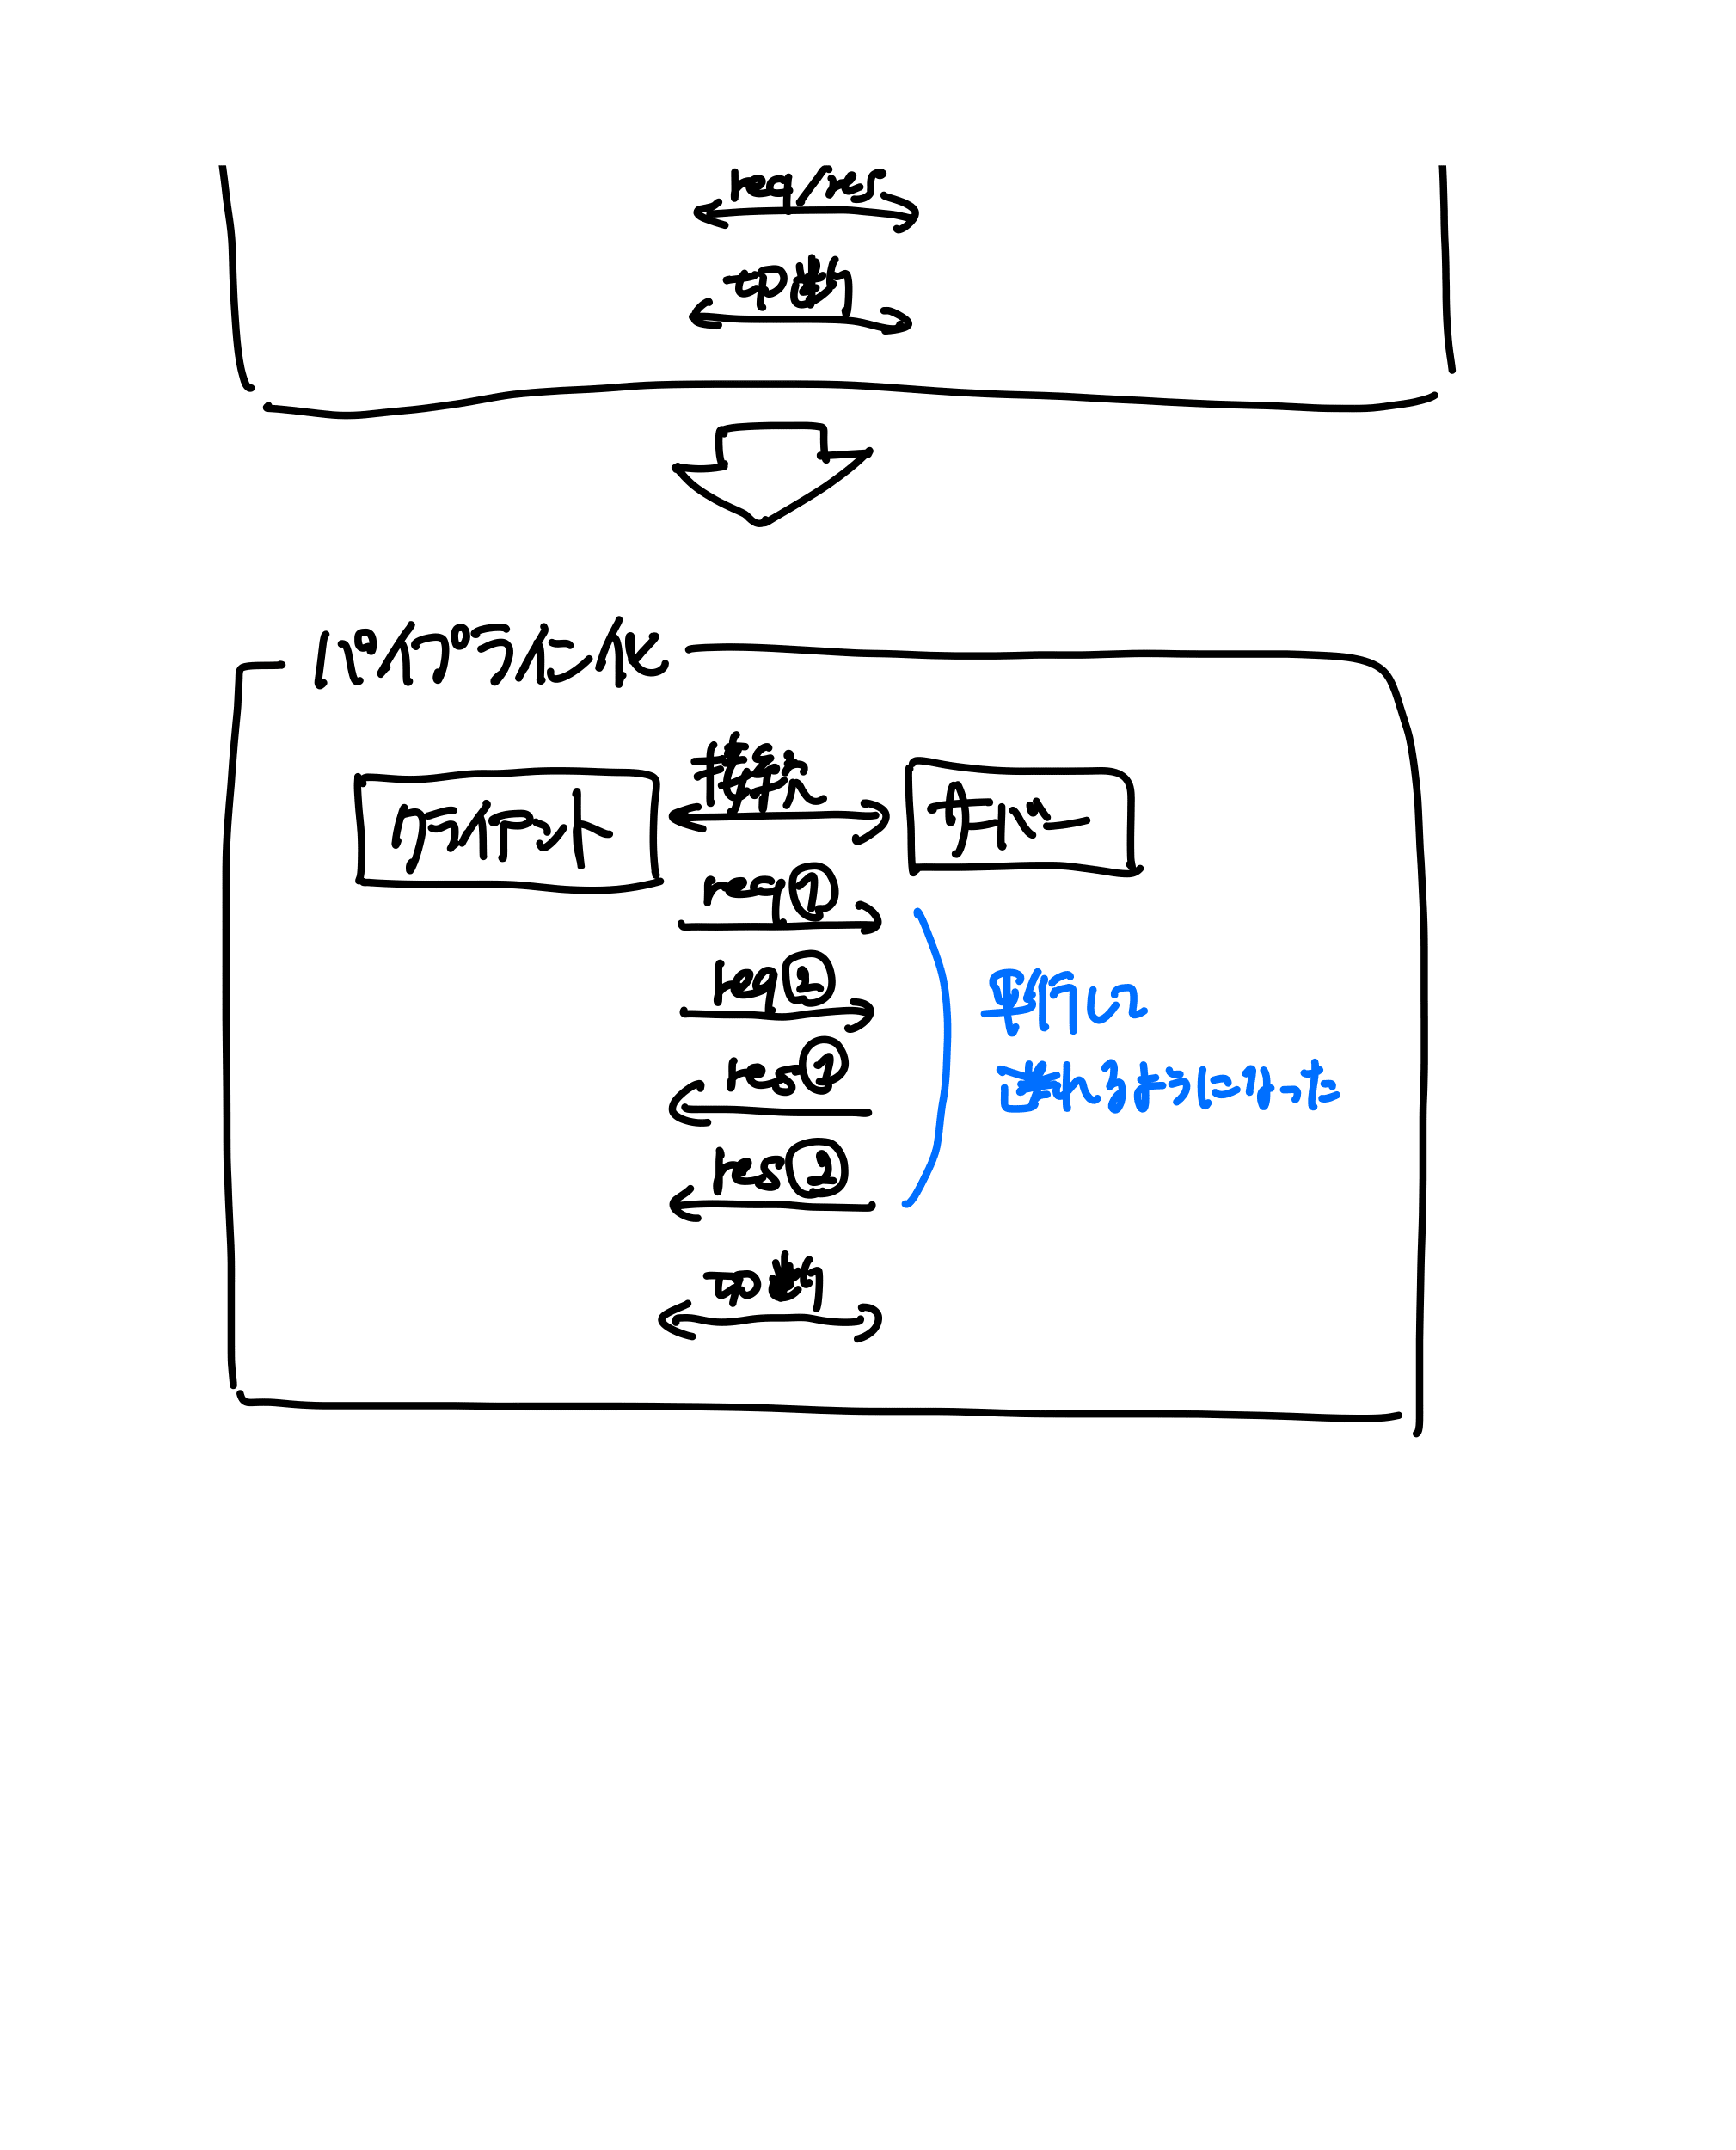
- パイプライン化:req① req② を続けて送り、res① res② を受け取る → 並行して送れるようになった。
3章 HTTPメッセージ
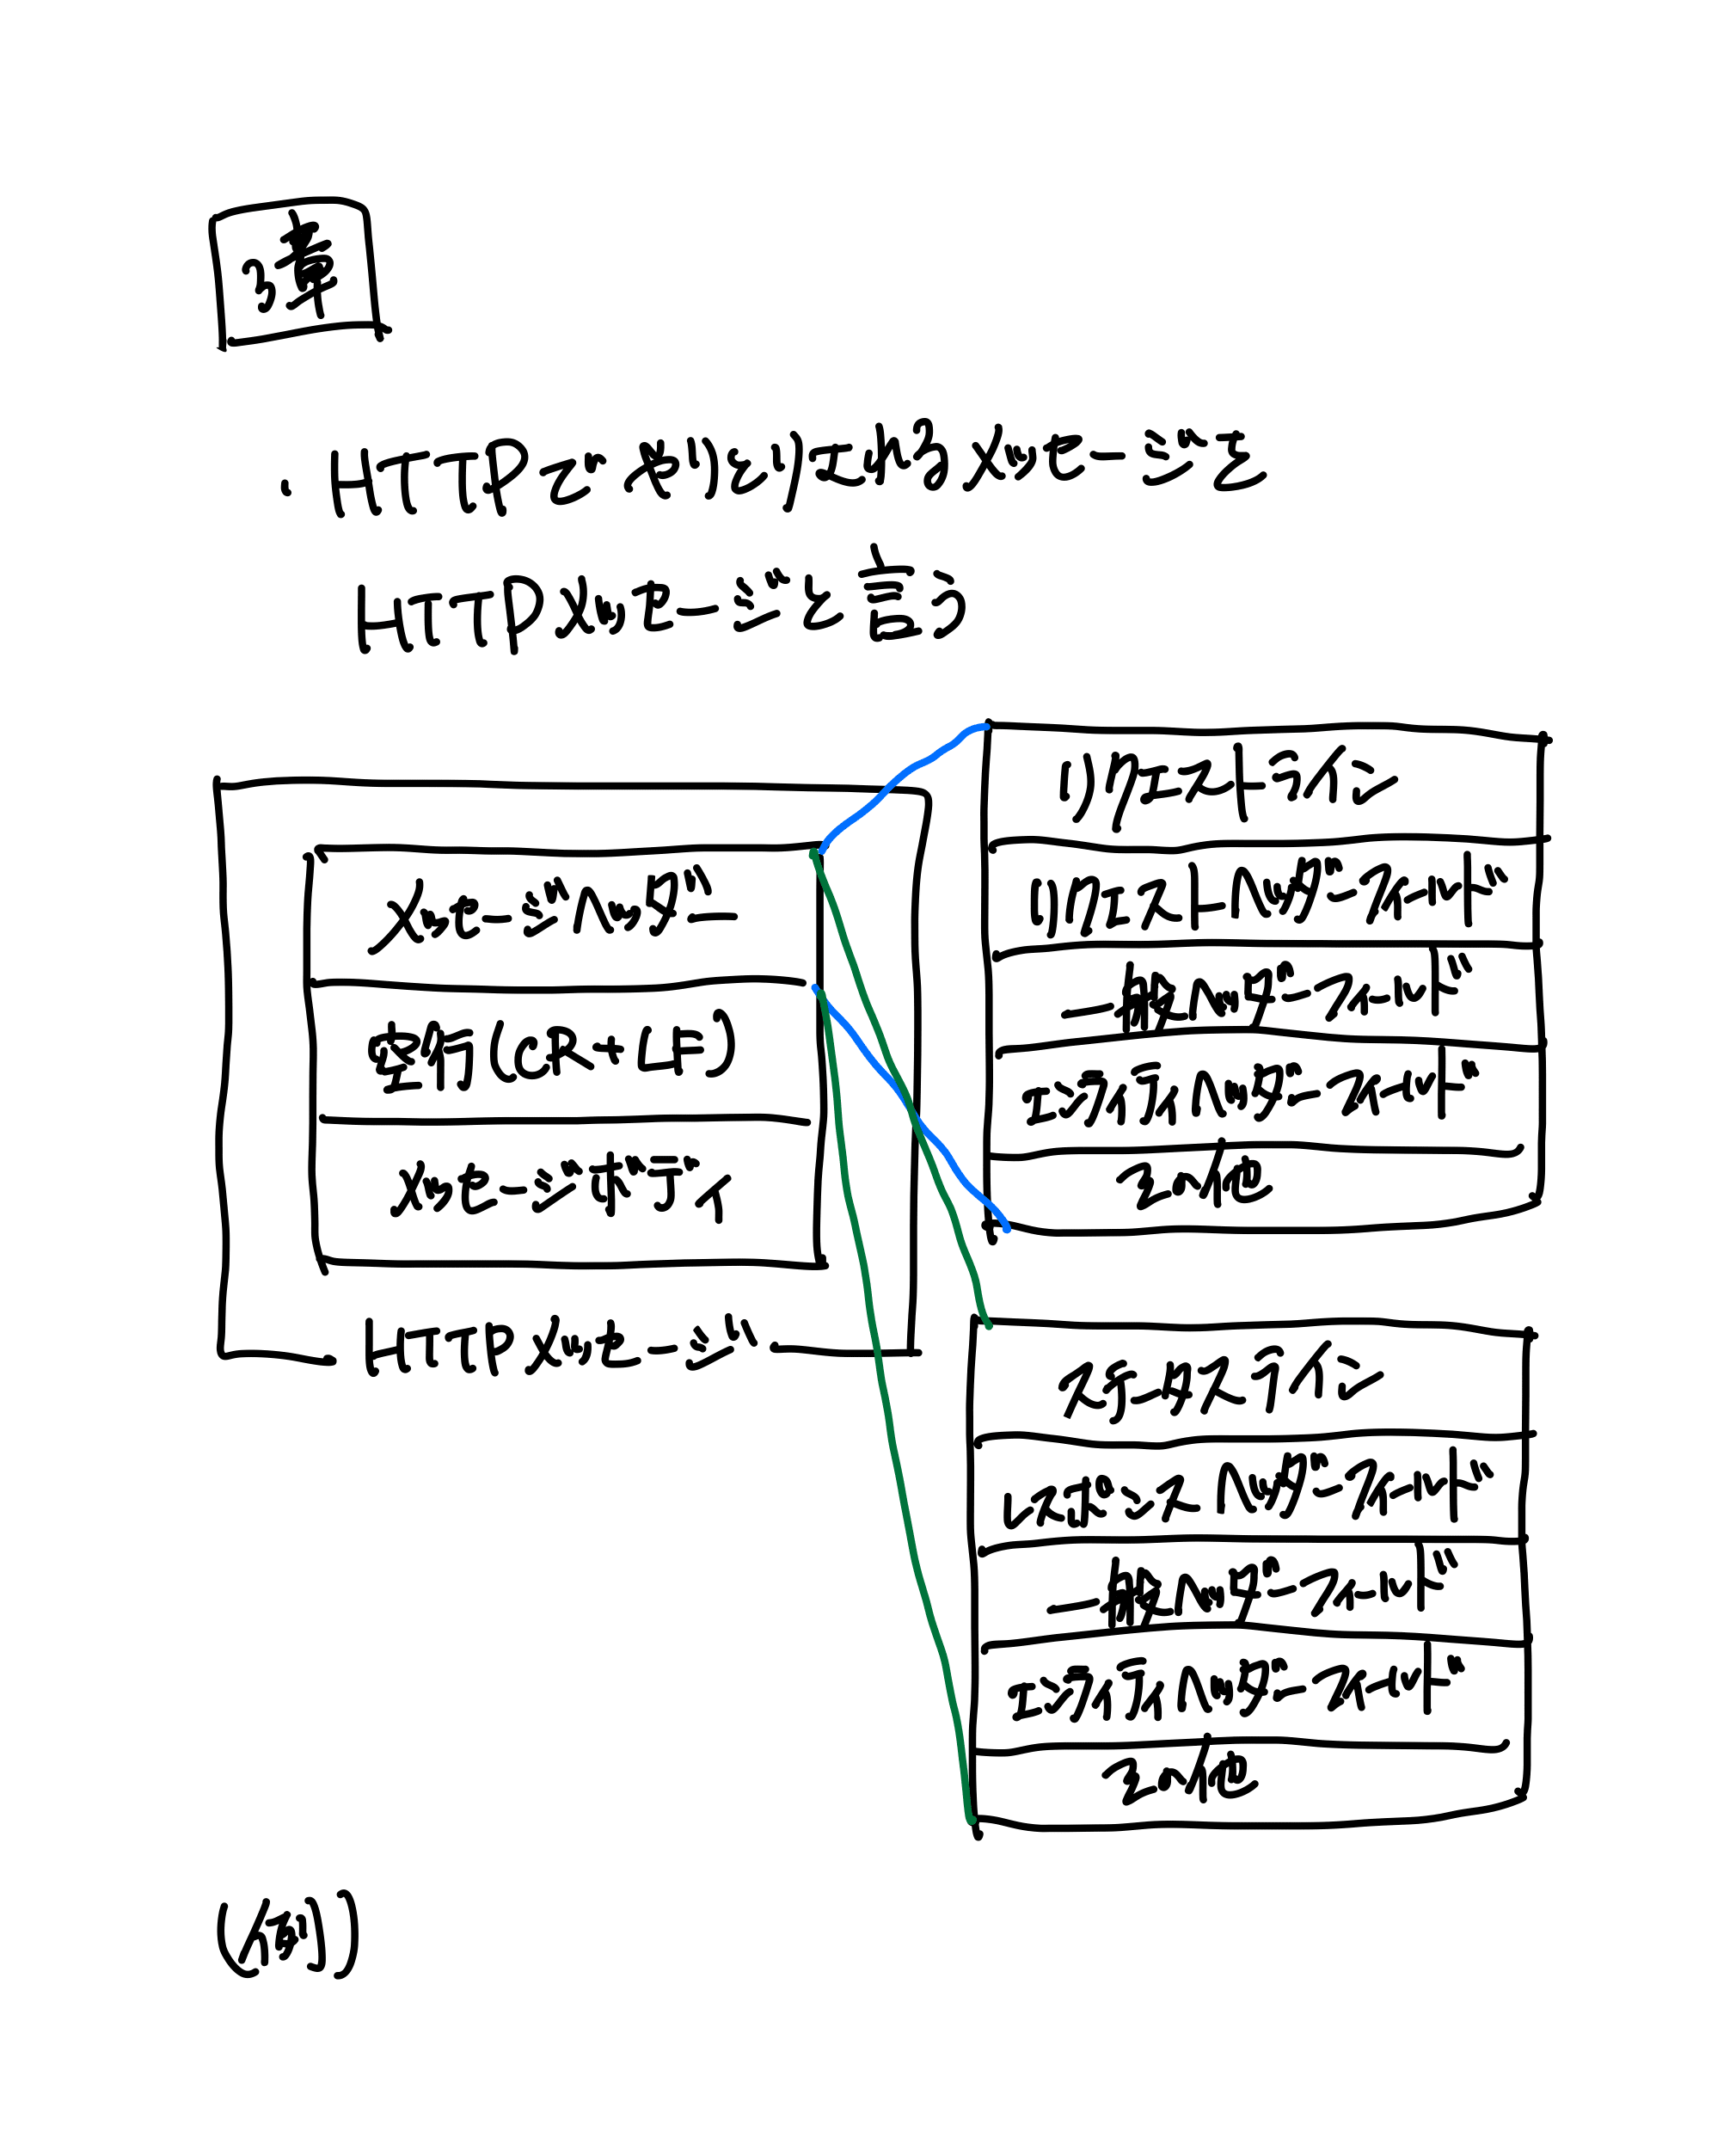
- HTTPでやりとりされるメッセージを HTTPメッセージと言う。
- 構成:メッセージヘッダー / 空行(CR + LF)/ メッセージボディ。
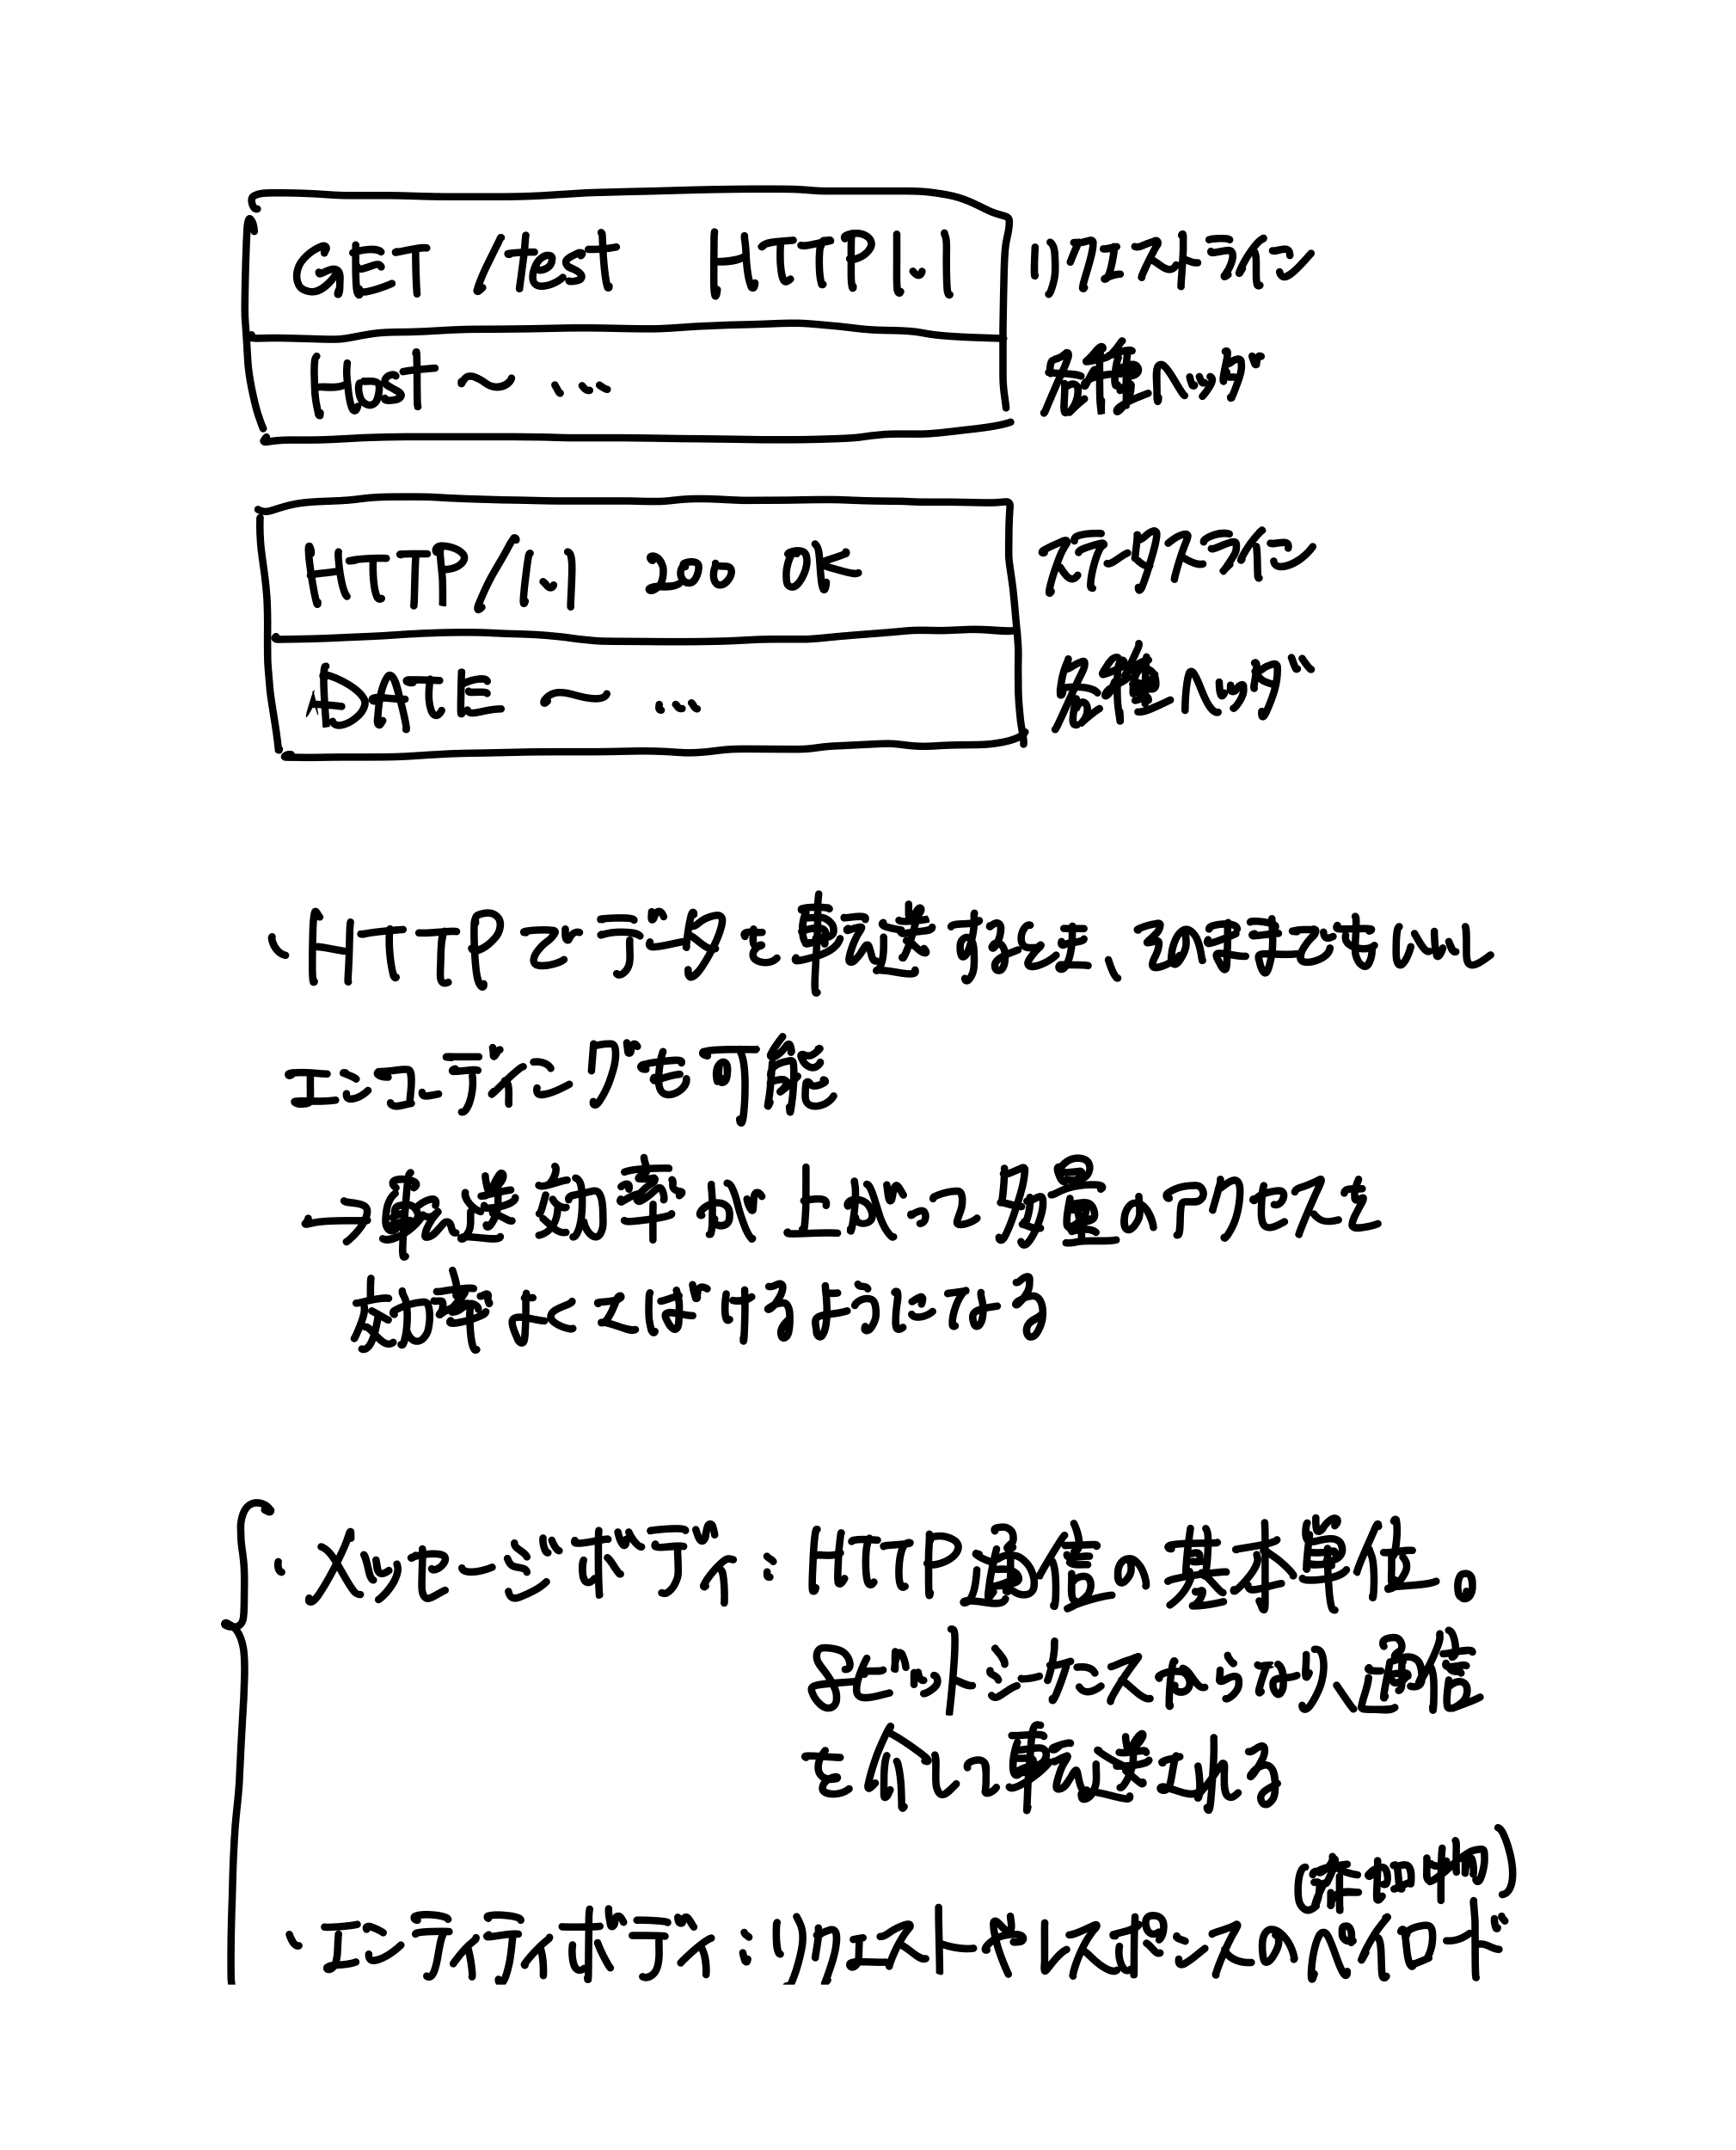
- リクエスト:リクエストライン + 各種ヘッダーフィールド(リクエスト/一般/エンティティ 等)
- レスポンス:ステータスライン + 各種ヘッダーフィールド(レスポンス/一般/エンティティ 等)
- HTTPでデータを転送するとき、そのままでもエンコーディングも可能 → 転送効率が上がり多量のアクセスを効率よくさばける。
- メッセージボディ:HTTP通信の基本単位。8ビットシーケンスからなり、通信を介して転送される。
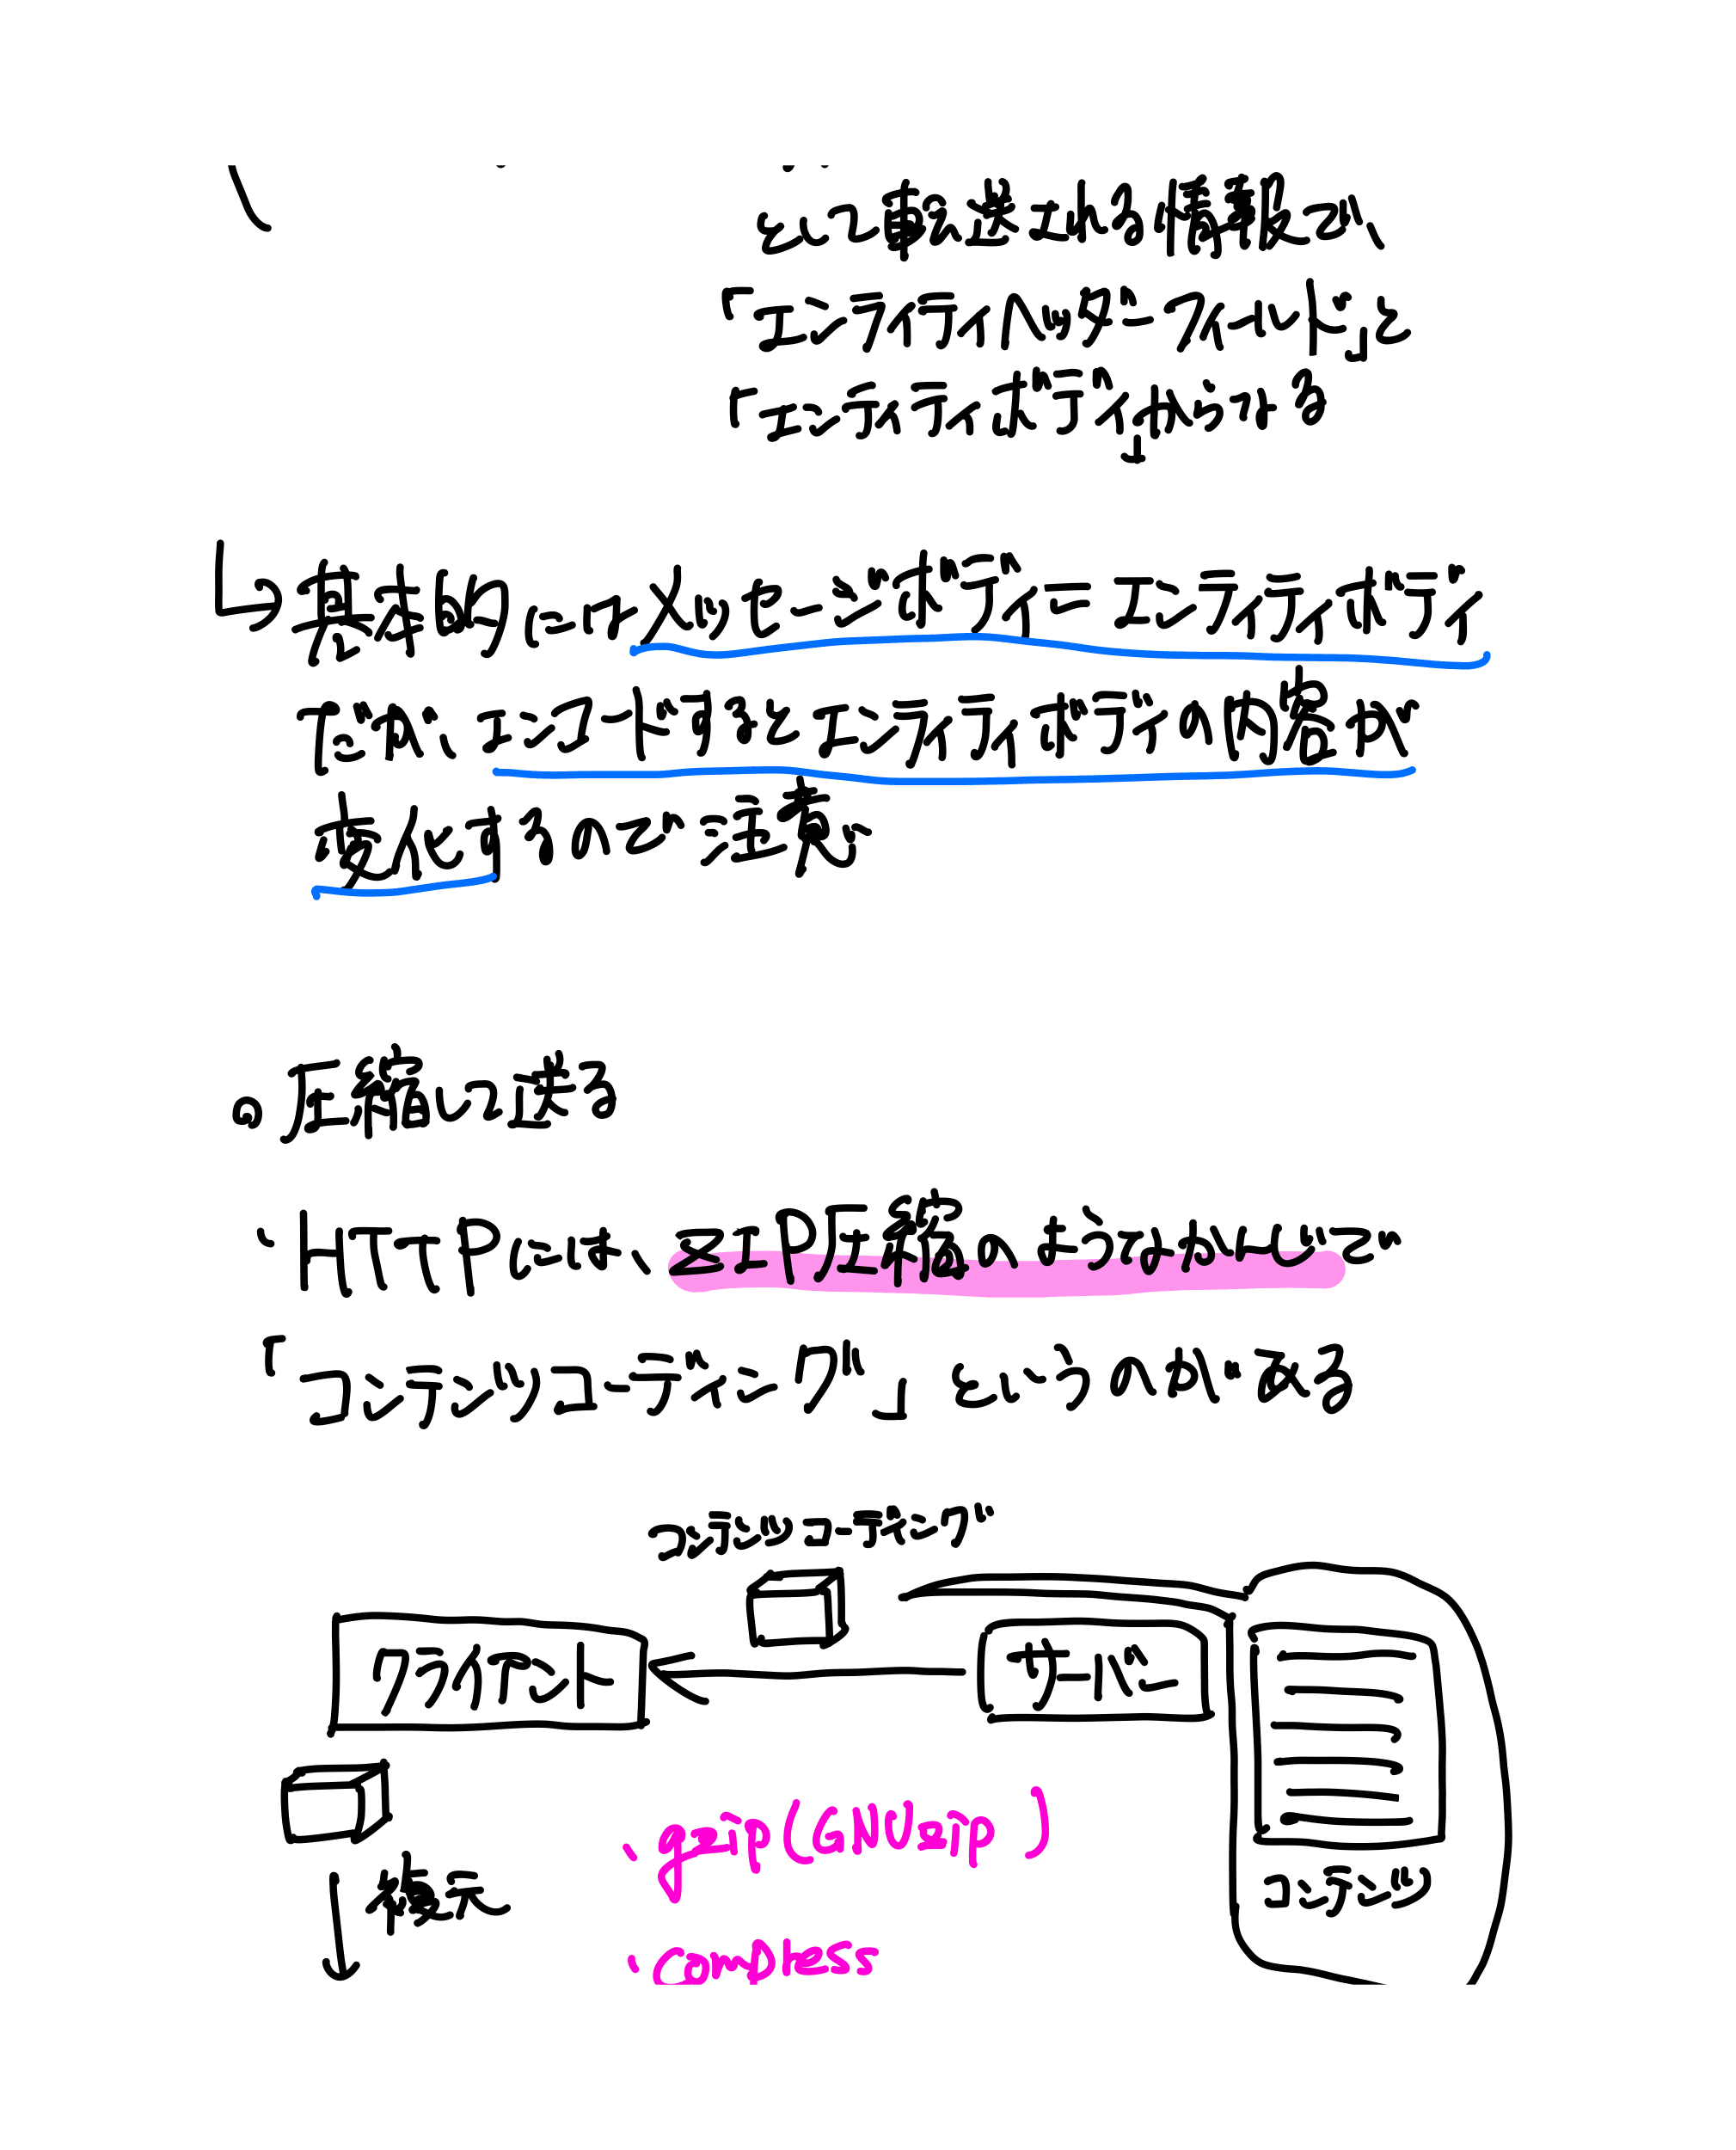
- エンティティボディ:リクエストやレスポンスのペイロード(積荷)。「エンティティヘッダーフィールド」と「エンティティボディ」からなる。基本的にメッセージボディ = エンティティボディだが、エンコードすると内容が変化するので注意。
圧縮して送る(コンテンツコーディング)
- HTTPには、ZIP圧縮のような「コンテンツコーディング」がある。サーバーで変換 → クライアントで復元。
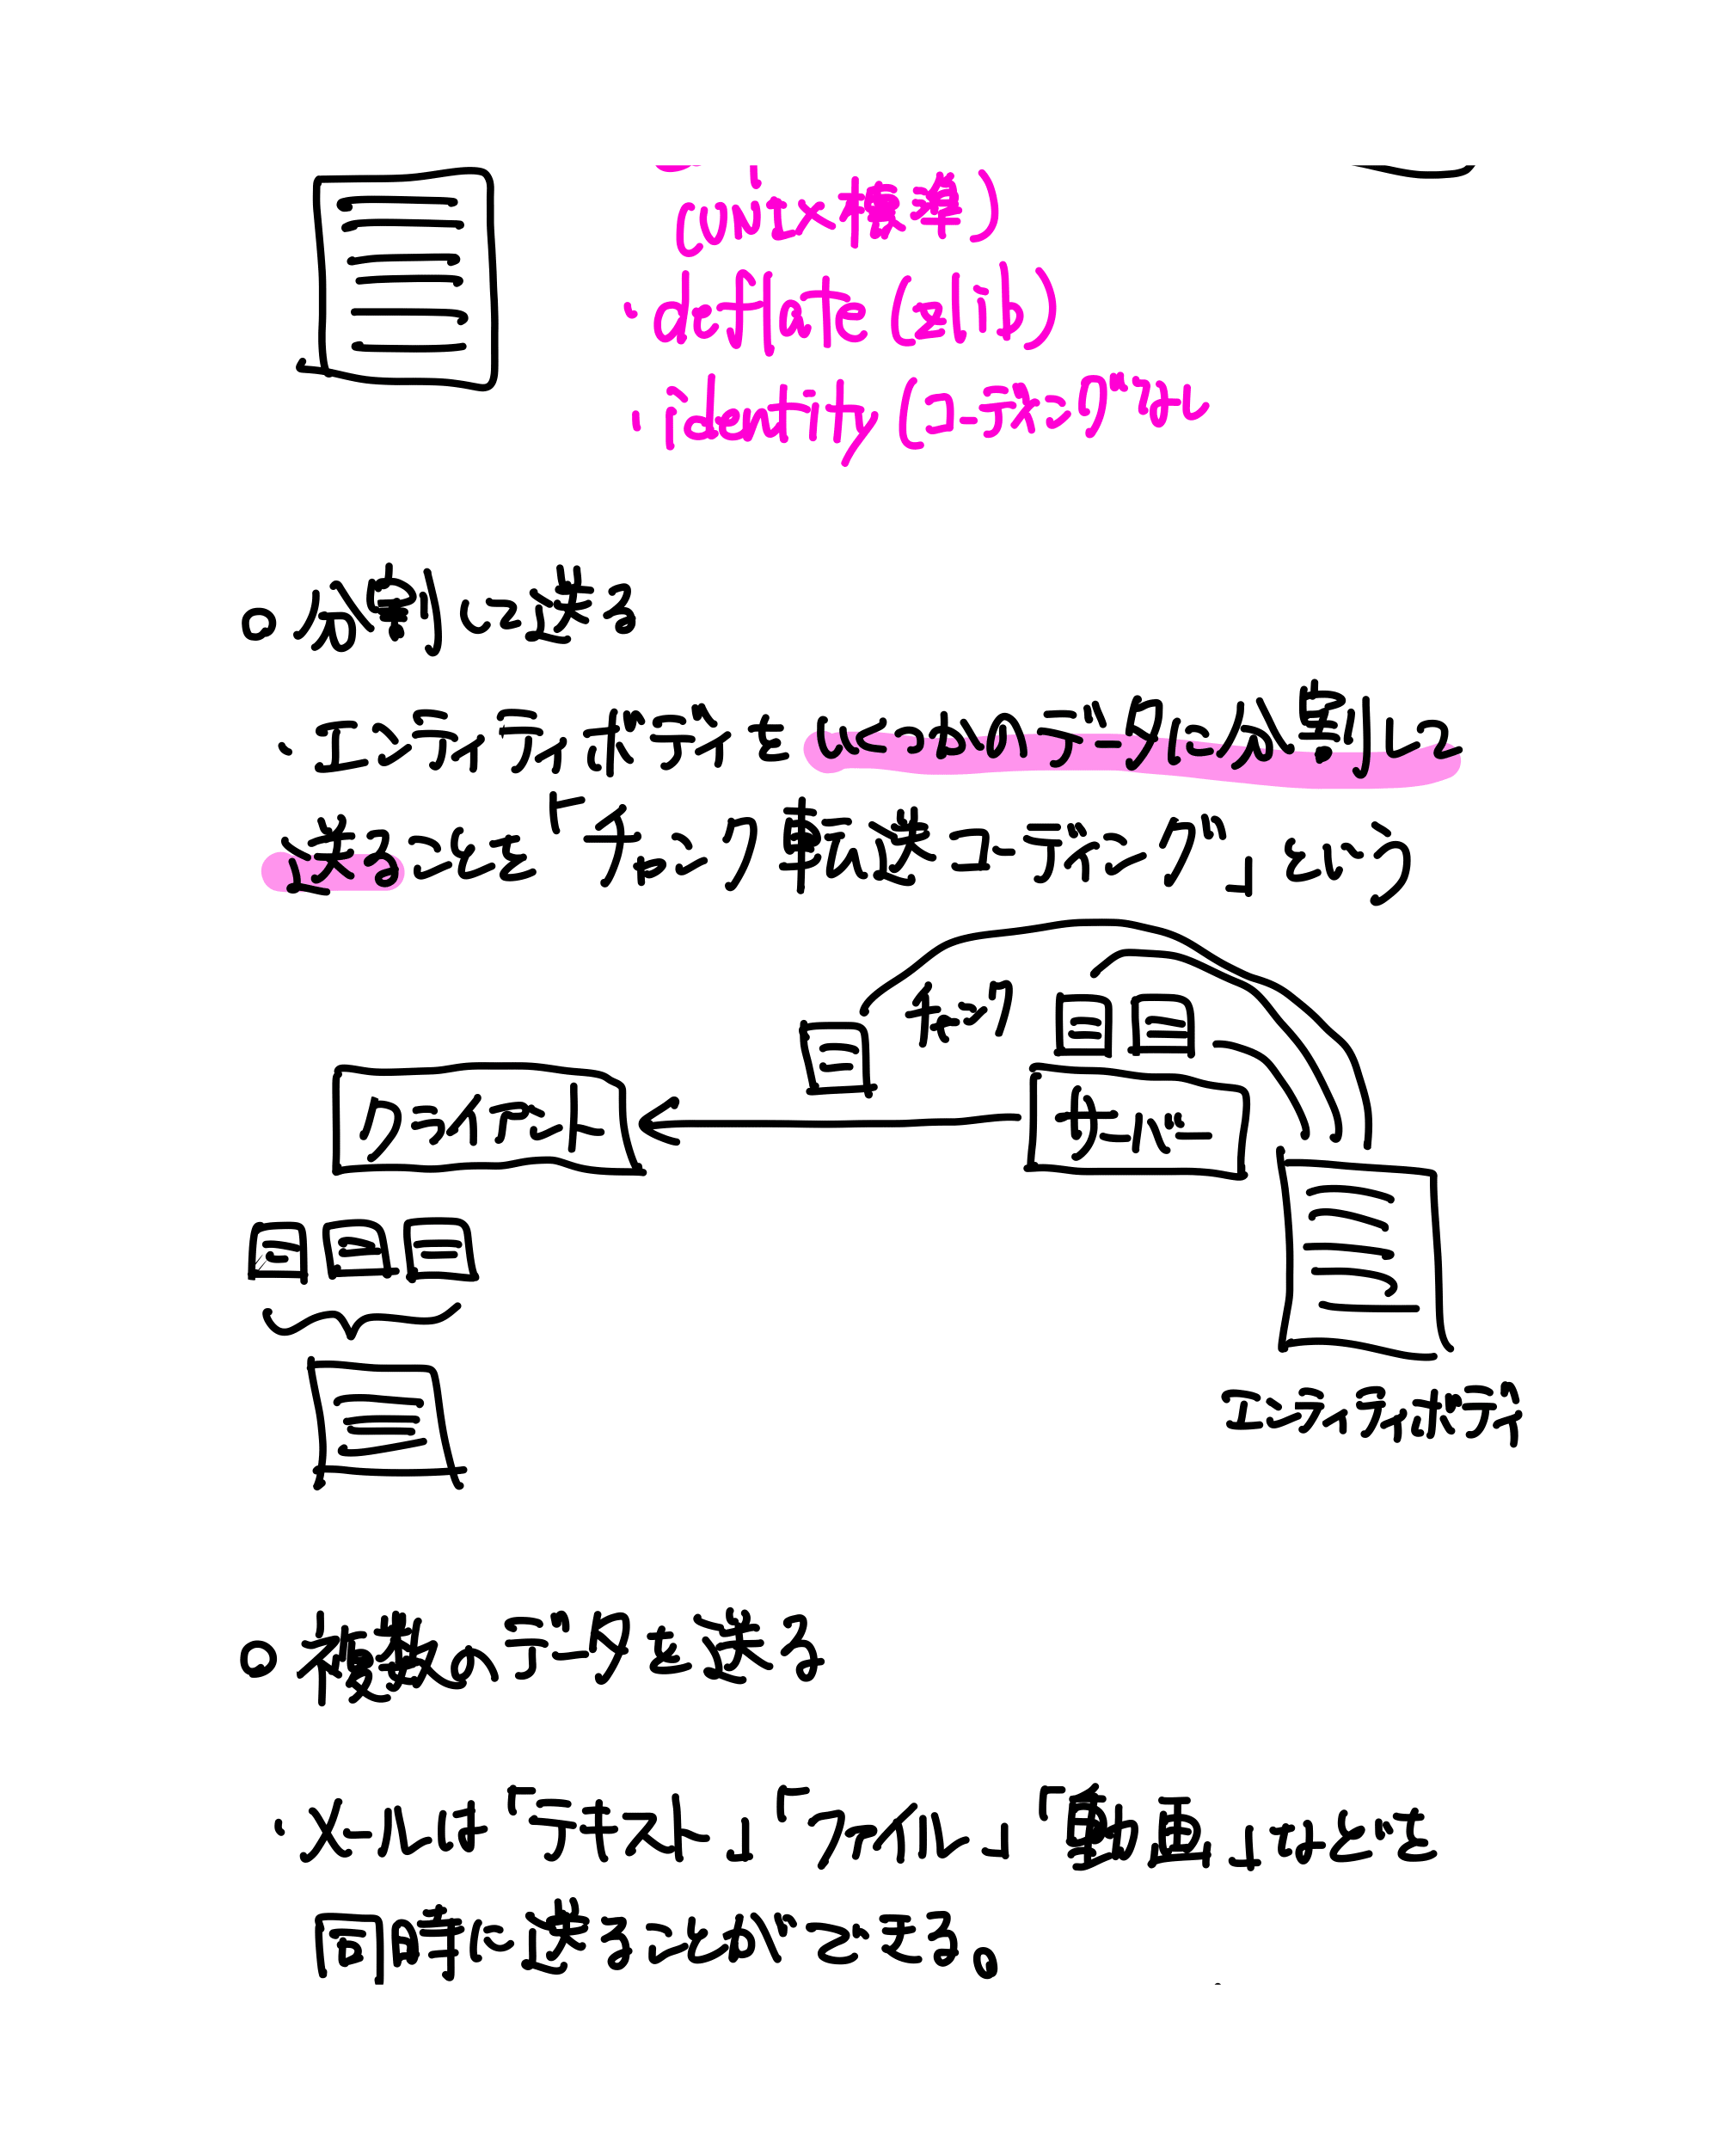
- gzip(GNU zip)/ compress(UNIX標準)/ deflate(zlib)/ identity(コーディングなし)。
分割して送る(チャンク転送コーディング)
- エンティティボディをいくつかに分割して送ることを「チャンク転送コーディング」という。
複数のデータを送る(multipart)
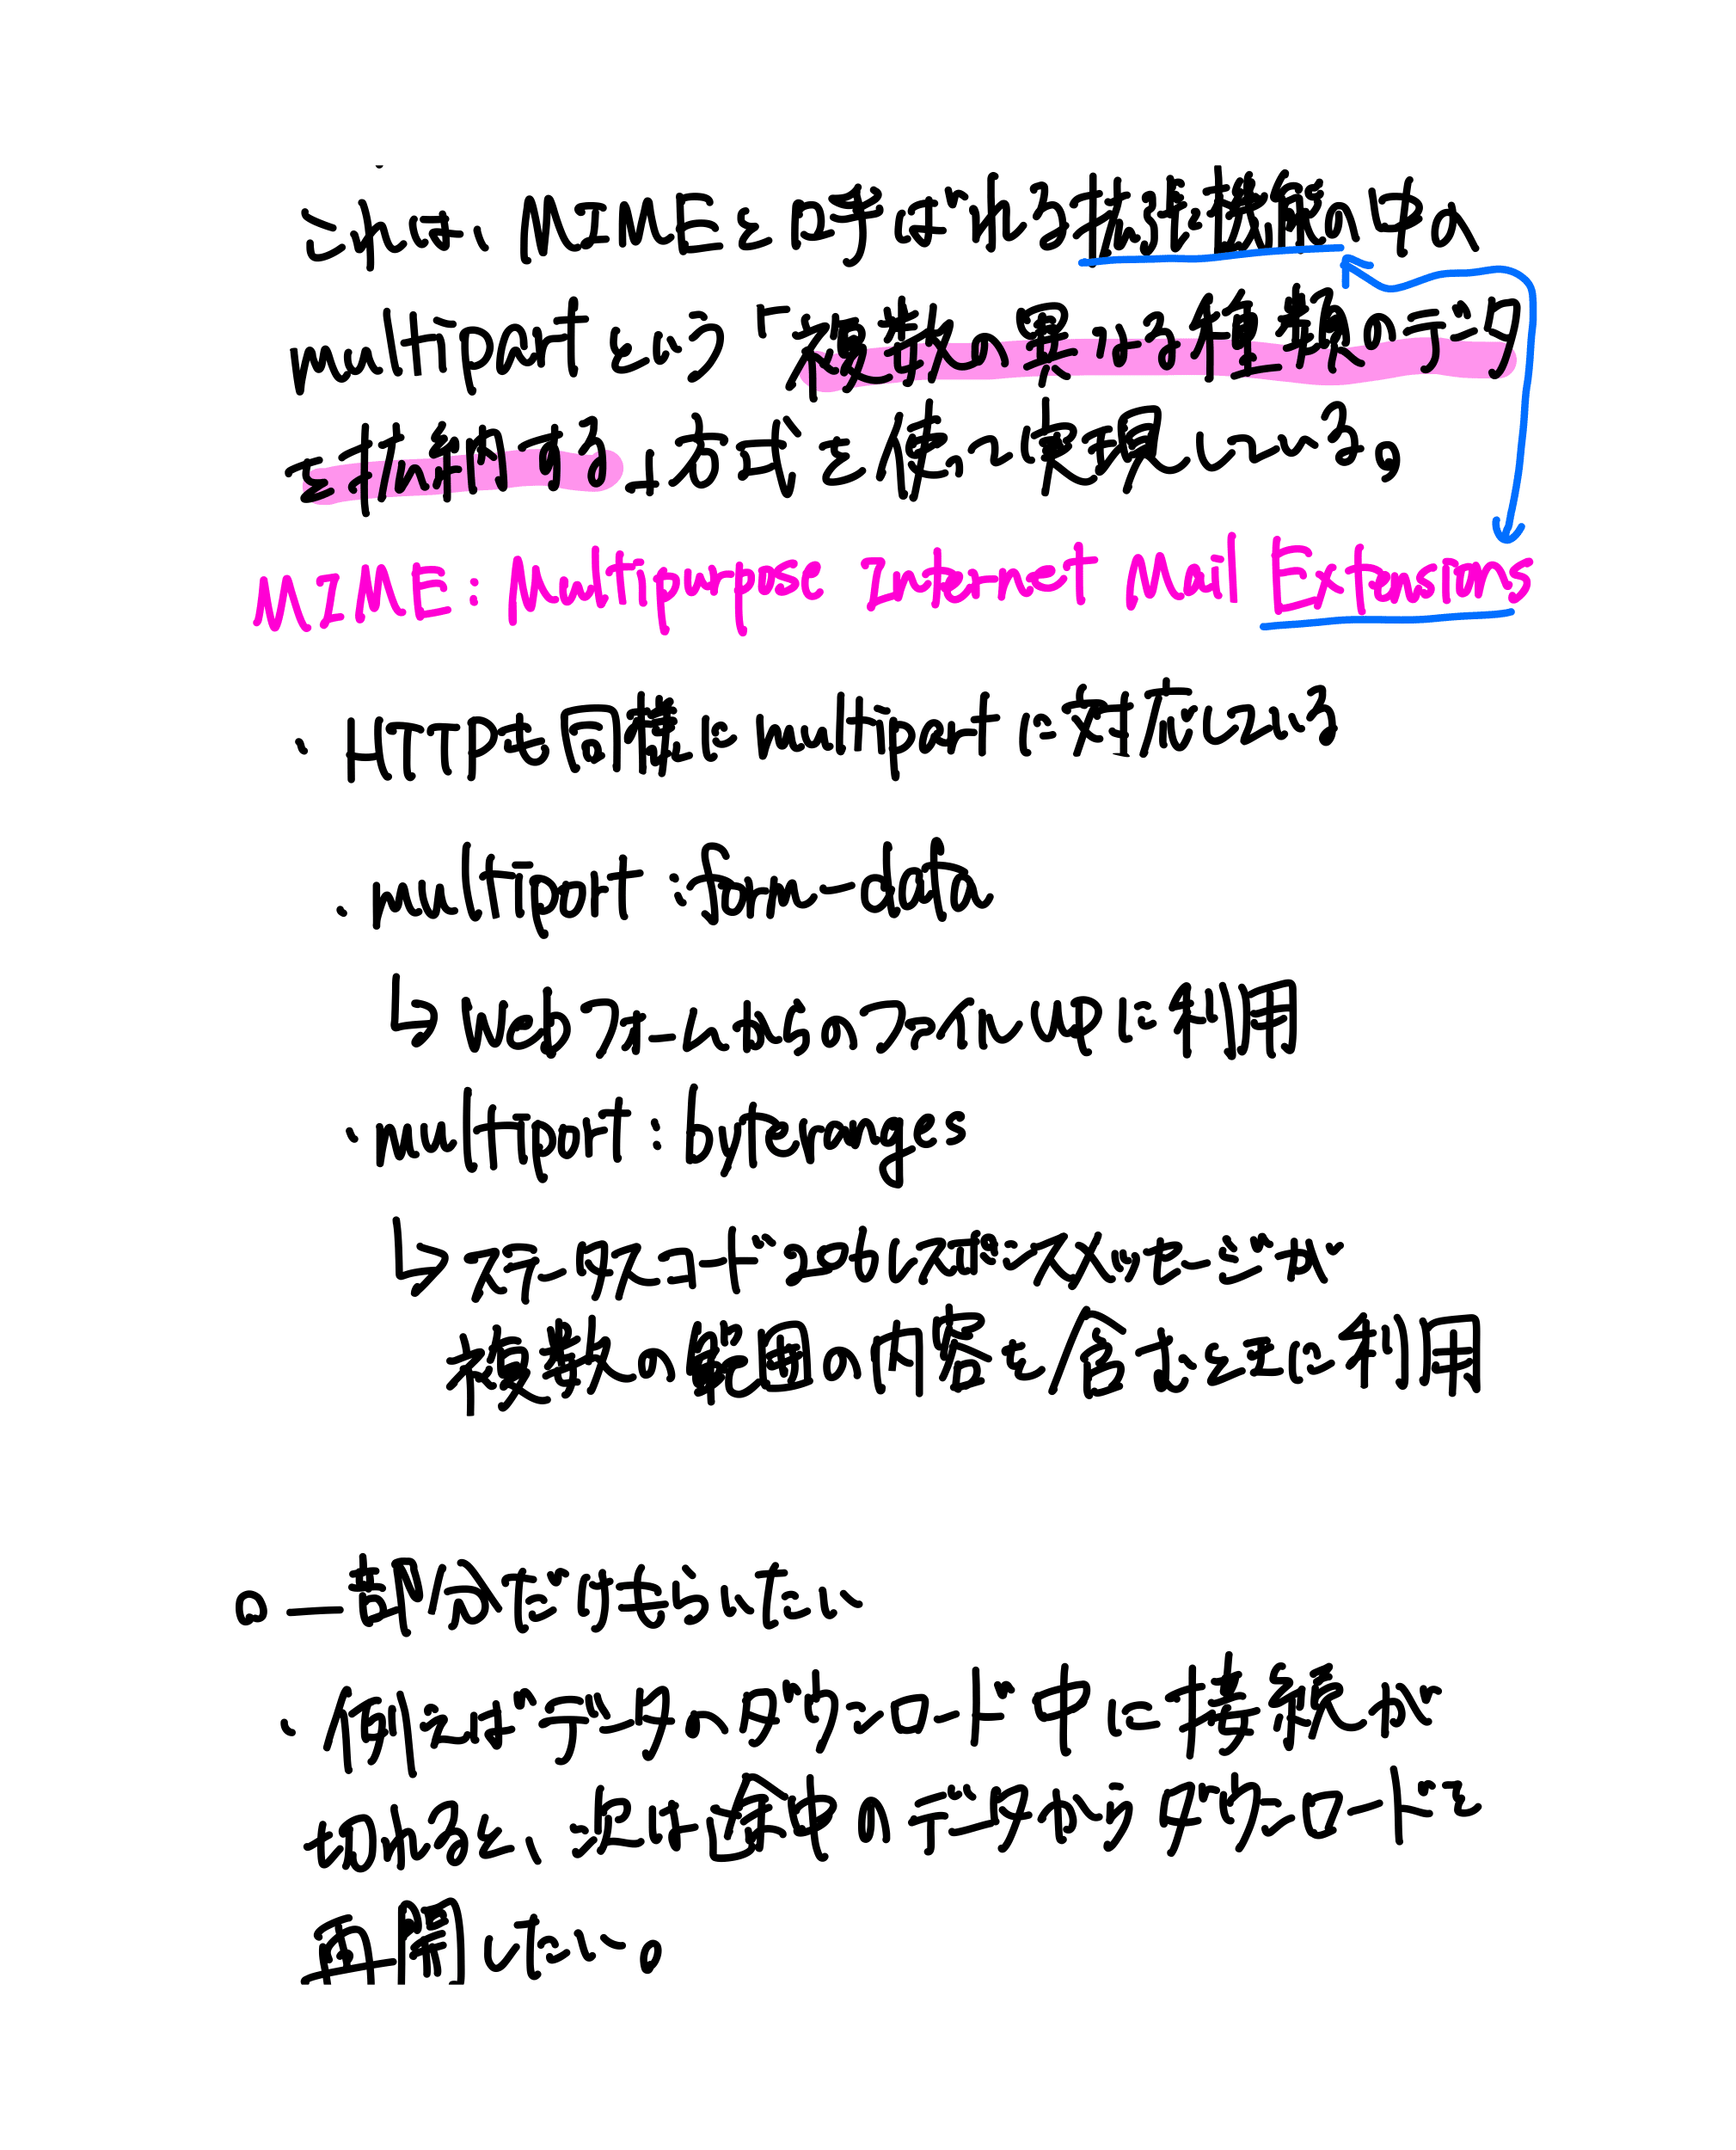
- メールは「テキスト」「ファイル」「動画」などを同時に送れる。これは MIME の multipart という方式で実現している。
- MIME:Multipurpose Internet Mail Extensions
- HTTPも multipart に対応:
- multipart/form-data → WebフォームからのファイルUPに利用
- multipart/byteranges → 206レスポンスが複数範囲の内容を含むときに利用
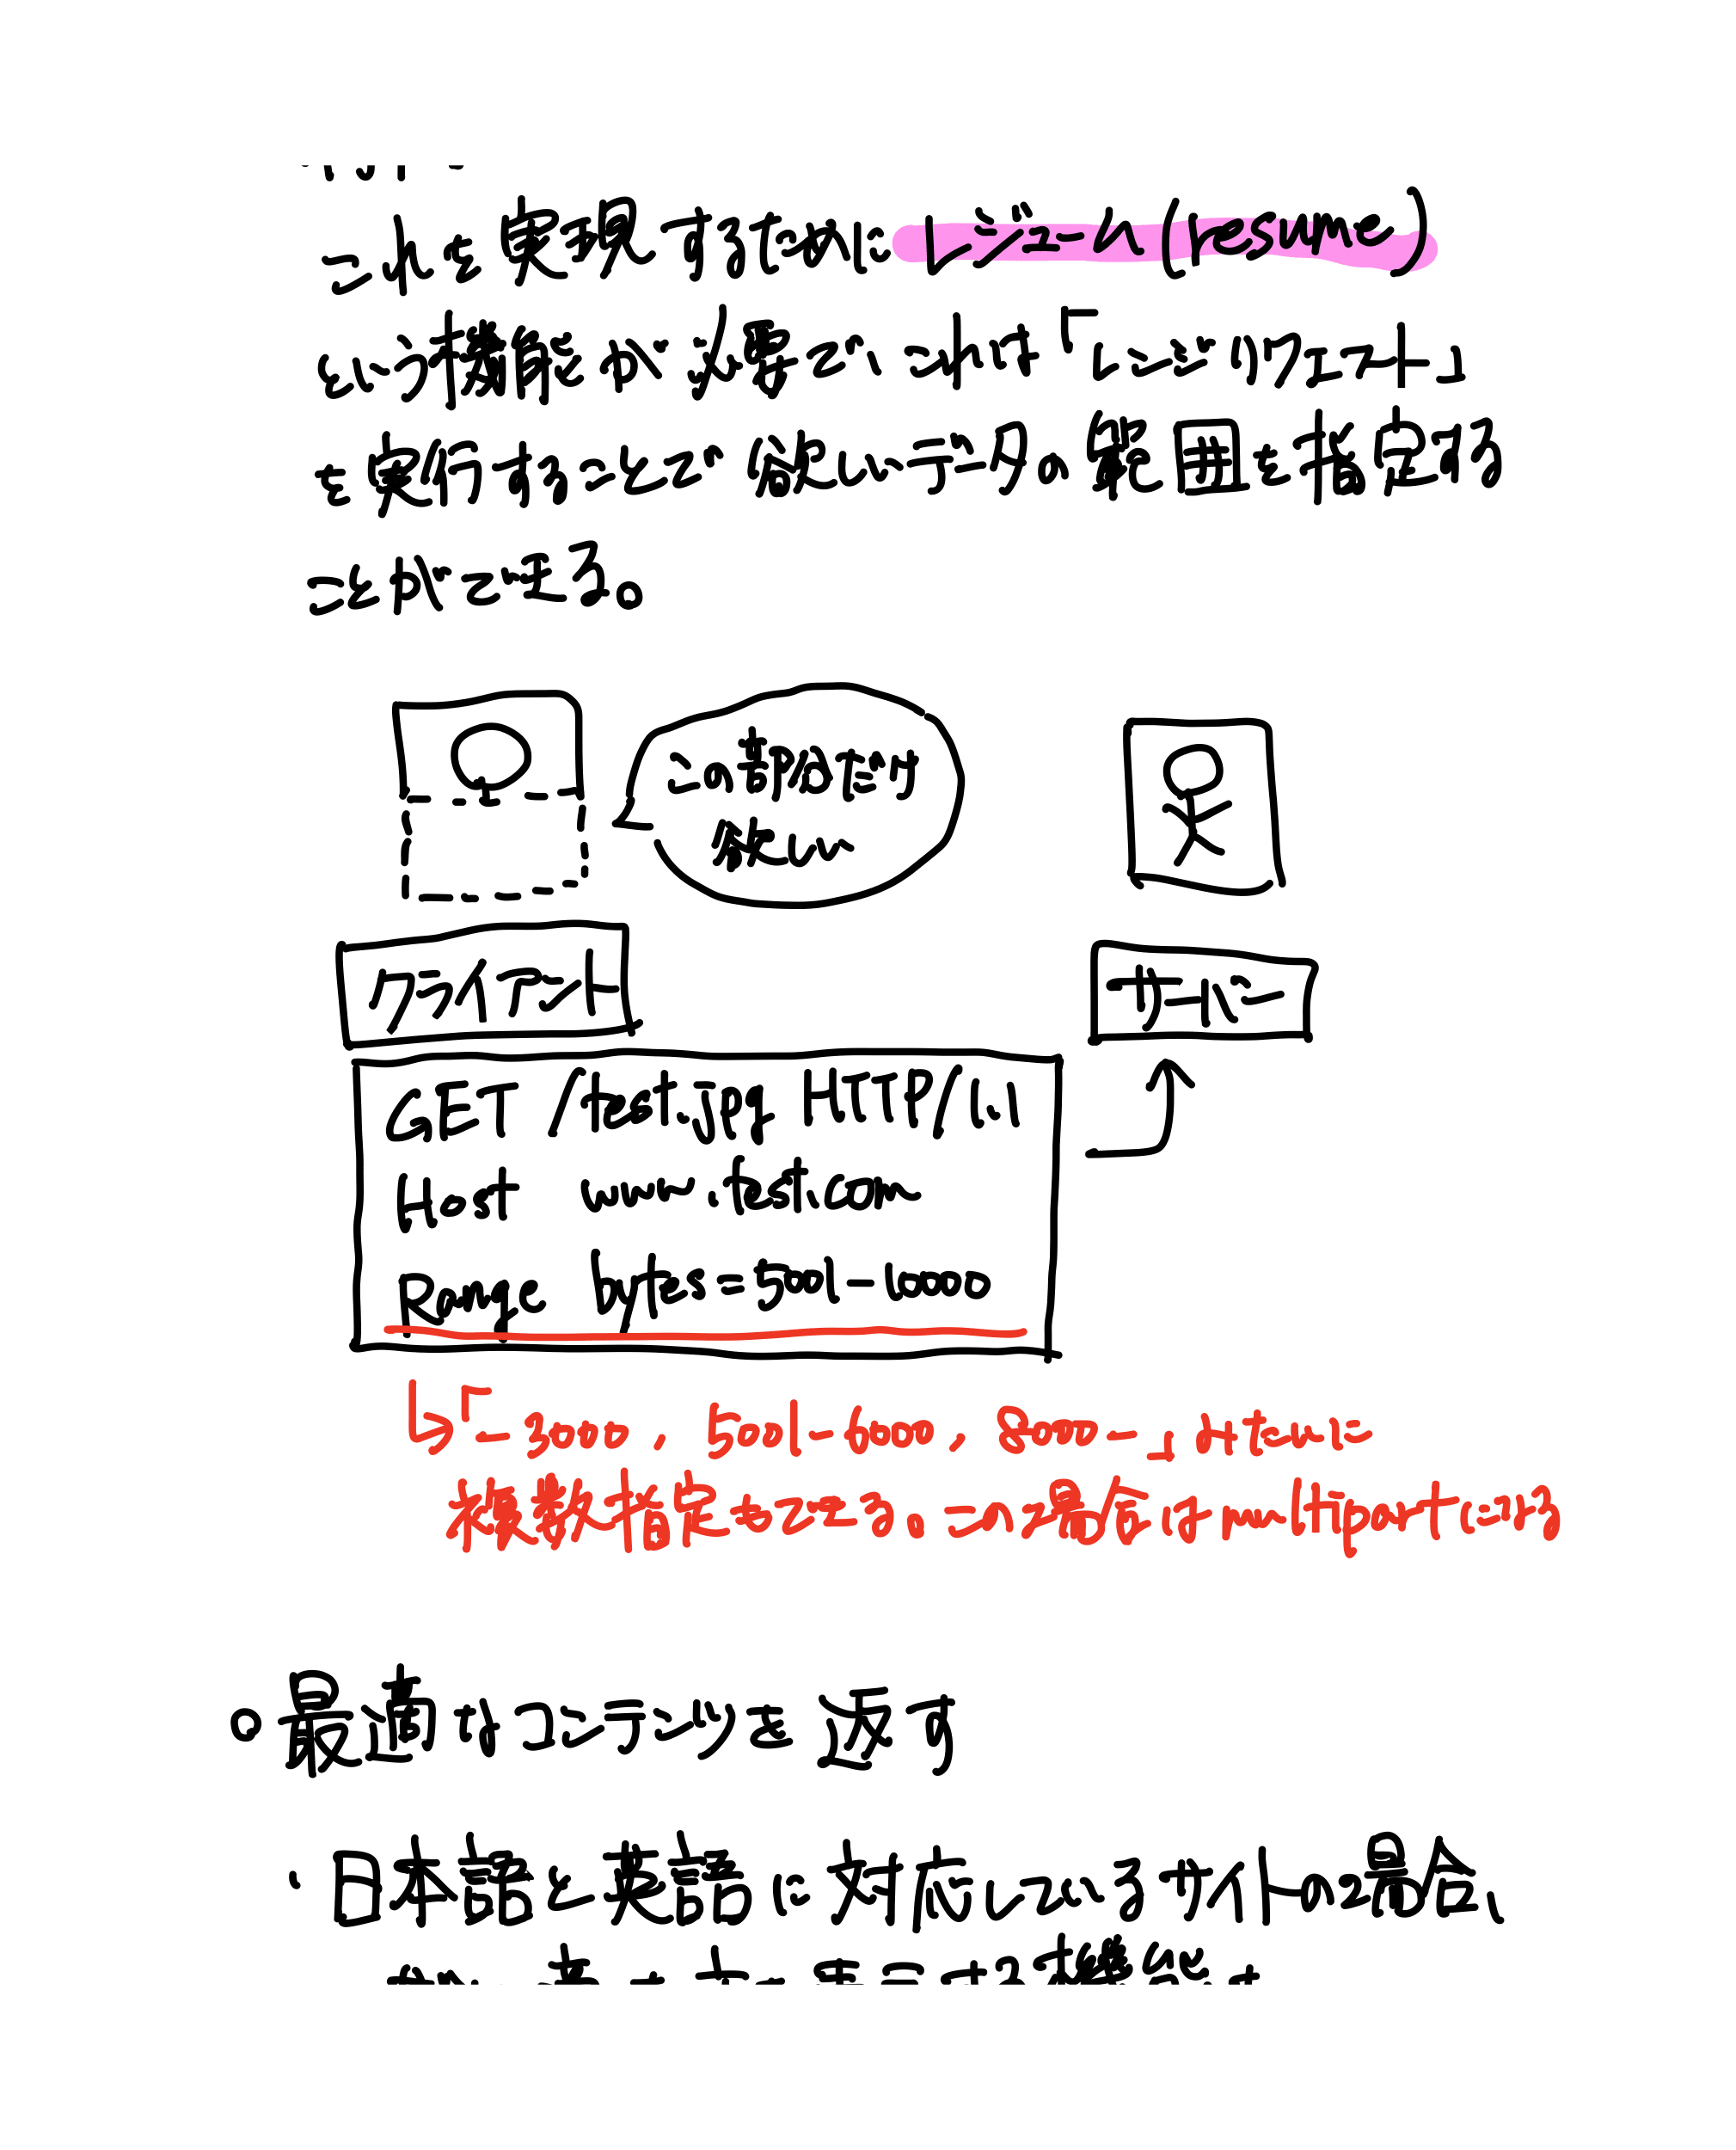
一部分だけもらいたい(レンジリクエスト)
- ダウンロード中に接続が切れたら、途中から再開したい → レジューム(resume)機能。
- 「レンジリクエスト」で欲しいデータの範囲を指定できる。
- 例)
Range: bytes=5001-10000 - 「-3000, 5001-6000, 8000-」のように複数指定もできる(この場合は multipart になる)。
- 例)
最適なコンテンツを返す(コンテンツネゴシエーション)
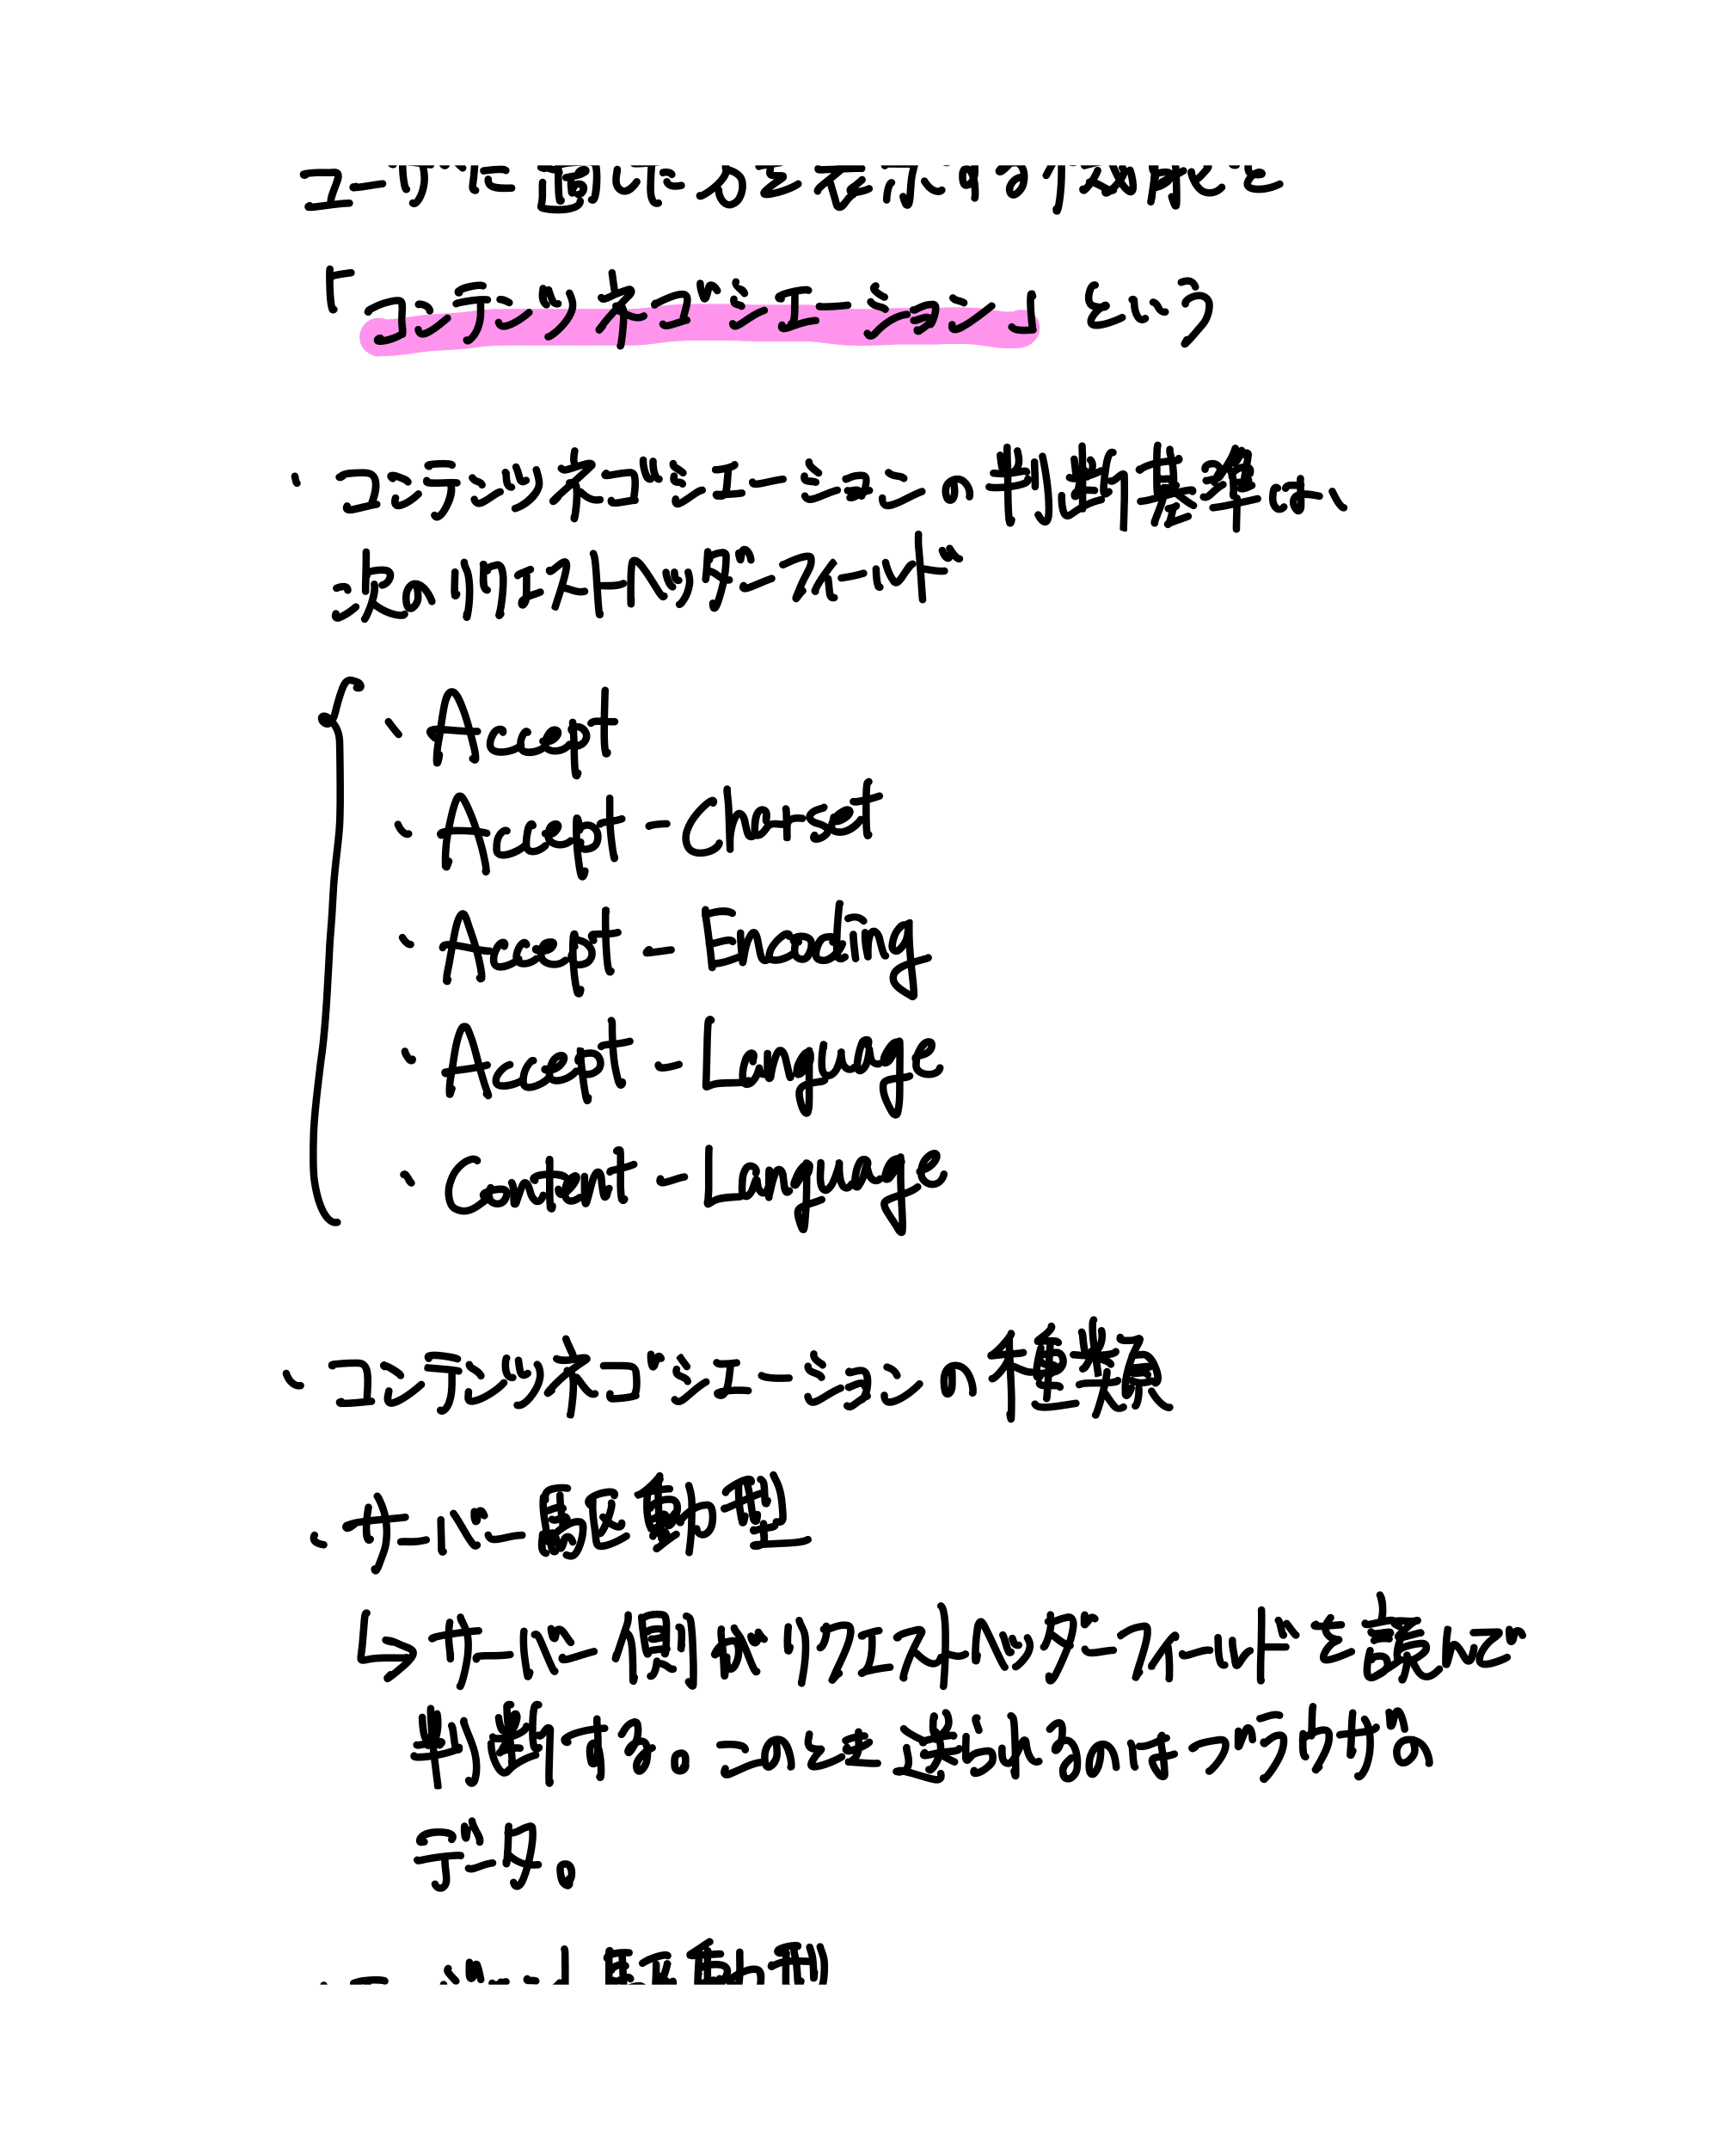
- 日英対応サイトなどで、ユーザに適したものを表示する仕組みを「コンテンツネゴシエーション」という。
- 判断基準となるリクエストヘッダー:Accept / Accept-Charset / Accept-Encoding / Accept-Language / Content-Language。
- 種類:
- サーバー駆動型 → サーバー側がリクエストヘッダーを読んで判断する。
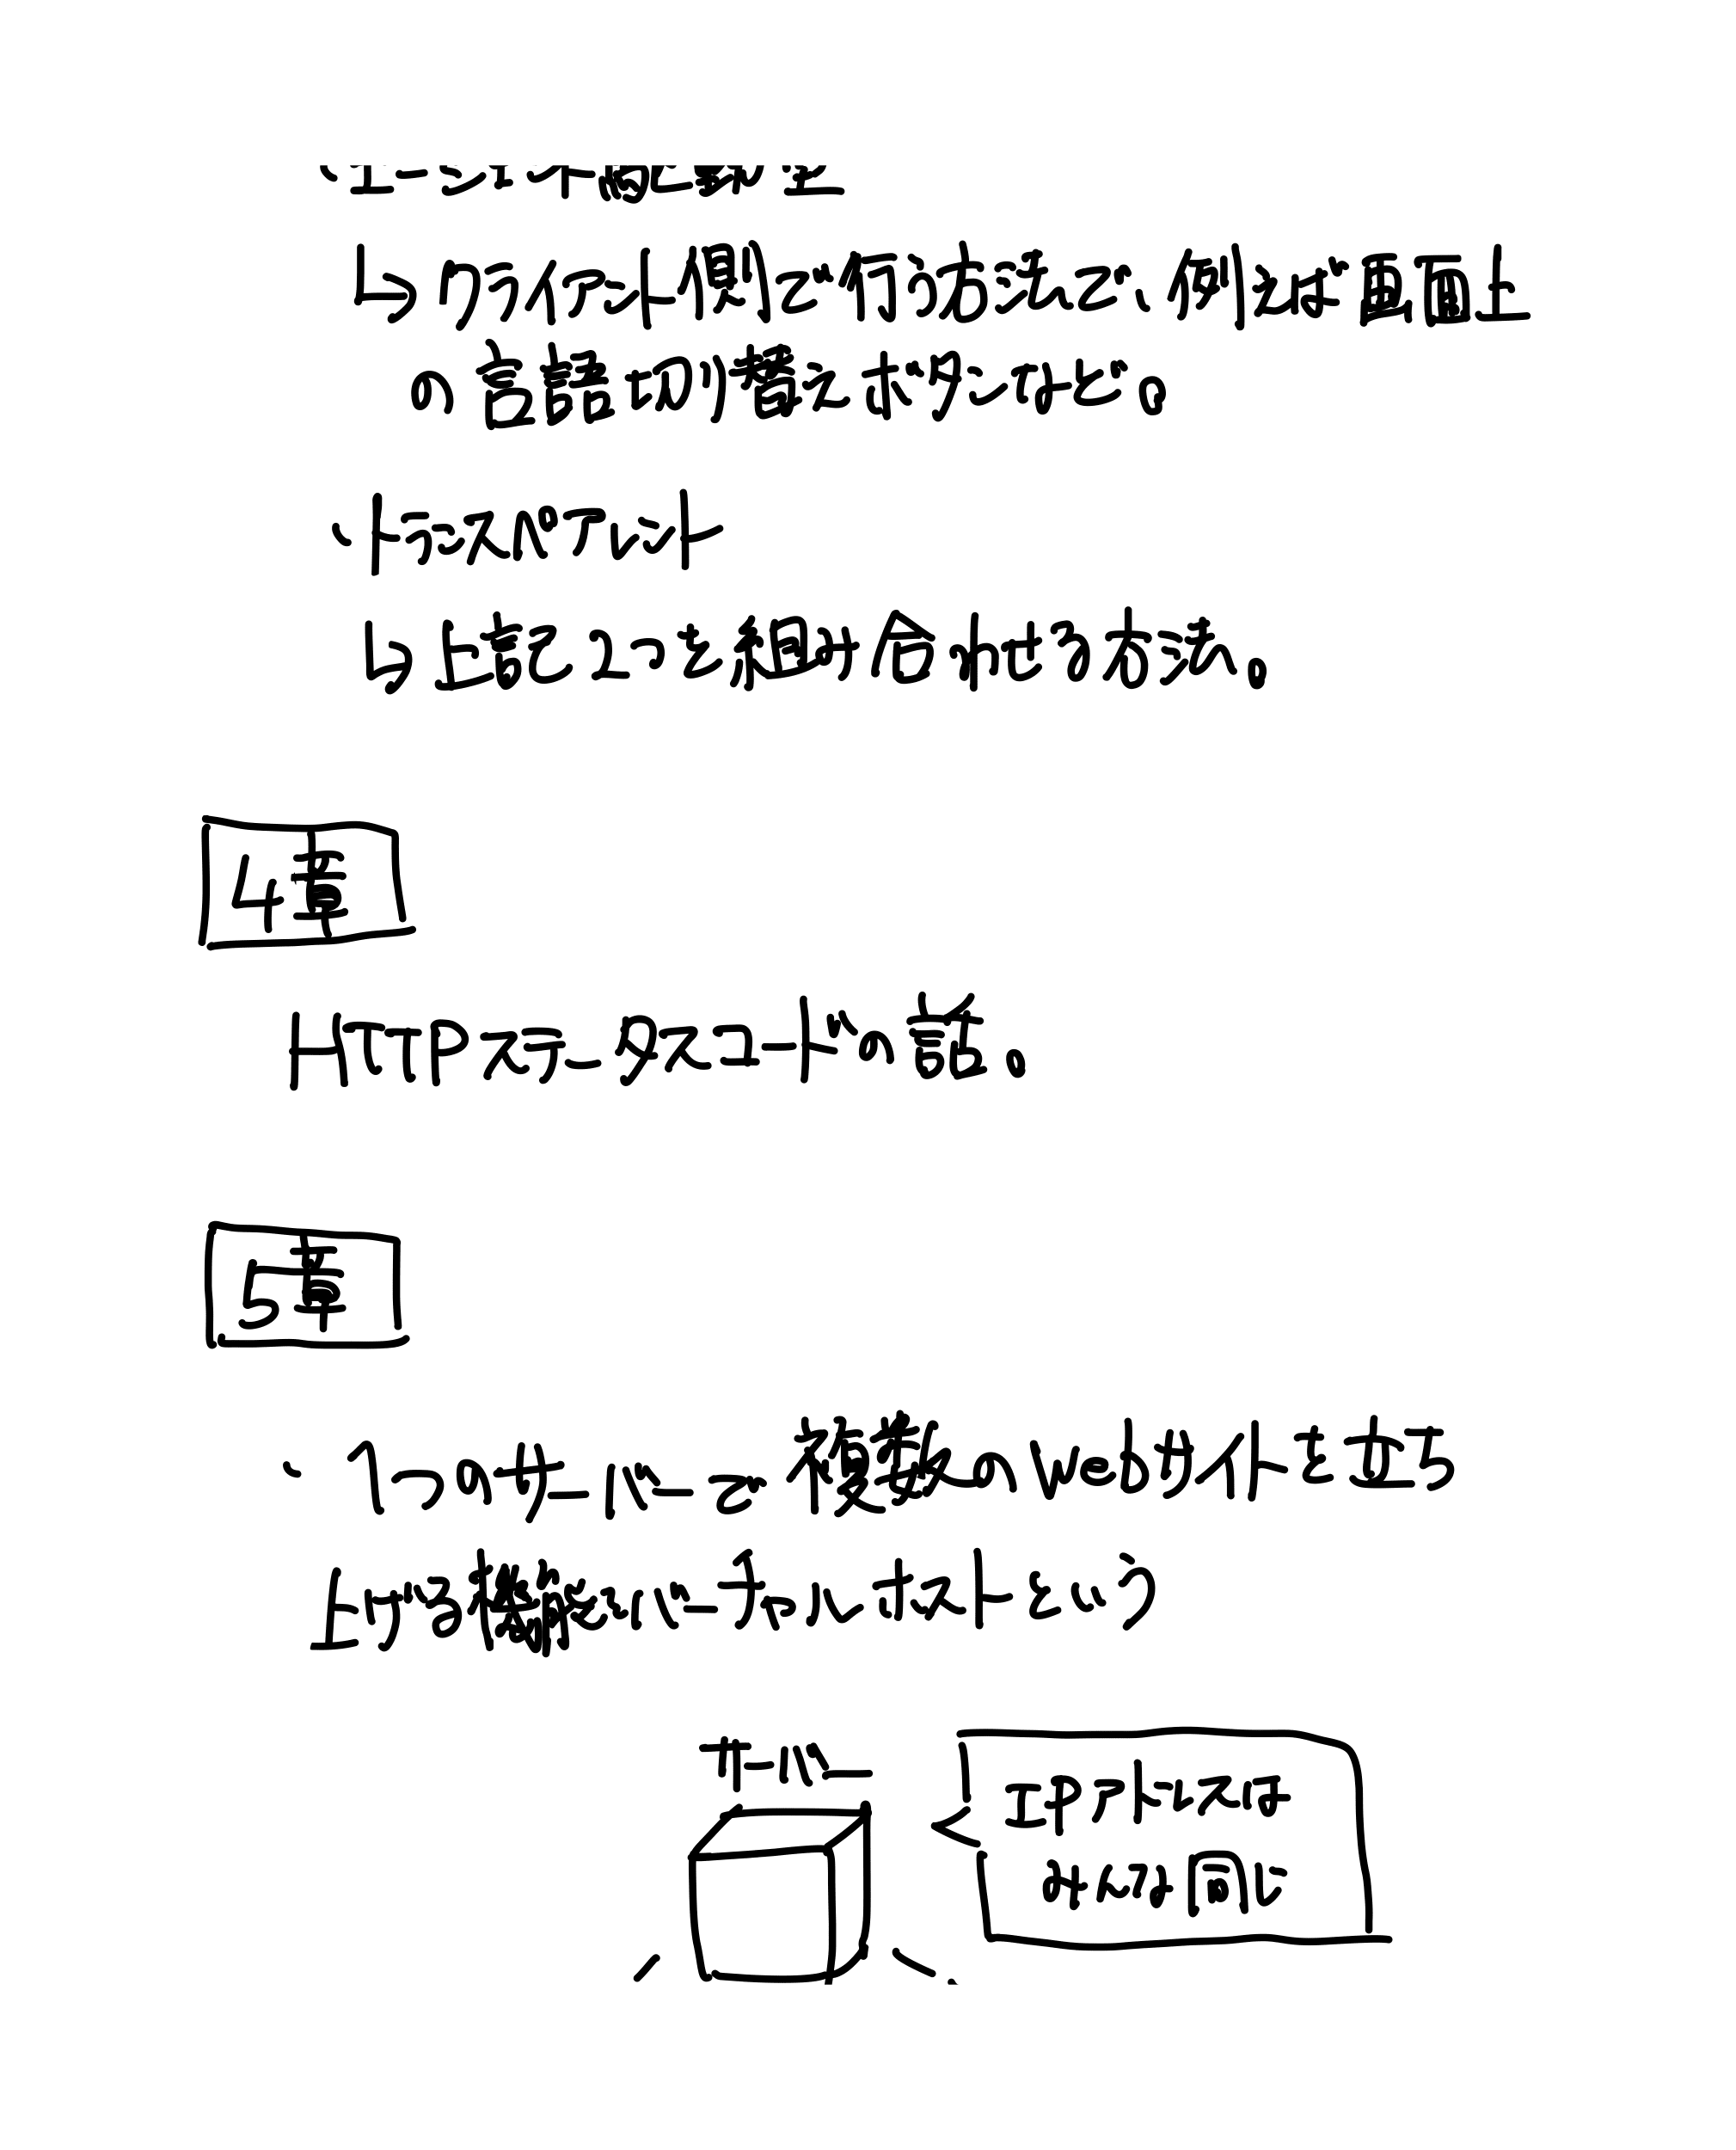
- クライアント駆動型 → クライアント側で行う(画面上の言語切り替えボタンなど)。
- トランスペアレント → 上記2つを組み合わせる。
4章 ステータスコード
- HTTPステータスコードの話。
5章 Webサーバー・中継
- 1つのサーバーで複数のWebサイトを立ち上げる機能を「バーチャルホスト」という。IPアドレスはみんな同じ。
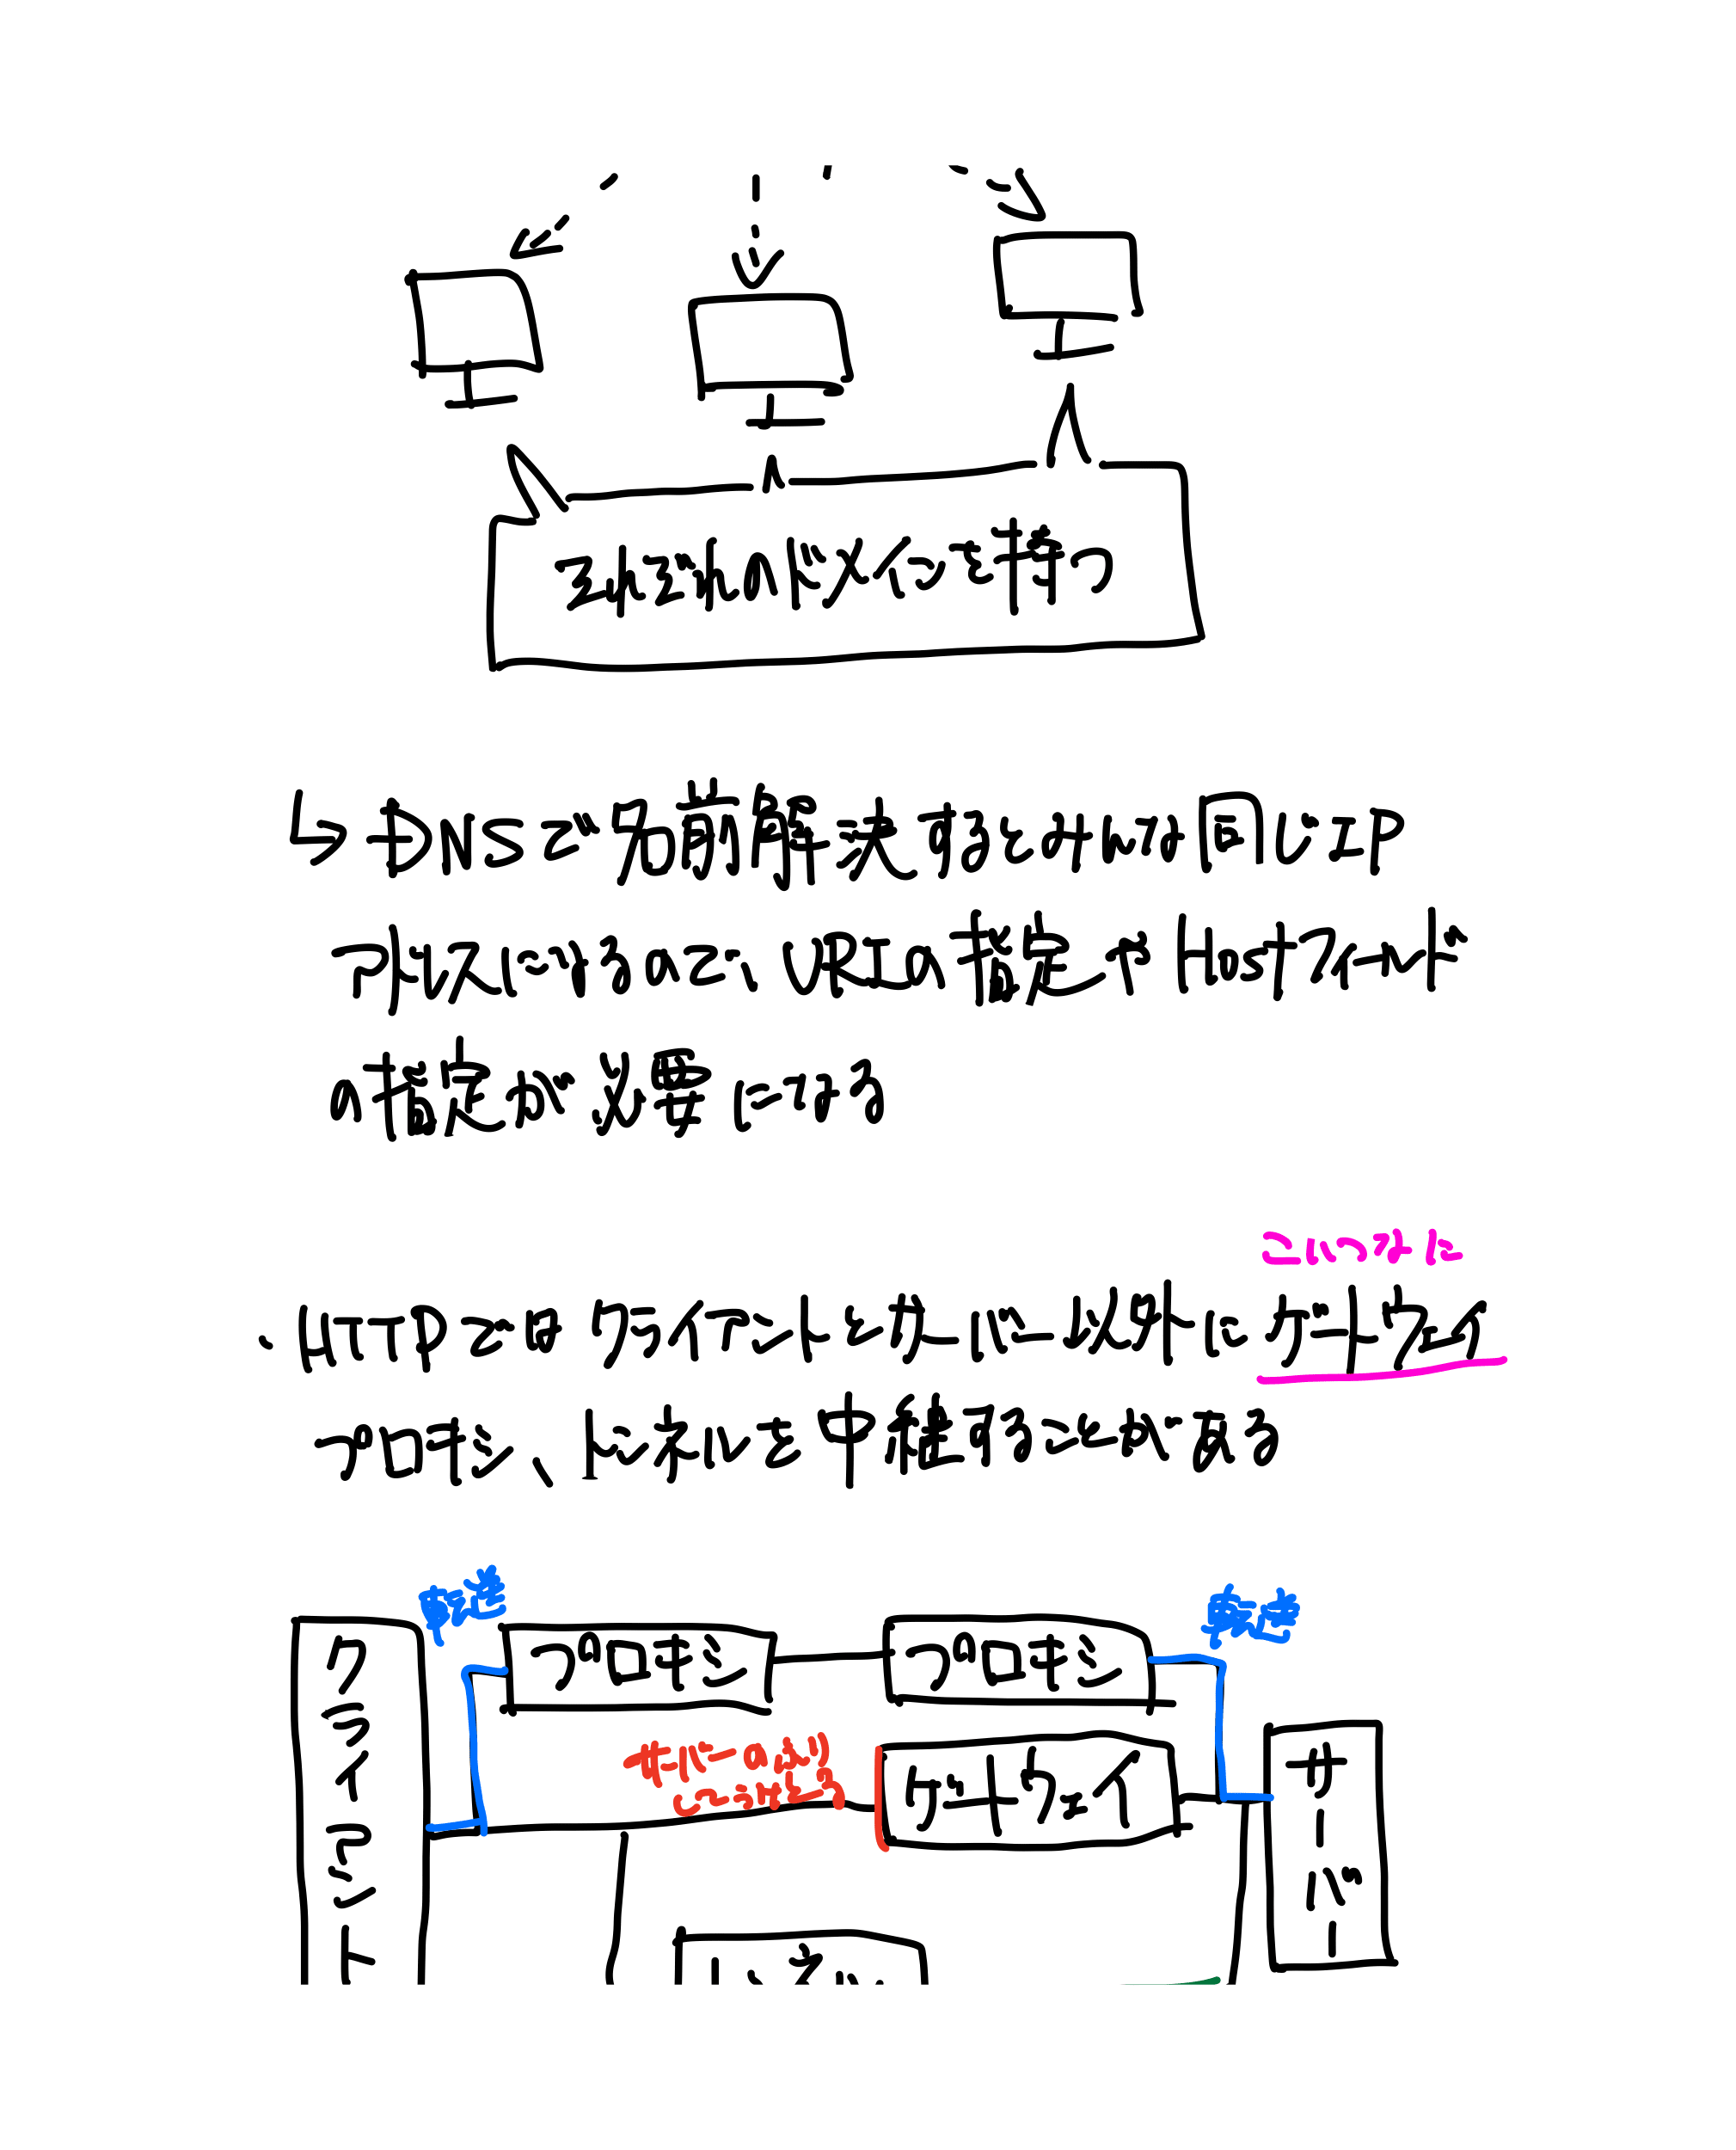
- → DNSで名前解決するとみんな同じIPアドレスになるので、URIの指定や Host フィールドの指定が必要。
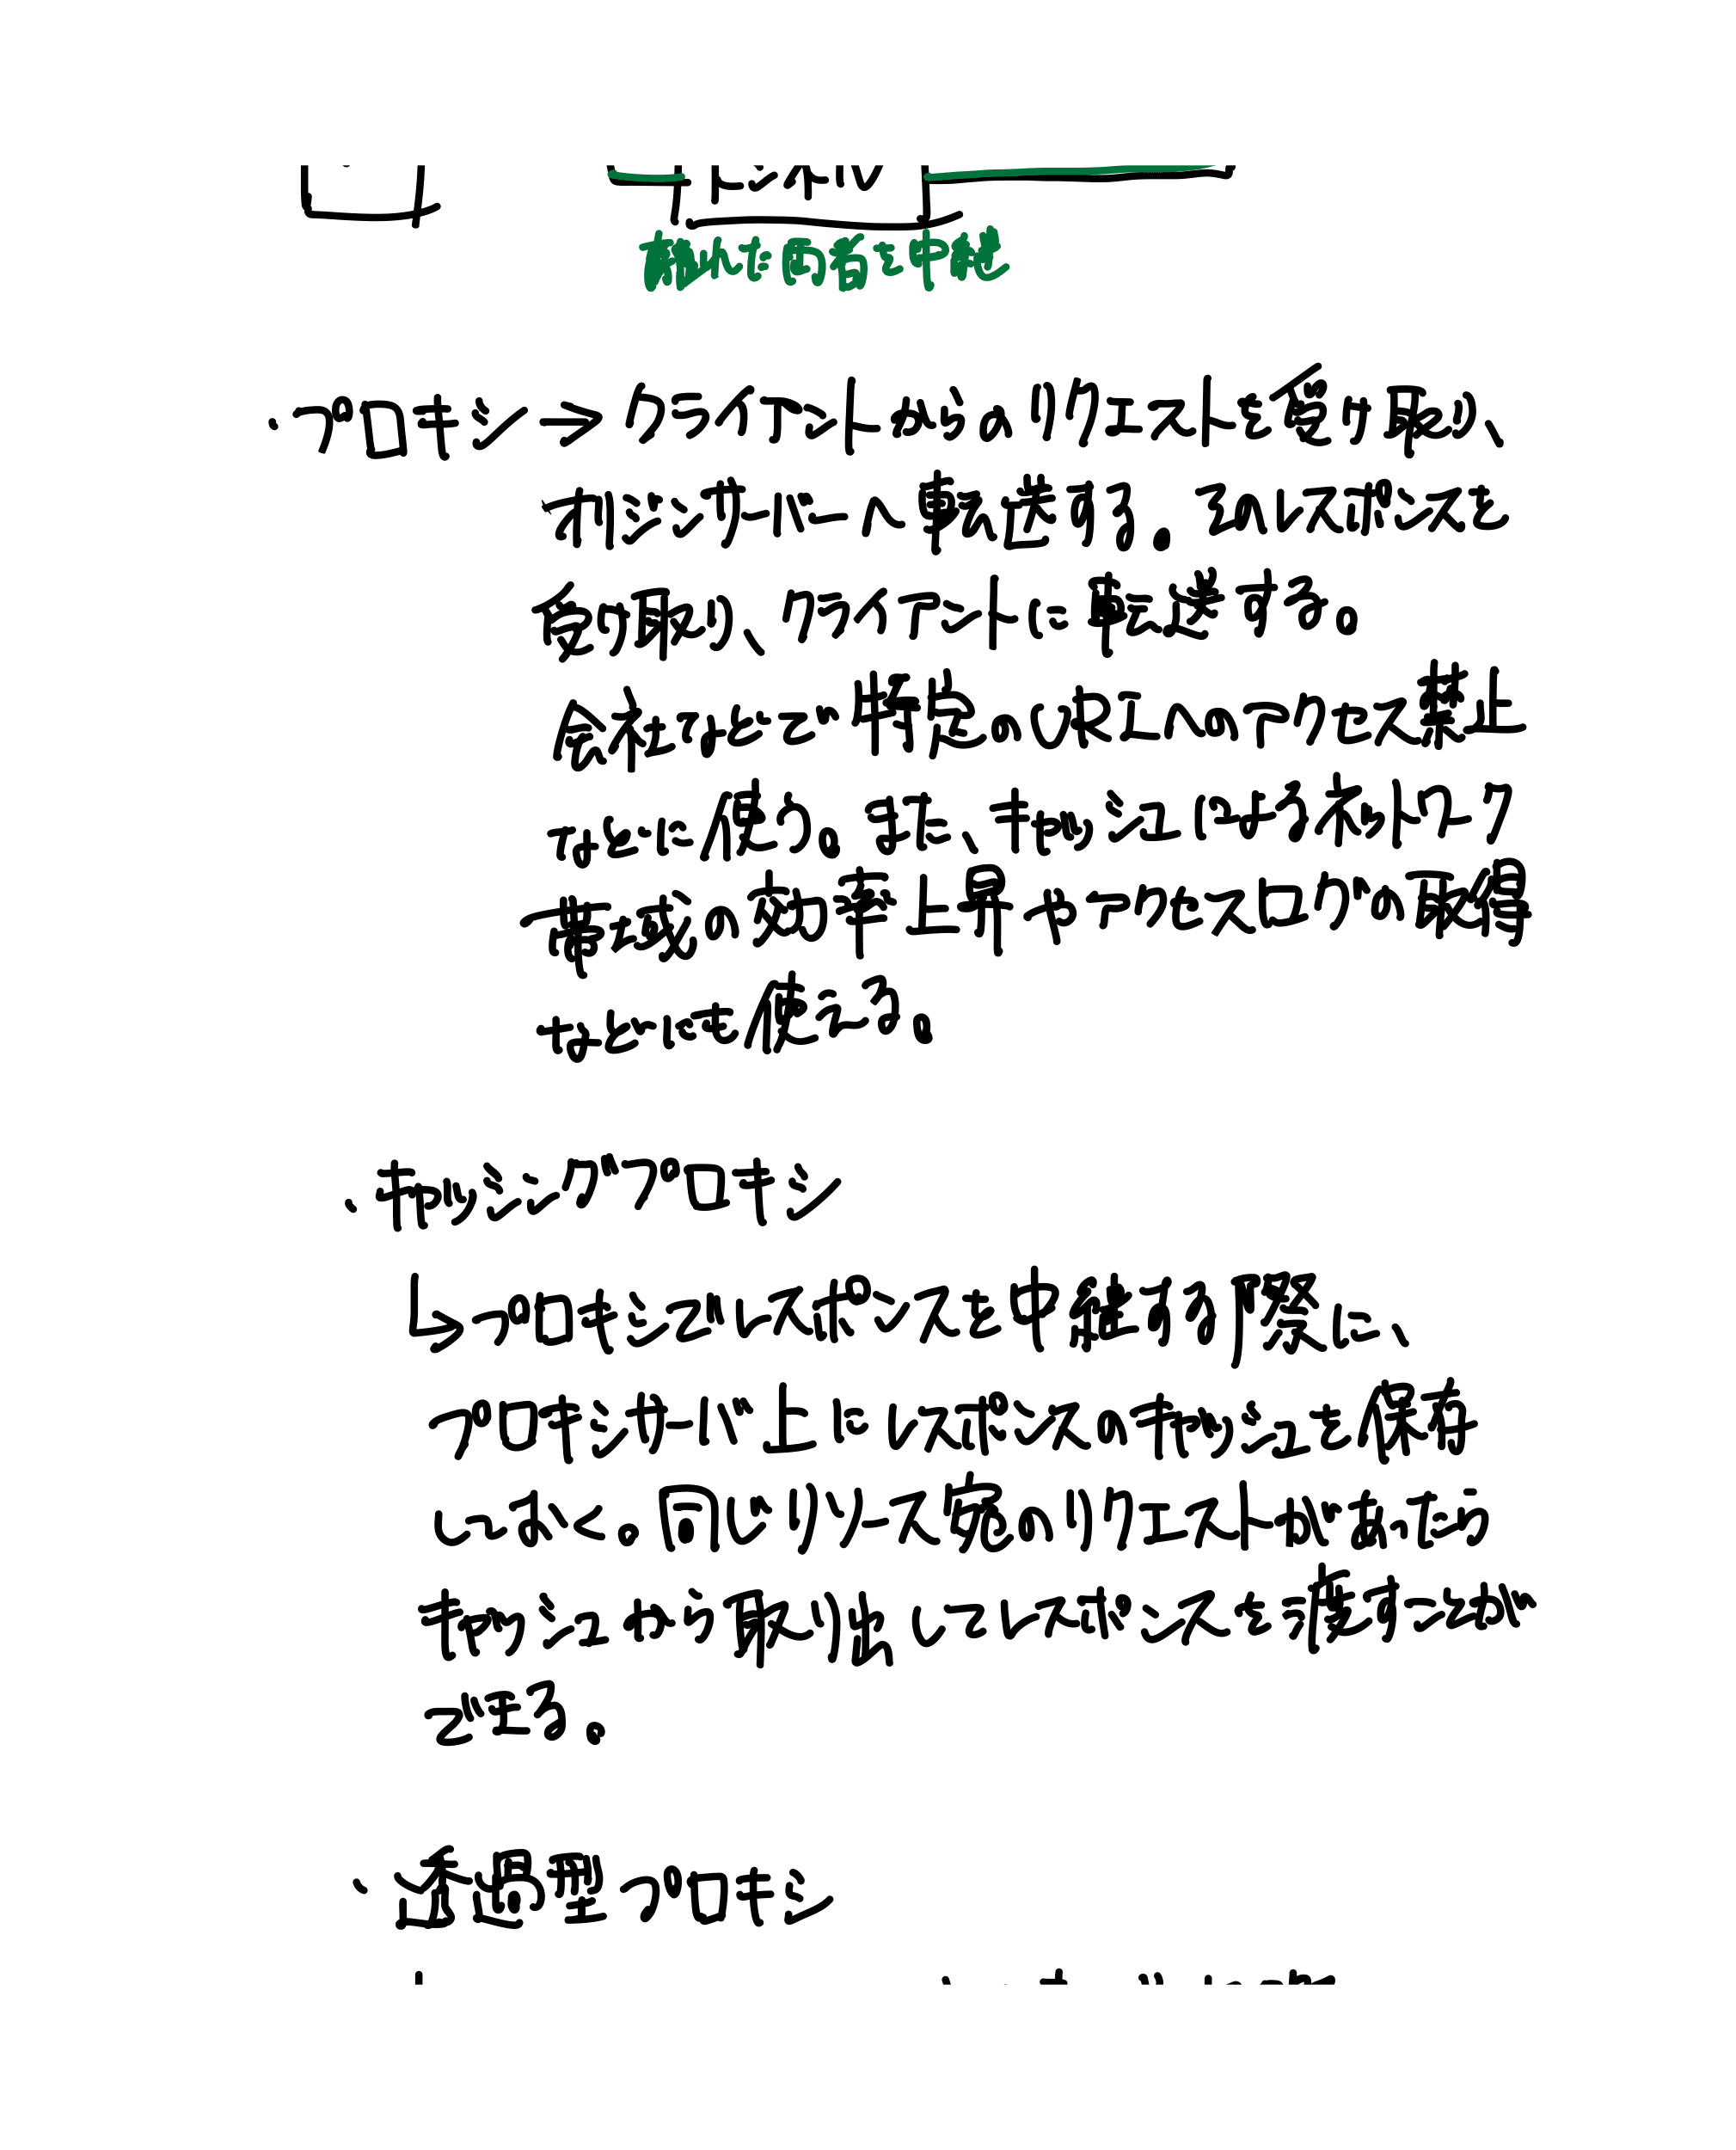
- HTTPでは、クライアントとサーバー以外に、ゲートウェイ・プロキシ・トンネルを中継することがある。
- プロキシ → クライアントのリクエストを受け取りオリジンサーバーへ転送、そのレスポンスをクライアントへ転送。特定URLへのアクセス禁止、キャッシュによる帯域効率化、アクセスログ取得などに使う。
- キャッシングプロキシ → 中継の際にプロキシ上にレスポンスのキャッシュを保存。同じリソース宛のリクエストにはキャッシュから返せる。
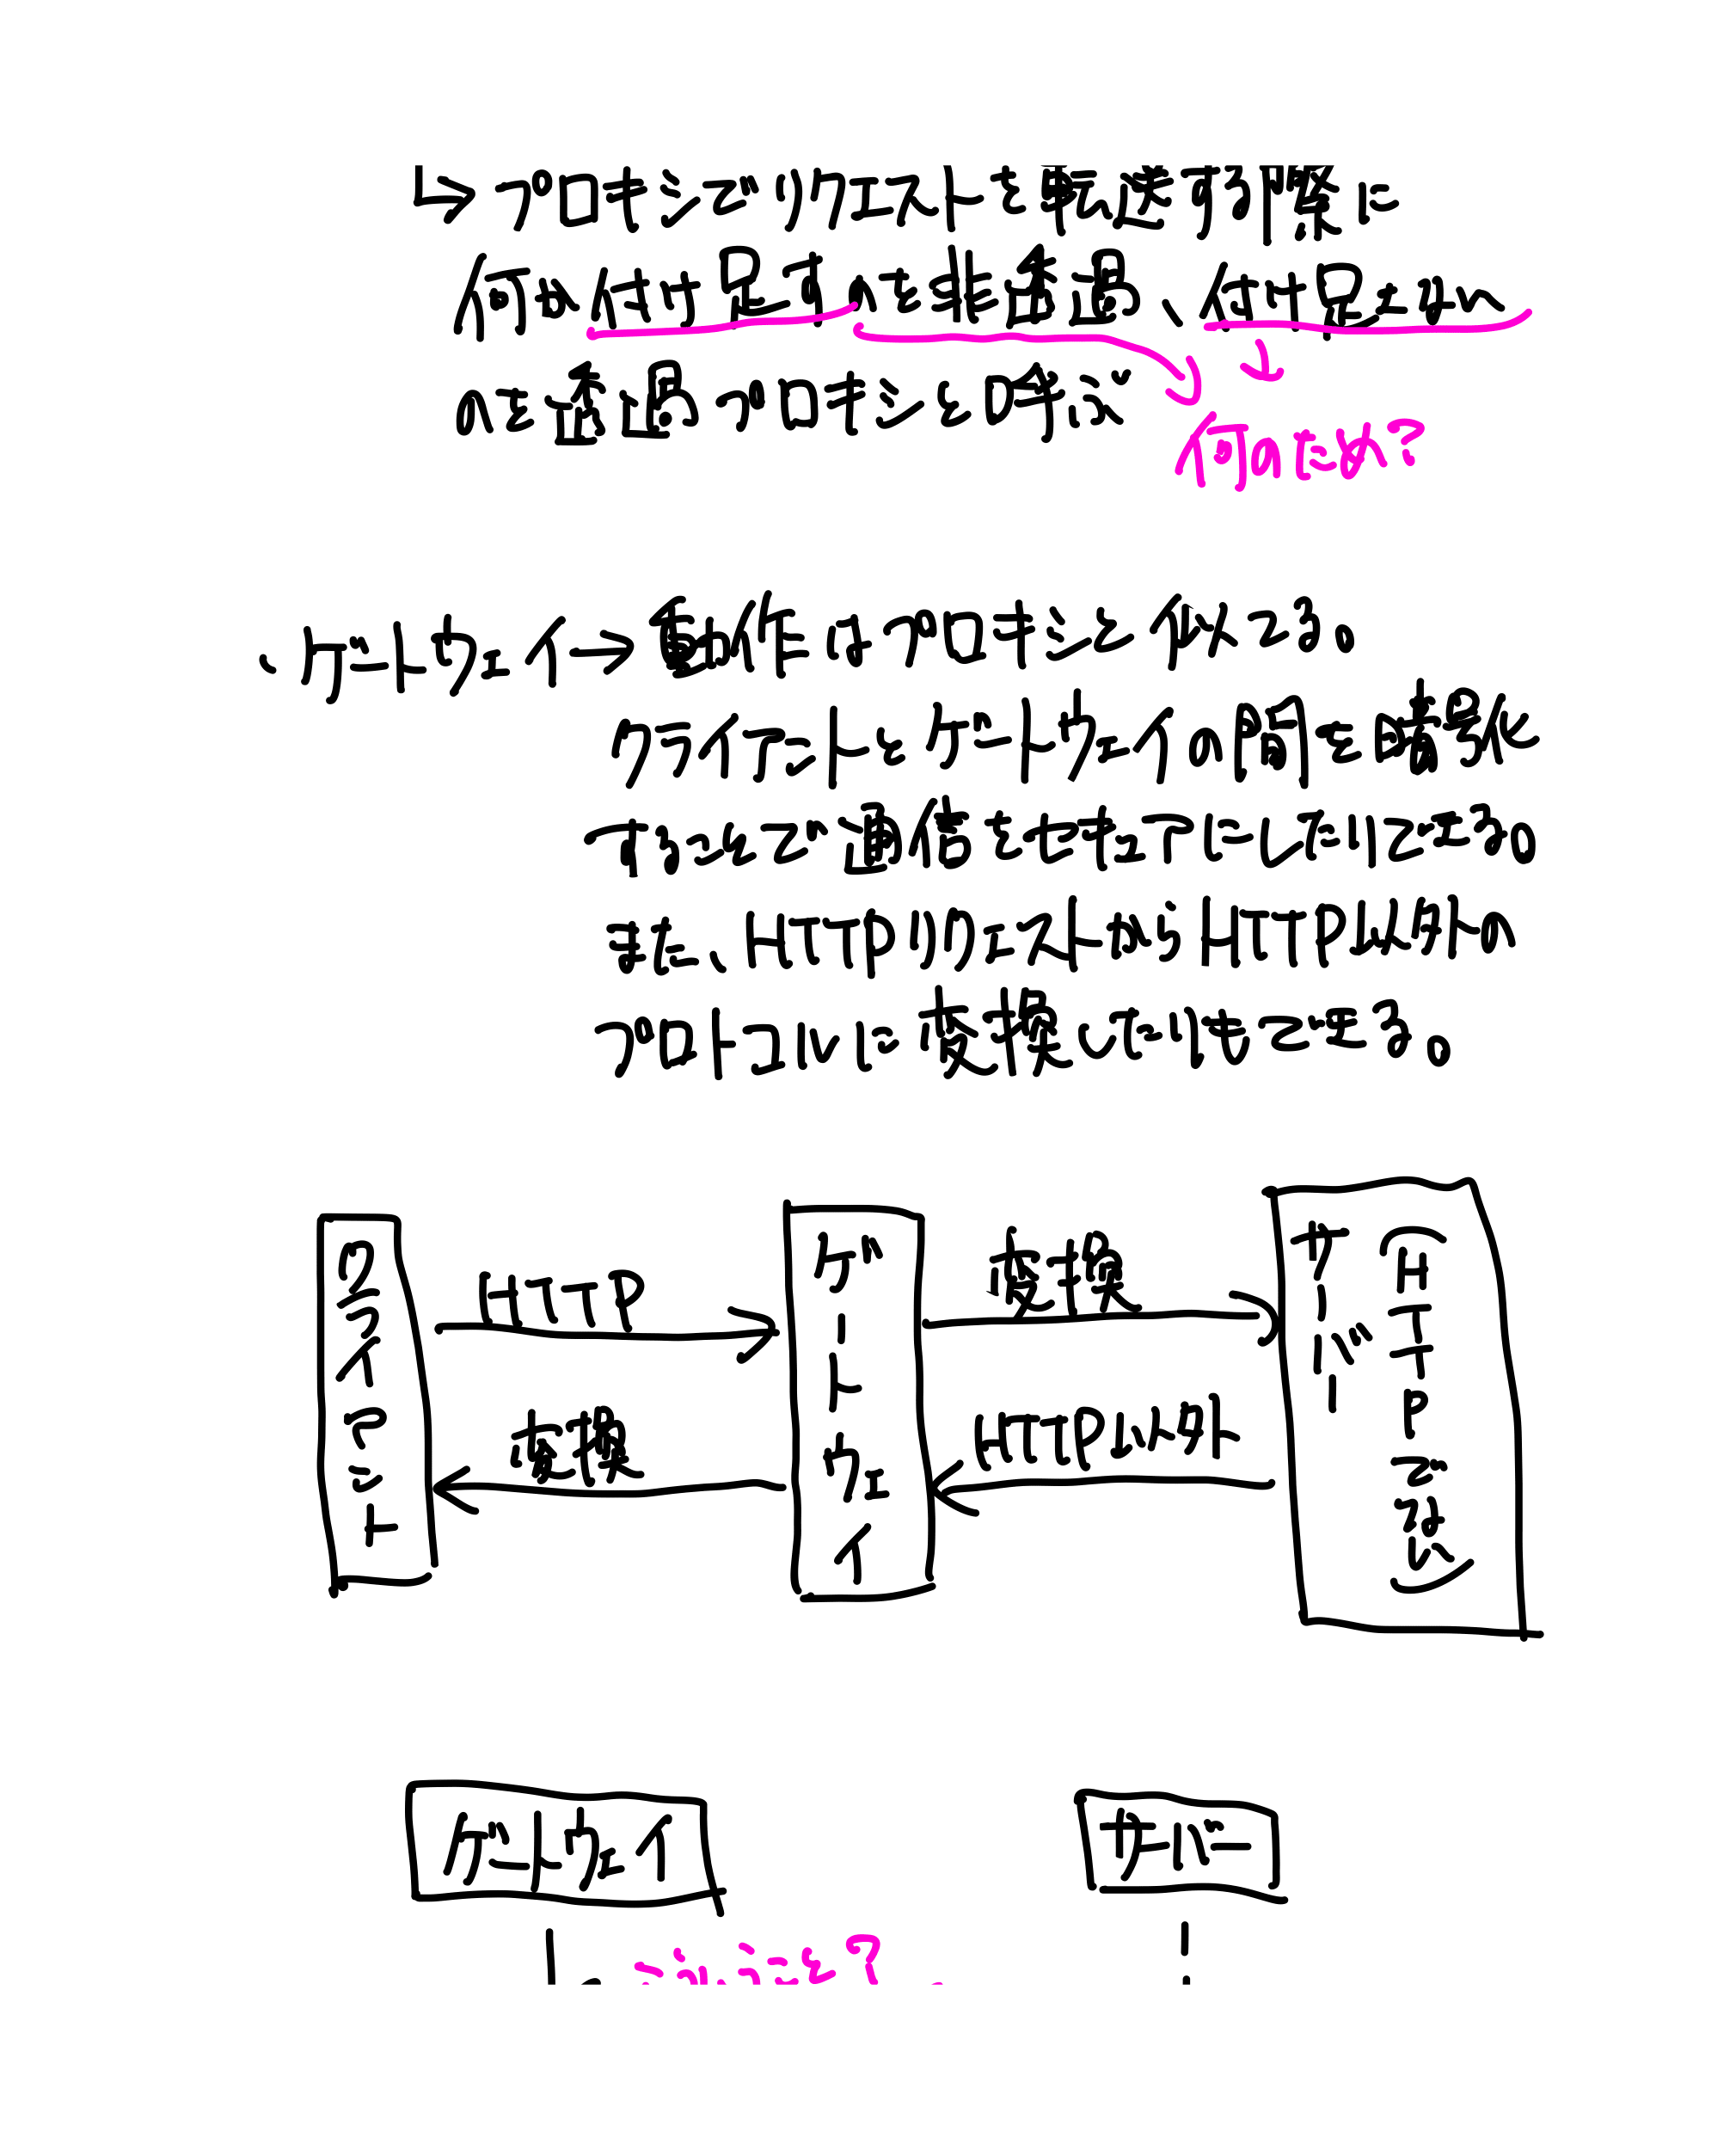
- 透過型/非透過型 → 転送時に何も付け足さないのが非透過、付け足すのが透過。
- ゲートウェイ → 動作はプロキシに似る。クライアントとの間を暗号化して通信をセキュアにしたり、HTTPリクエストからHTTP以外のプロトコルへ変換したりできる。
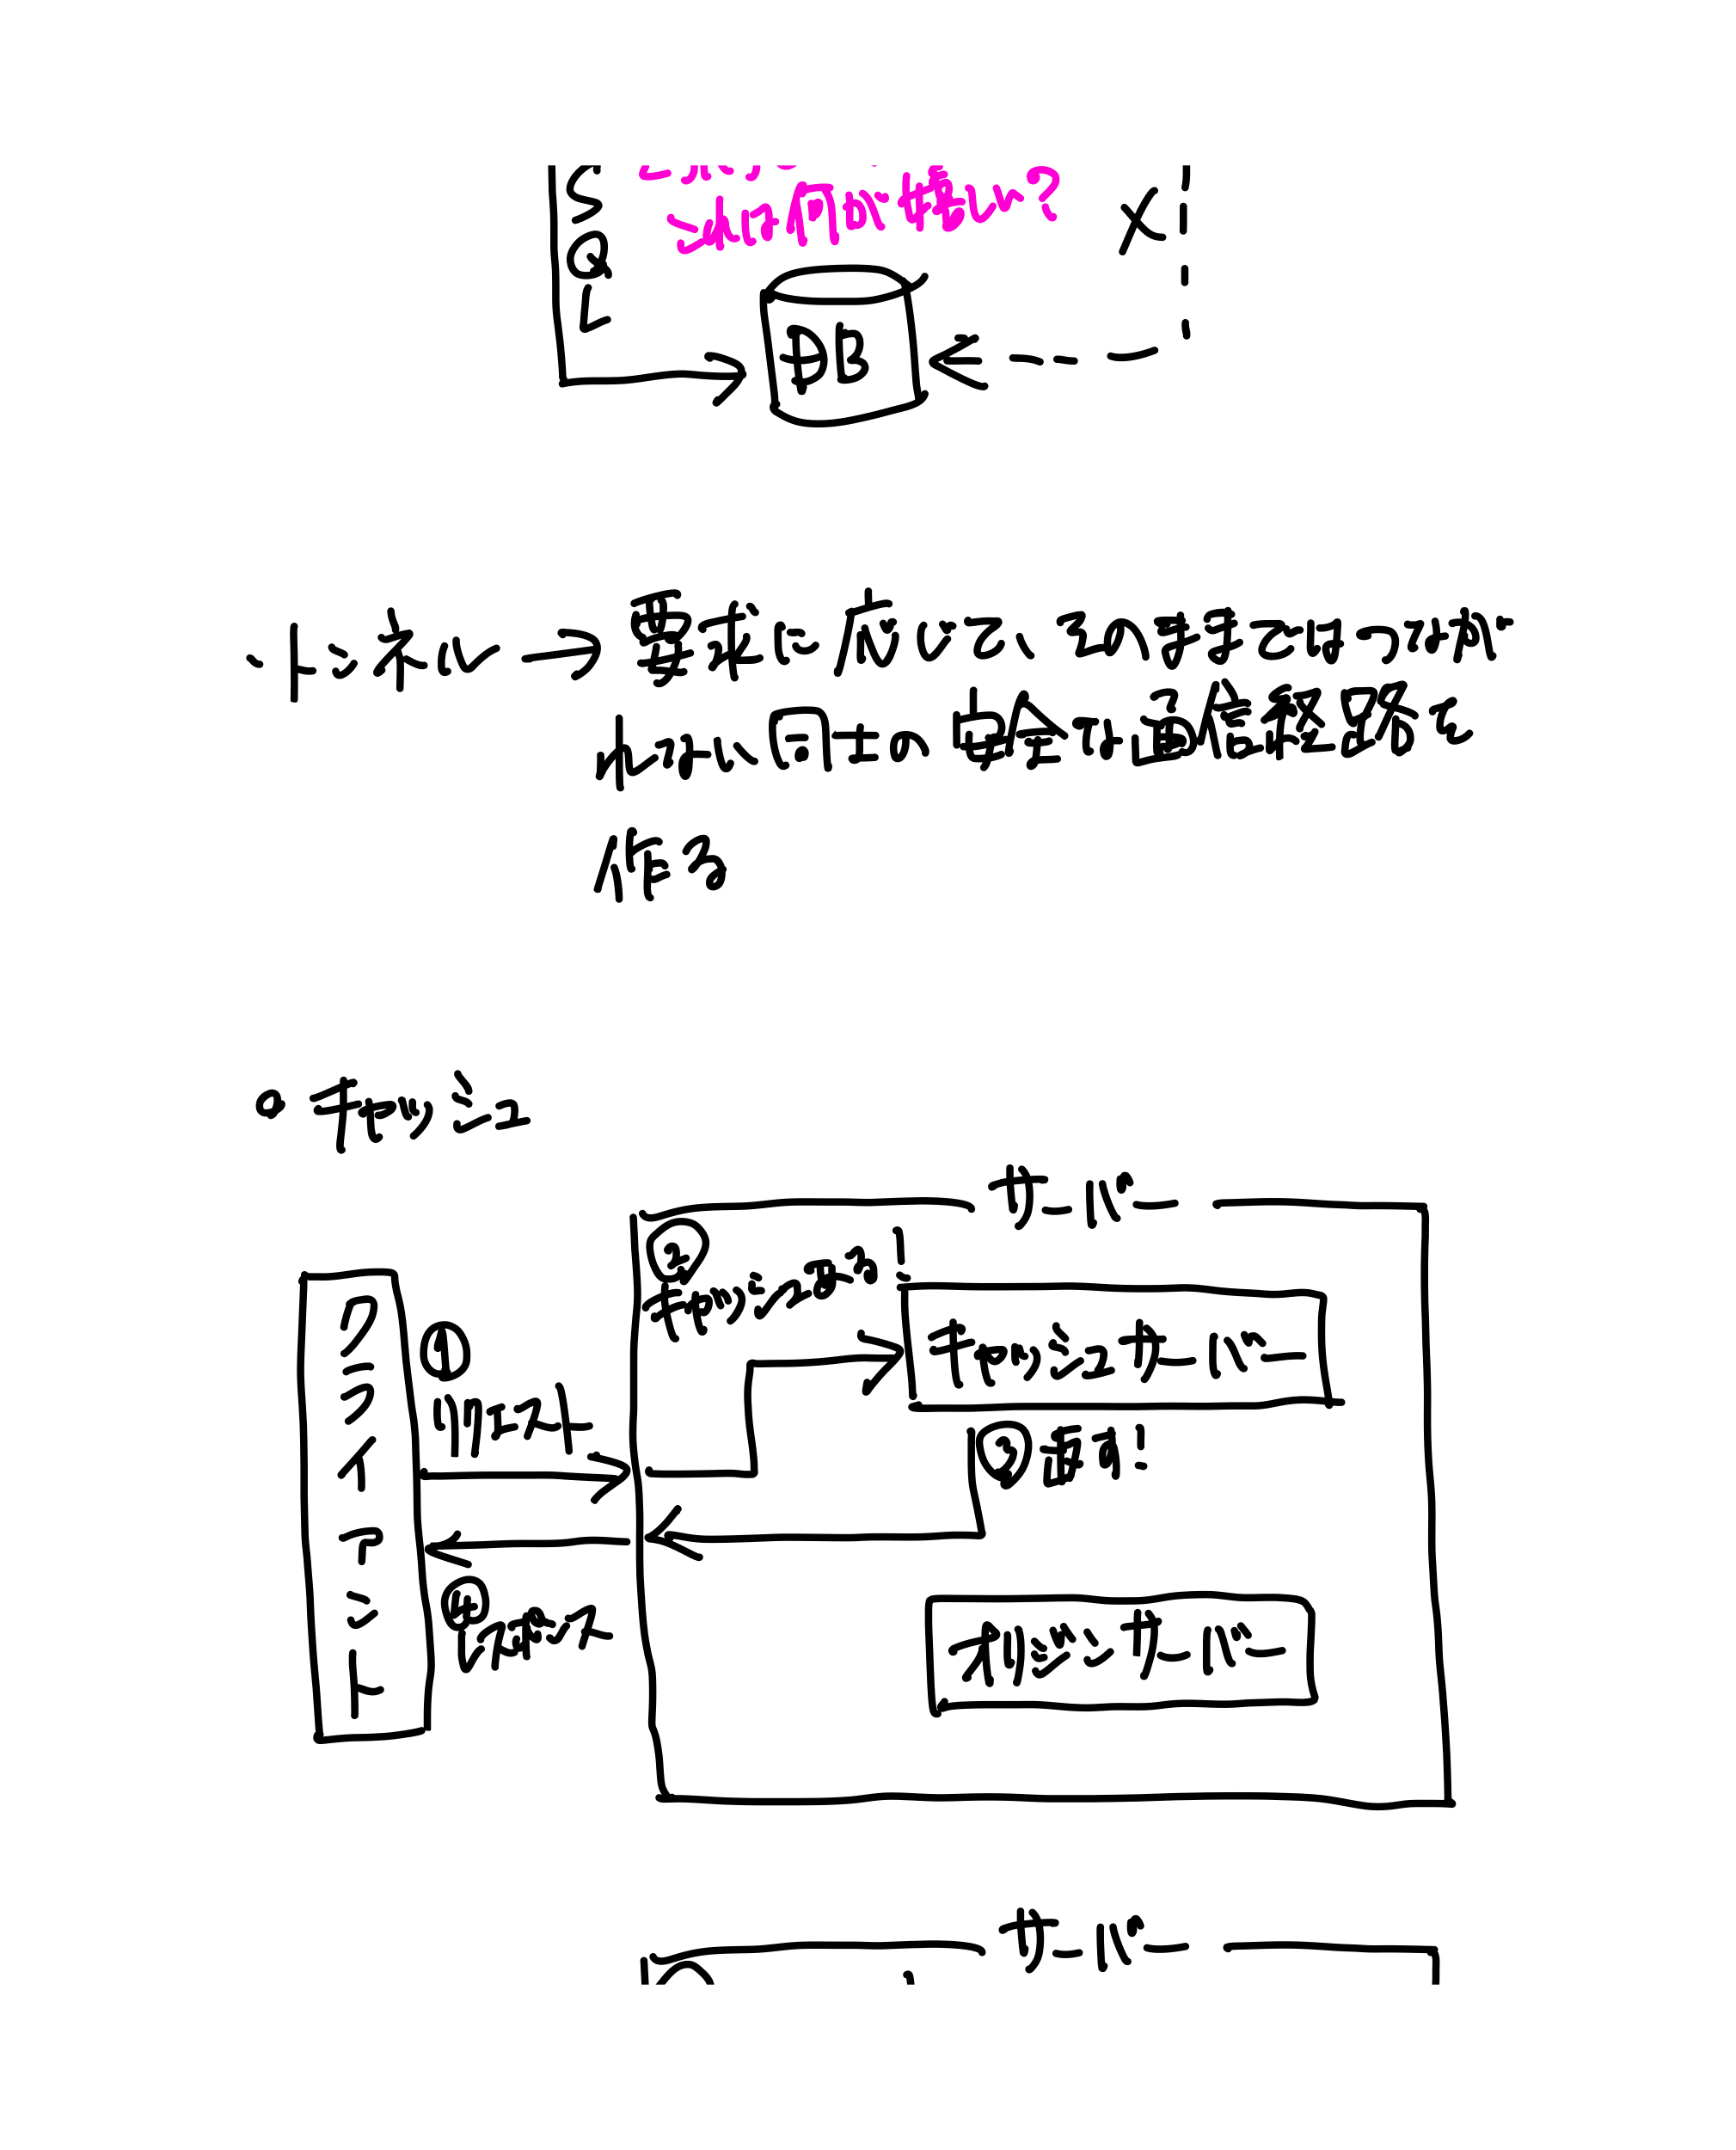
- トンネル → 要求に応じて、そのままでは繋がらない同士の安全な通信経路を作る。
キャッシュ
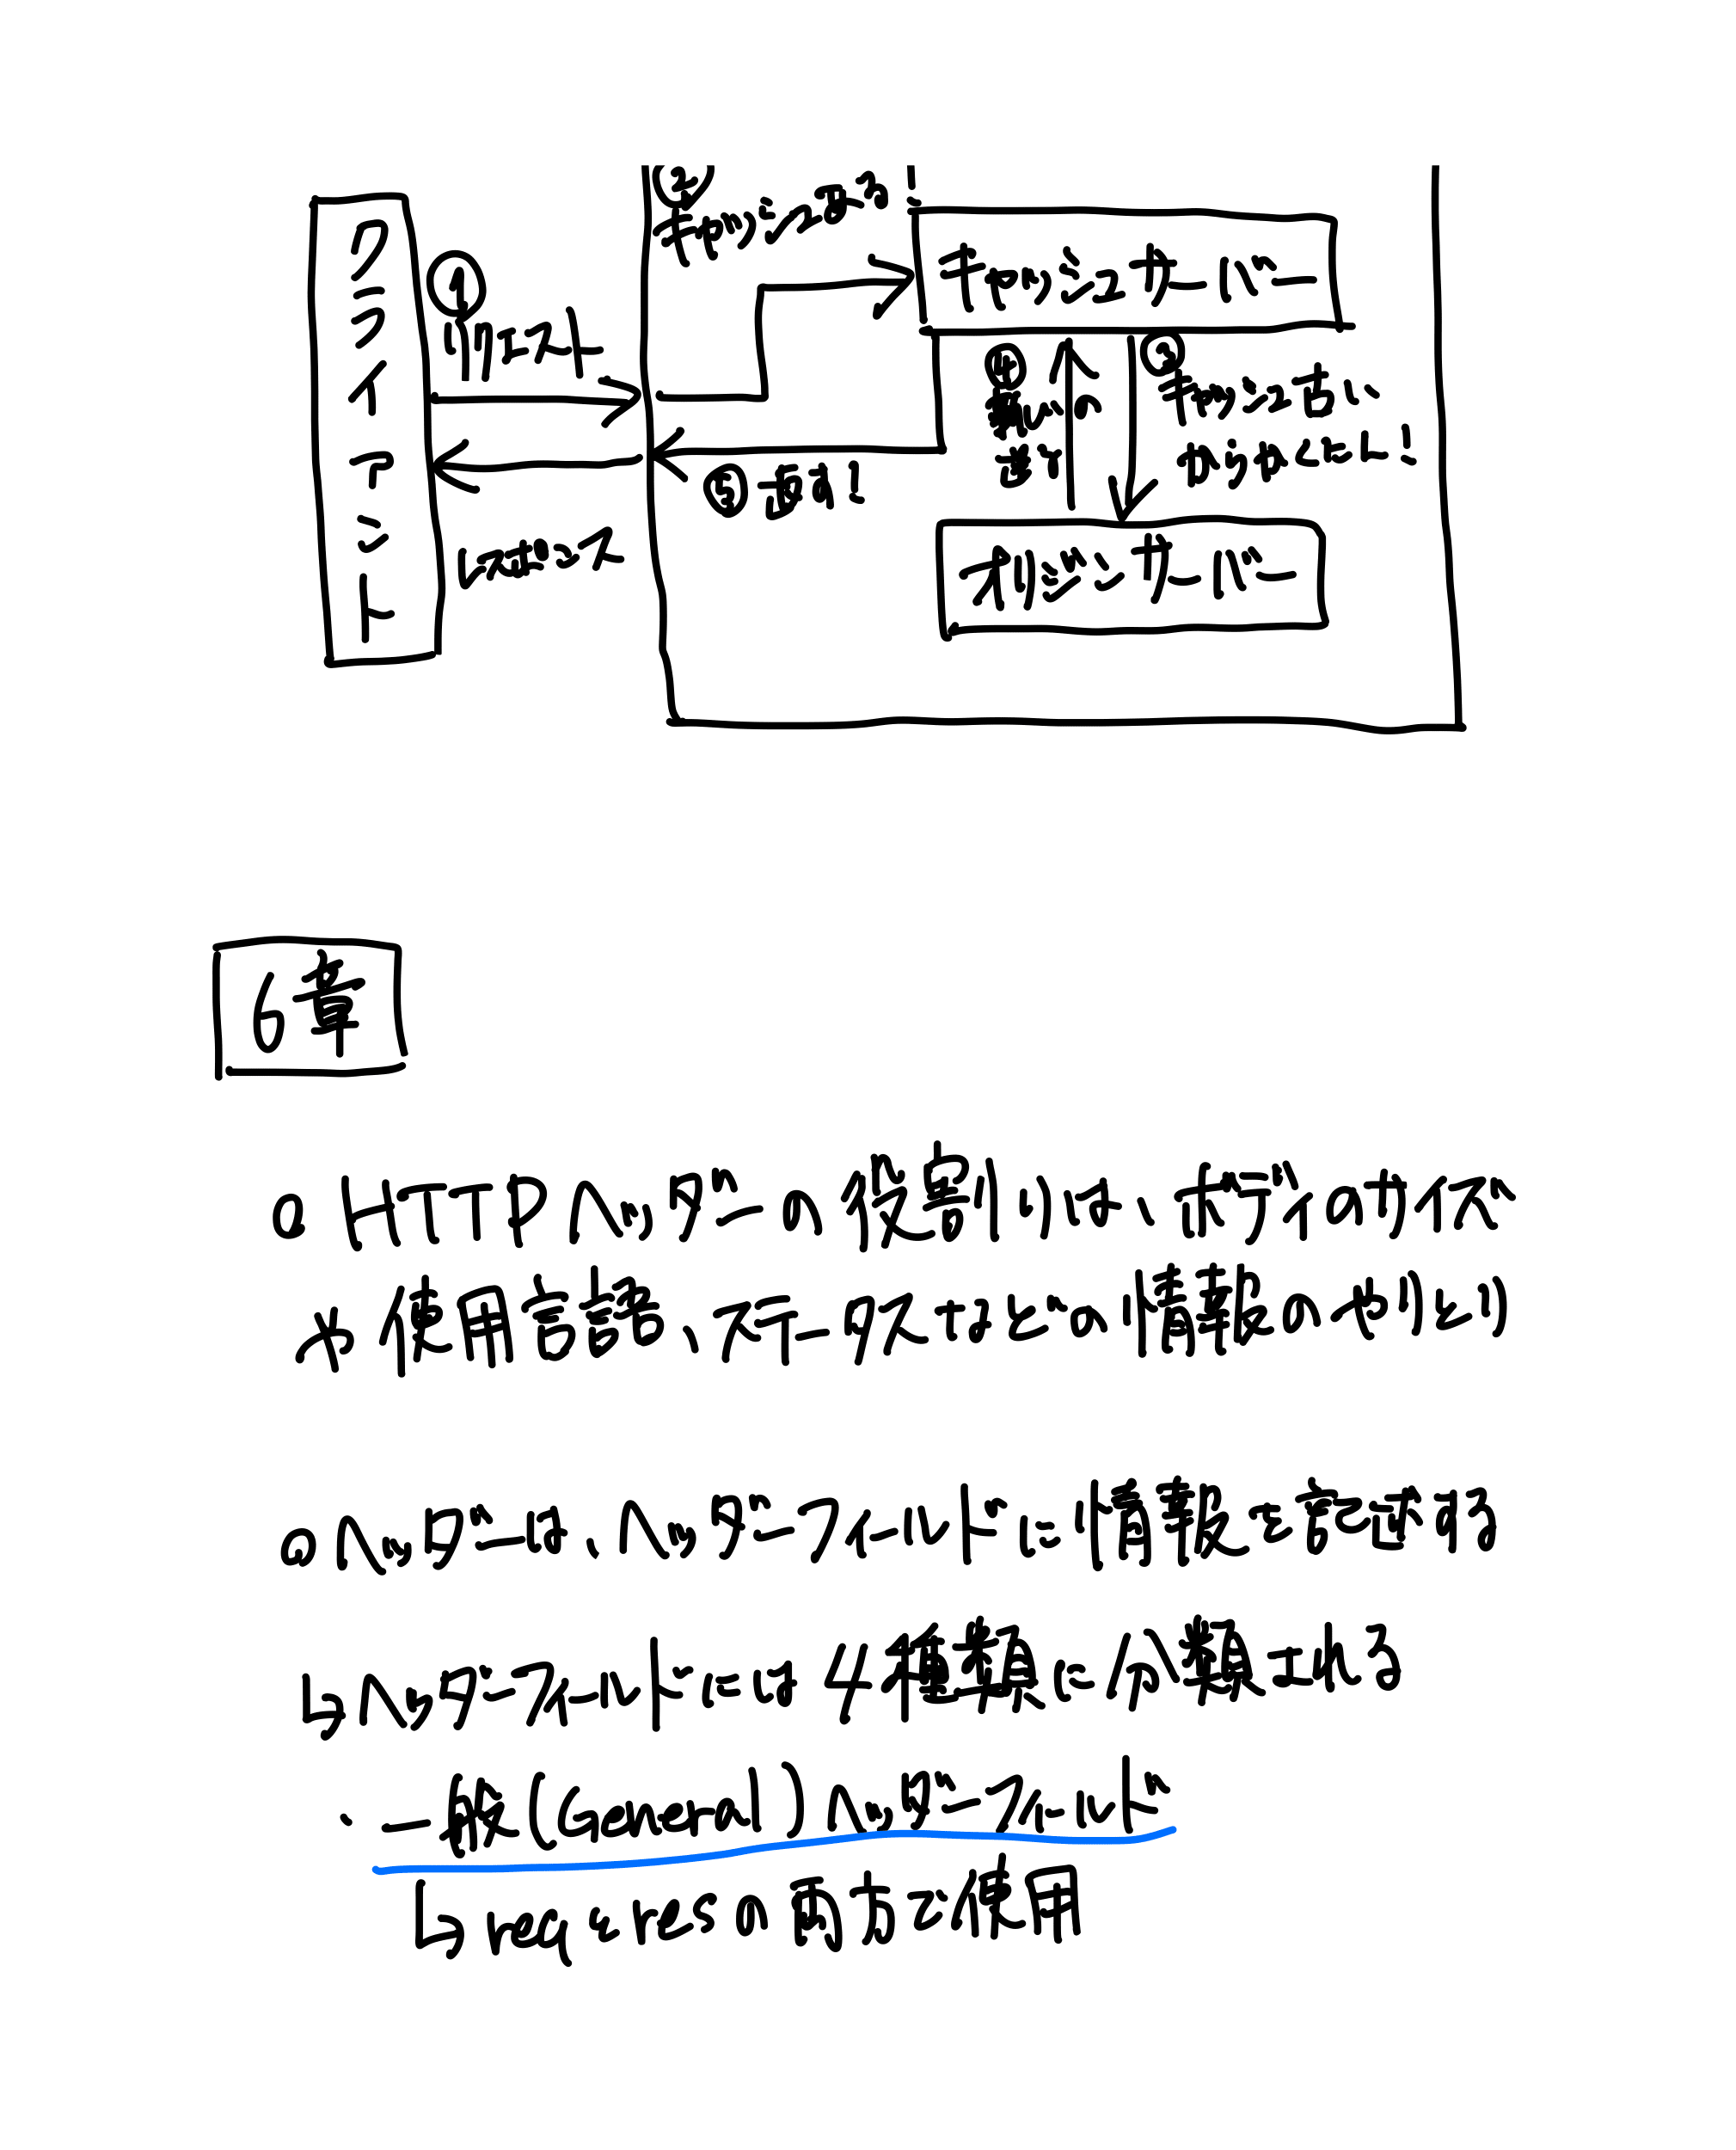
- クライアントのリクエストに対し、キャッシュサーバーにキャッシュがあればそれを返す。
- キャッシュが古い場合はオリジンサーバーに問い合わせて取り直してからレスポンスする。
6章 HTTPヘッダー
- ヘッダーの役割は、ボディのサイズや使用言語、ステータスなどの情報のやりとり。
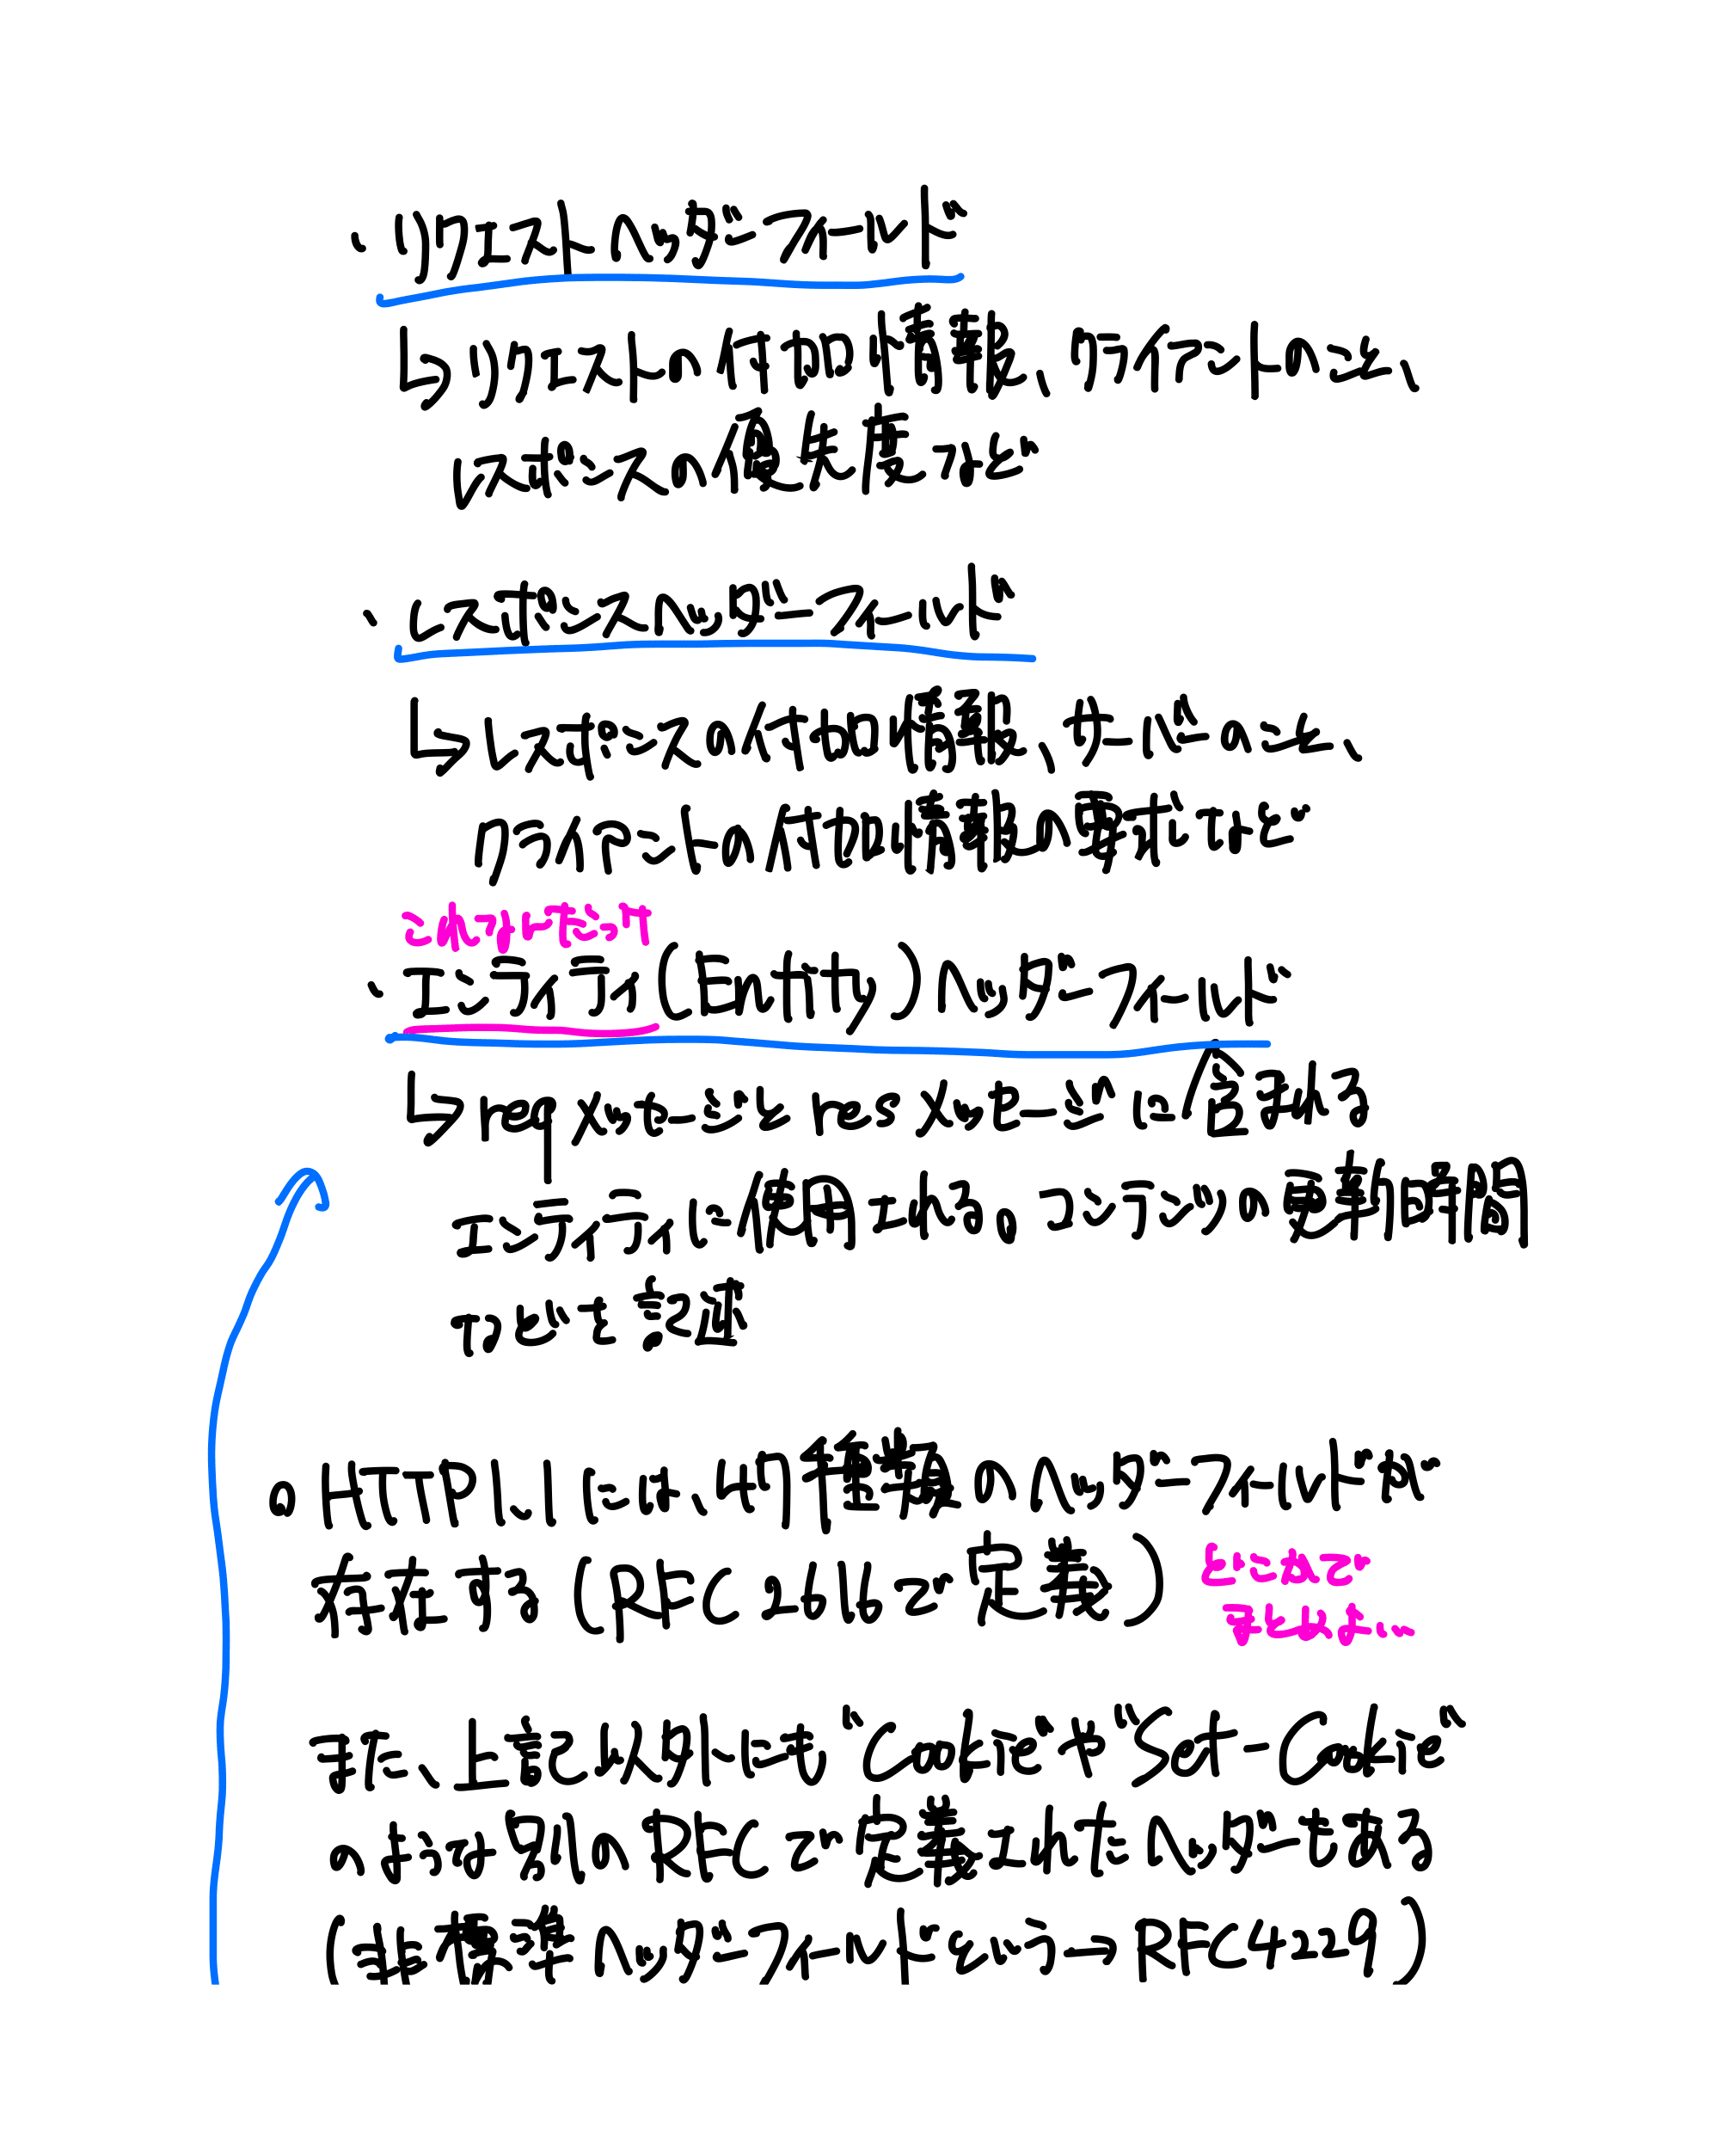
- ヘッダーフィールドは4種類に分類される:
- 一般(General)ヘッダーフィールド → req と res の両方で使用
- リクエストヘッダーフィールド → リクエストの付加情報、クライアントのこと、レスポンスの優先度など
- レスポンスヘッダーフィールド → レスポンスの付加情報、サーバーのこと、クライアントへの付加情報の要求など
- エンティティ(Entity)ヘッダーフィールド → req/res に含まれるエンティティに使用。コンテンツの更新時間などを記述
- HTTP1.1 には 47種類のヘッダーフィールドが存在(RFC 2616 で定義)。ほかに Cookie / Set-Cookie のような別RFC定義の非標準ヘッダーもある(RFC 4229)。
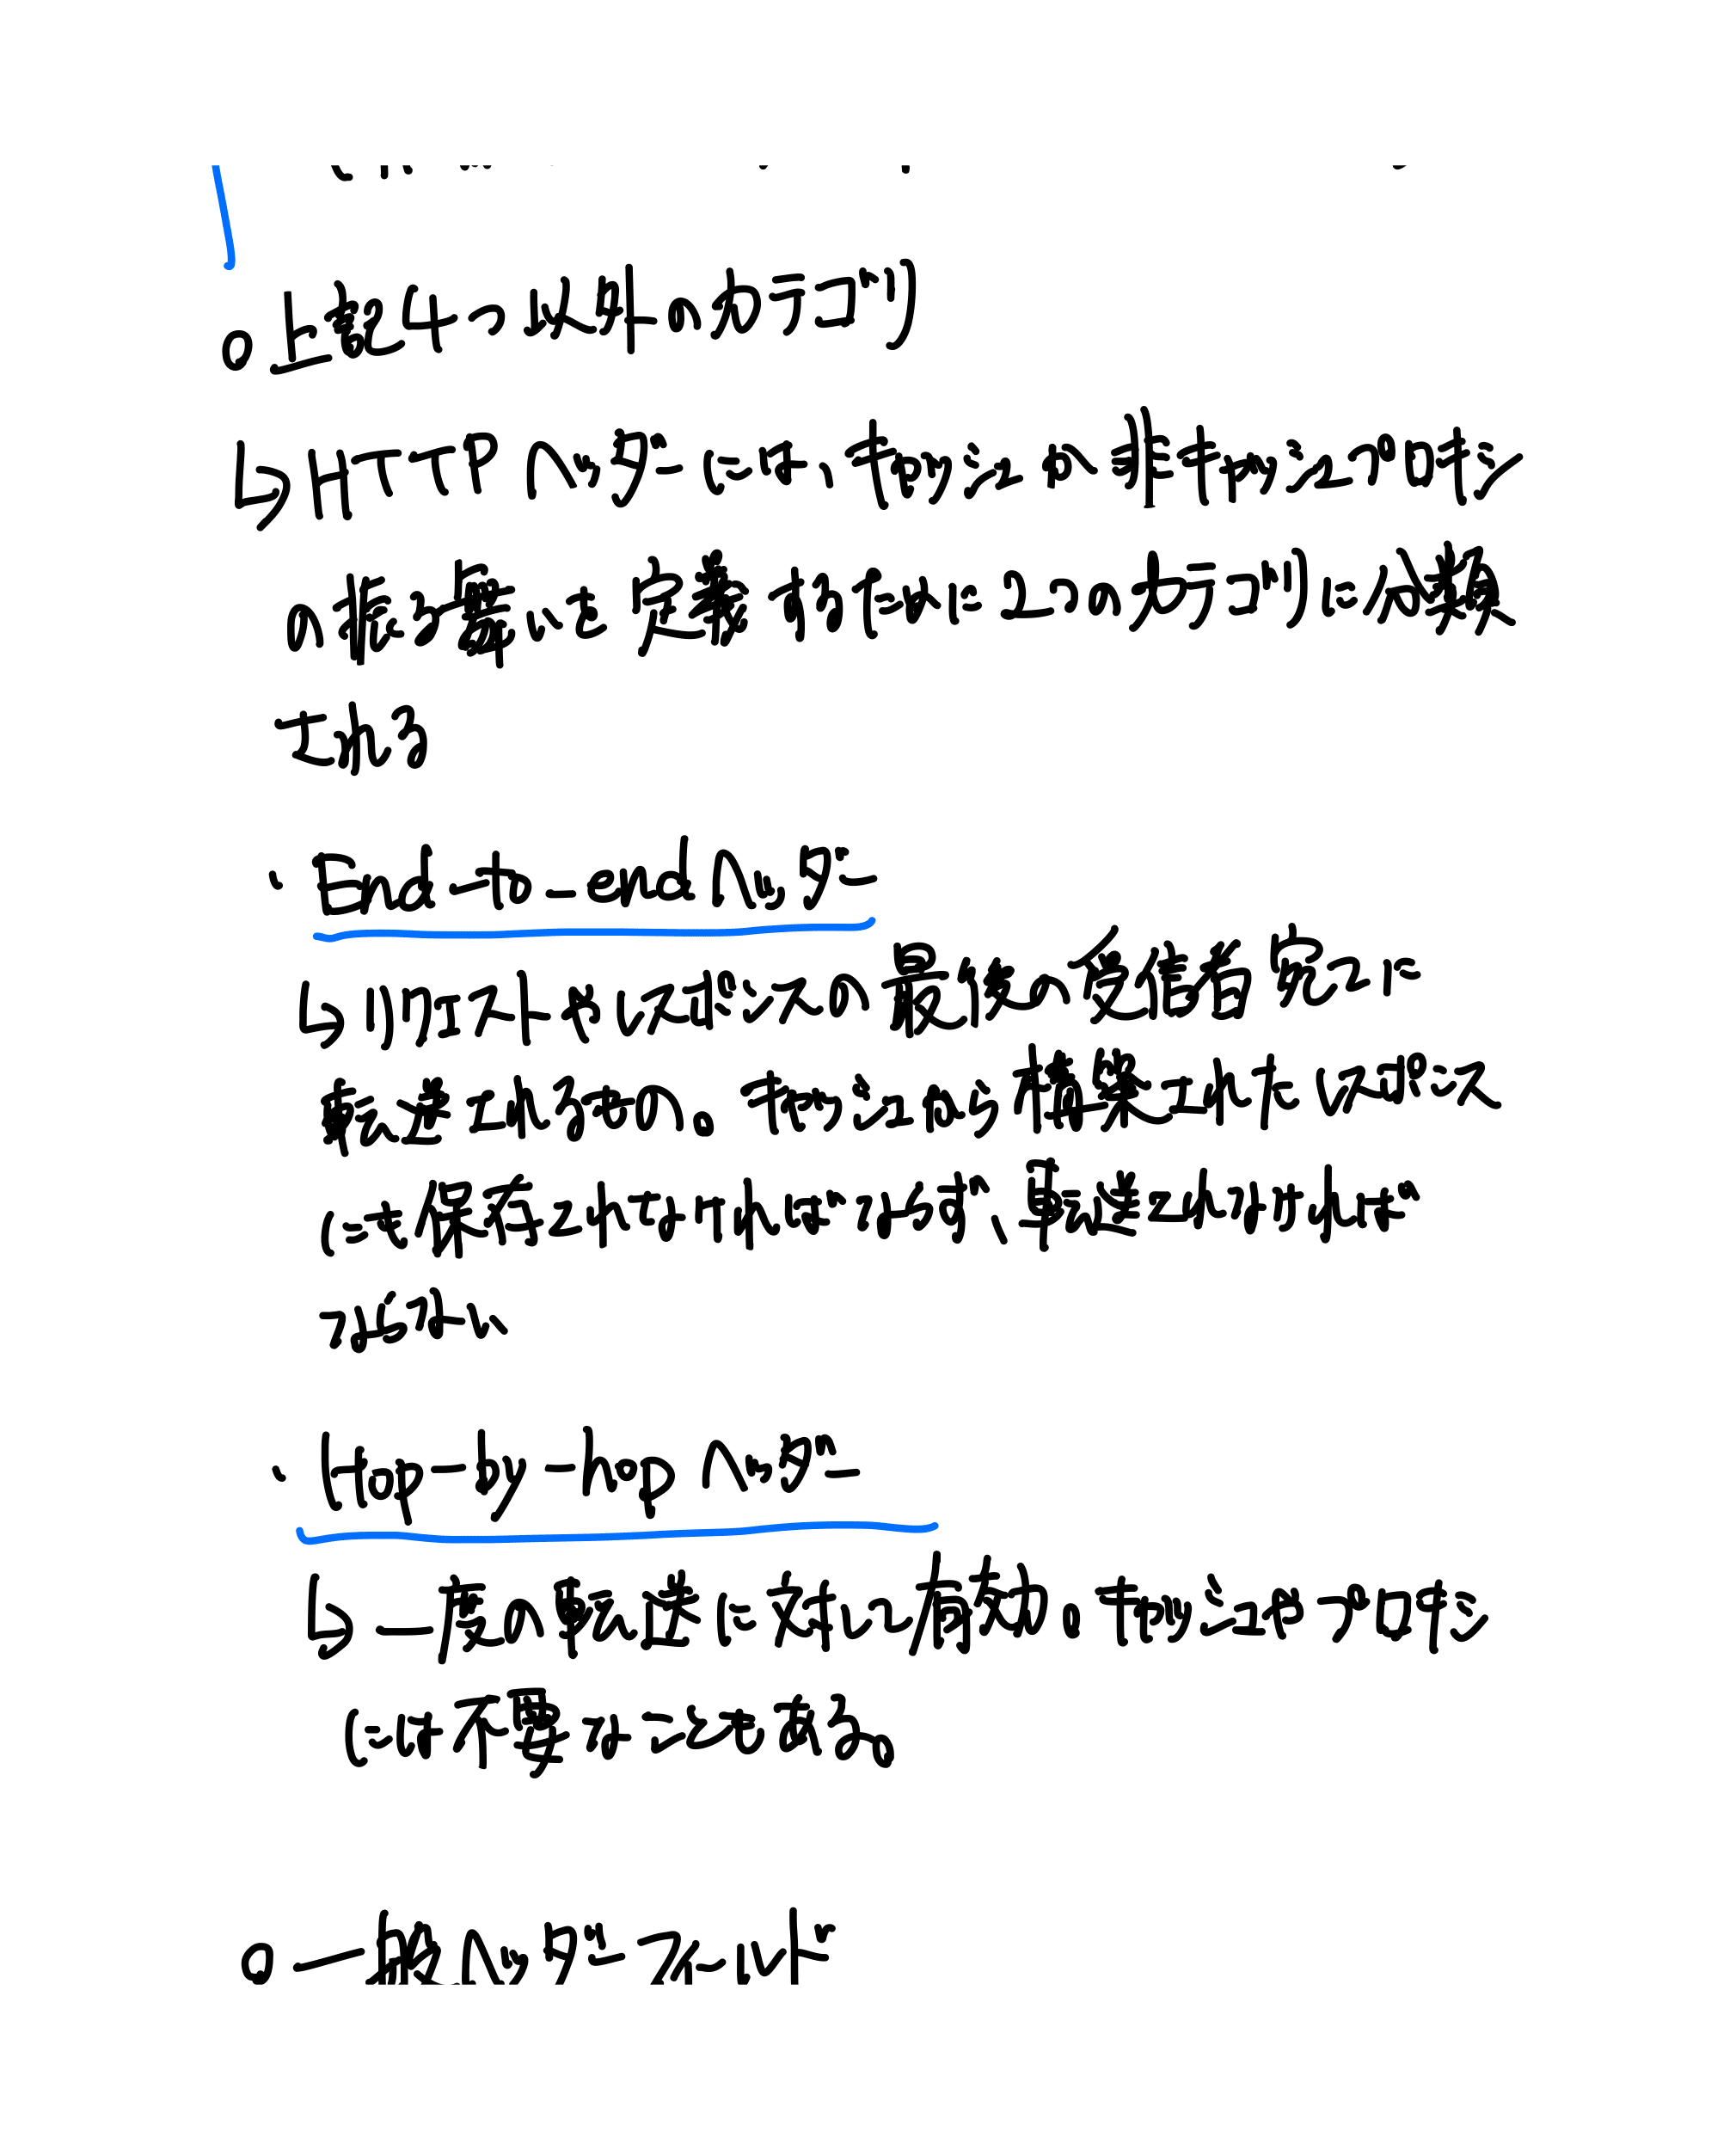
- キャッシュやプロキシの振る舞いの観点で2カテゴリにも分類される:
- End-to-end ヘッダー → 最後の受信者宛に転送される。キャッシュから構築したレスポンスにも保存・転送されなければならない。
- Hop-by-hop ヘッダー → 一度の転送に対し有効。キャッシュやプロキシには不要なこともある。
一般ヘッダーフィールド
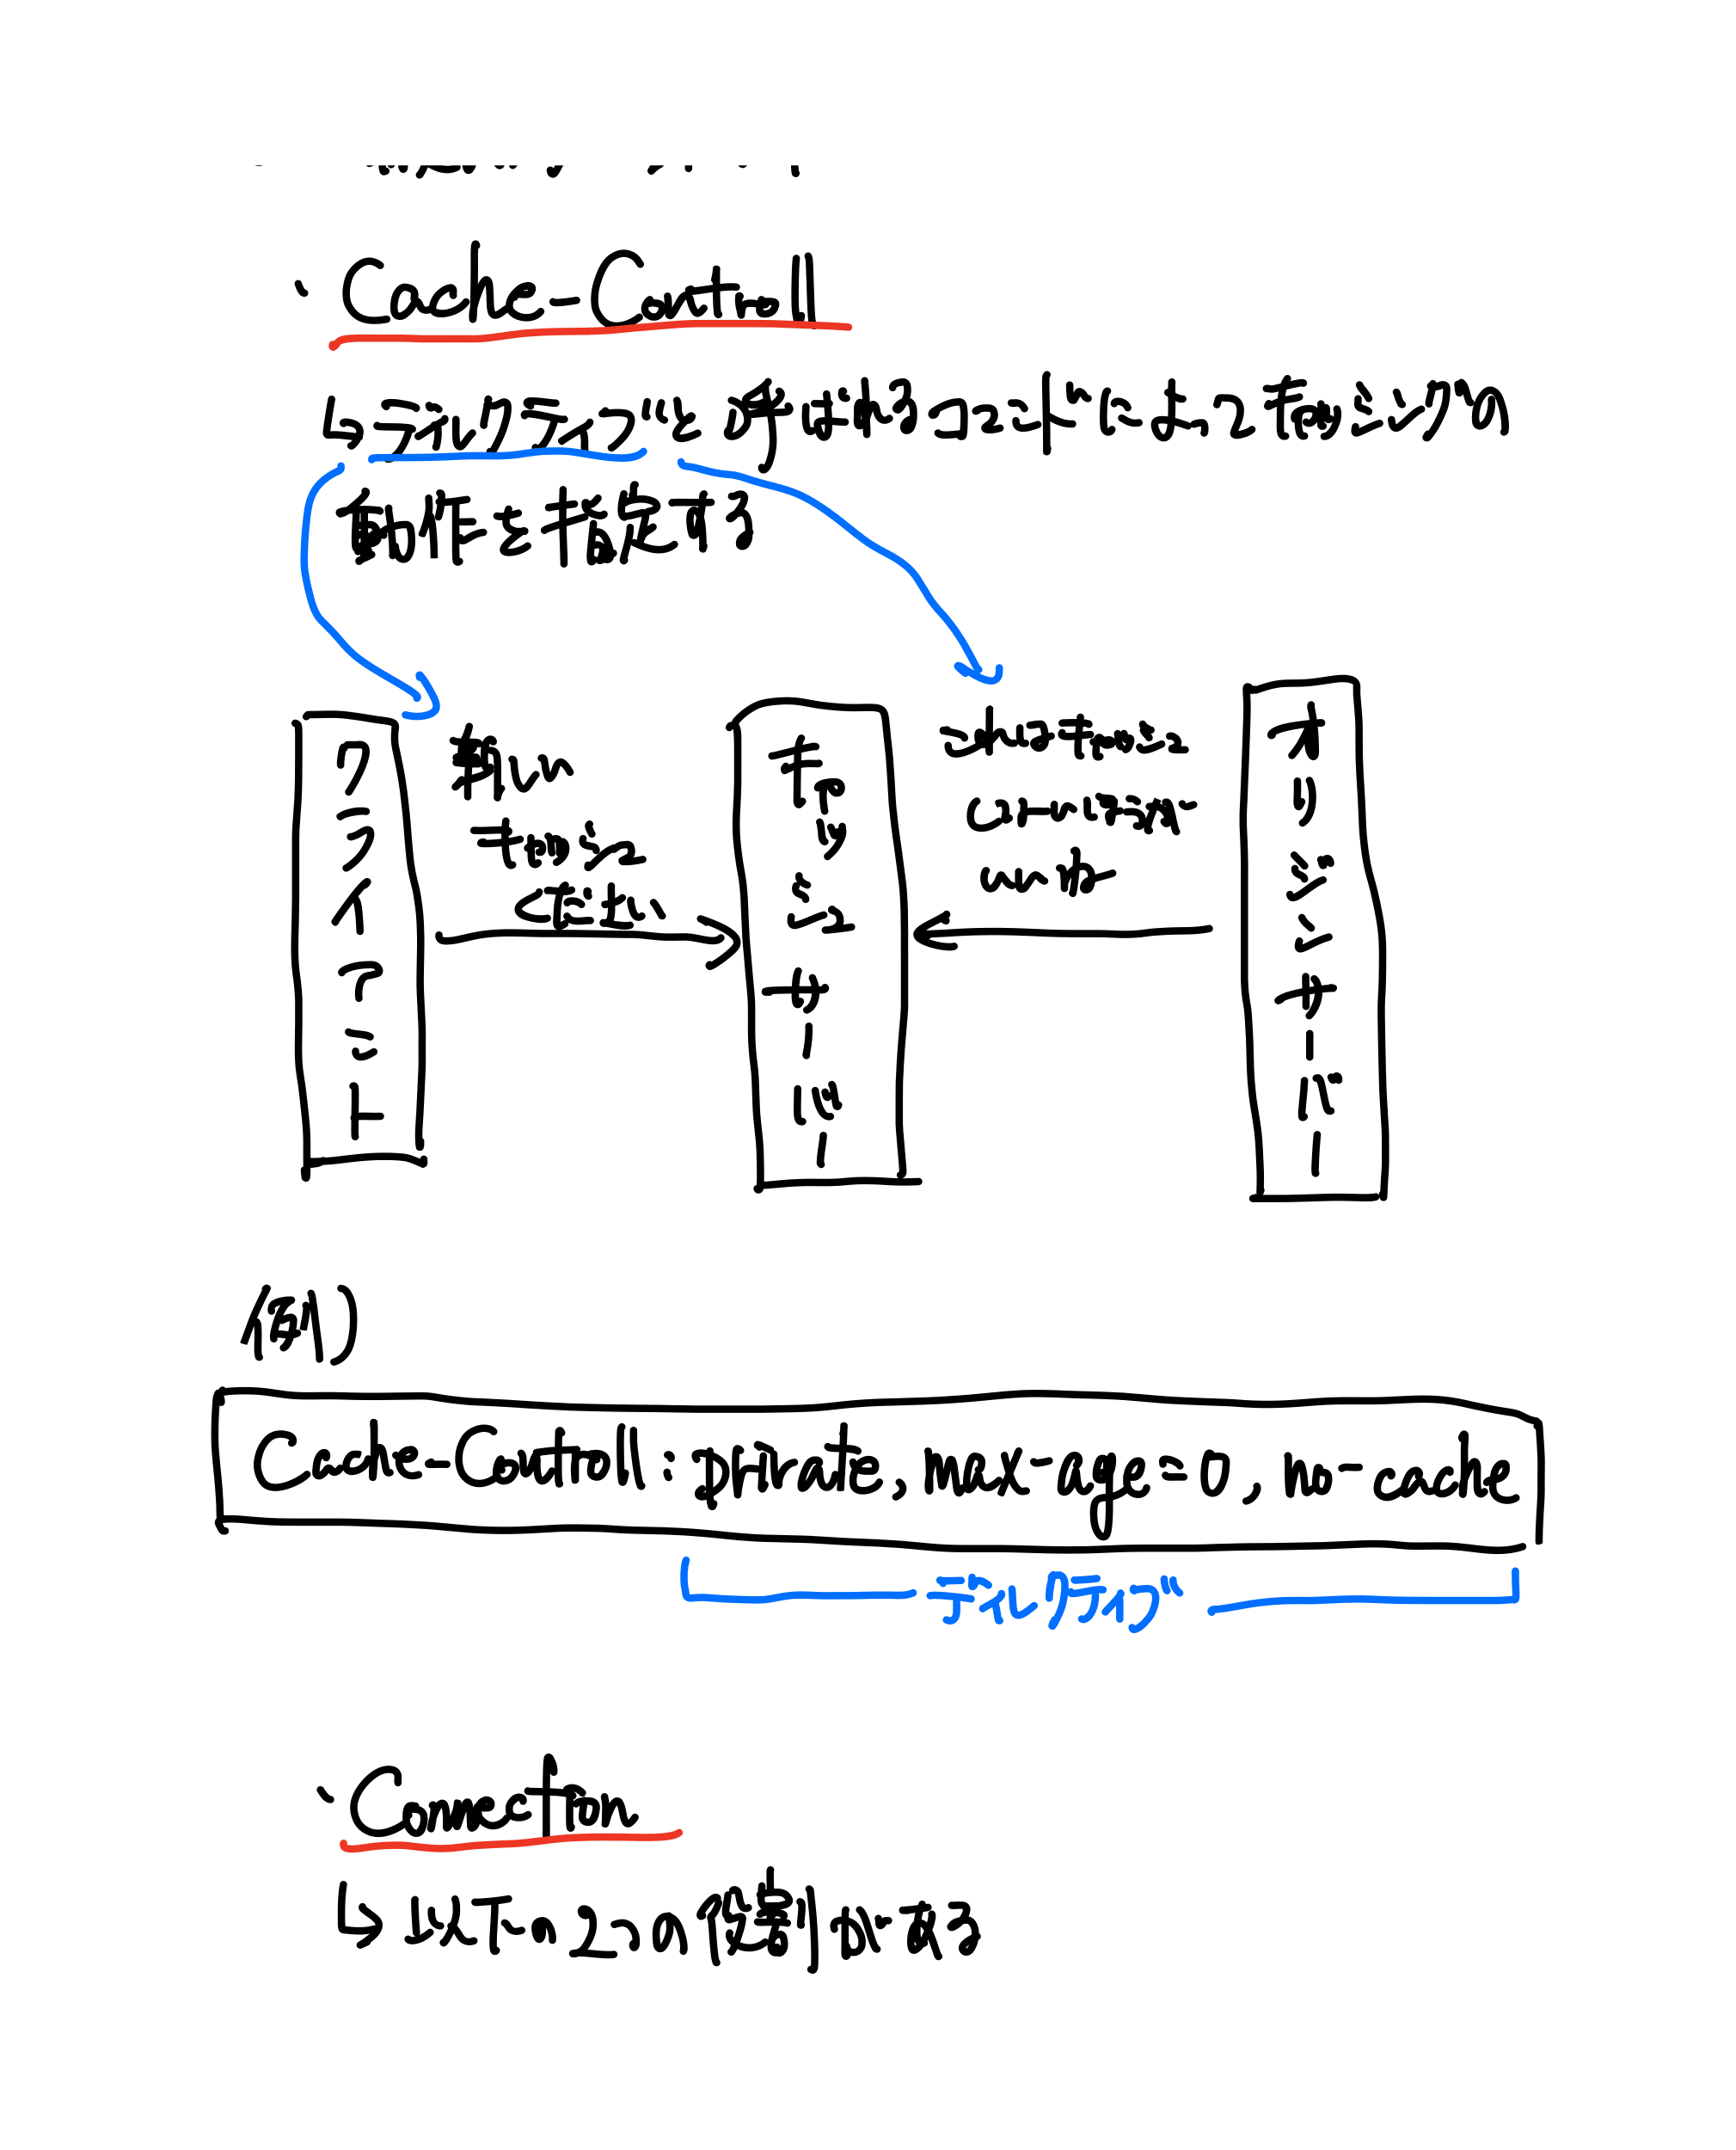
- Cache-Control → ディレクティブと呼ばれるコマンドでキャッシングの動作を指定。例)
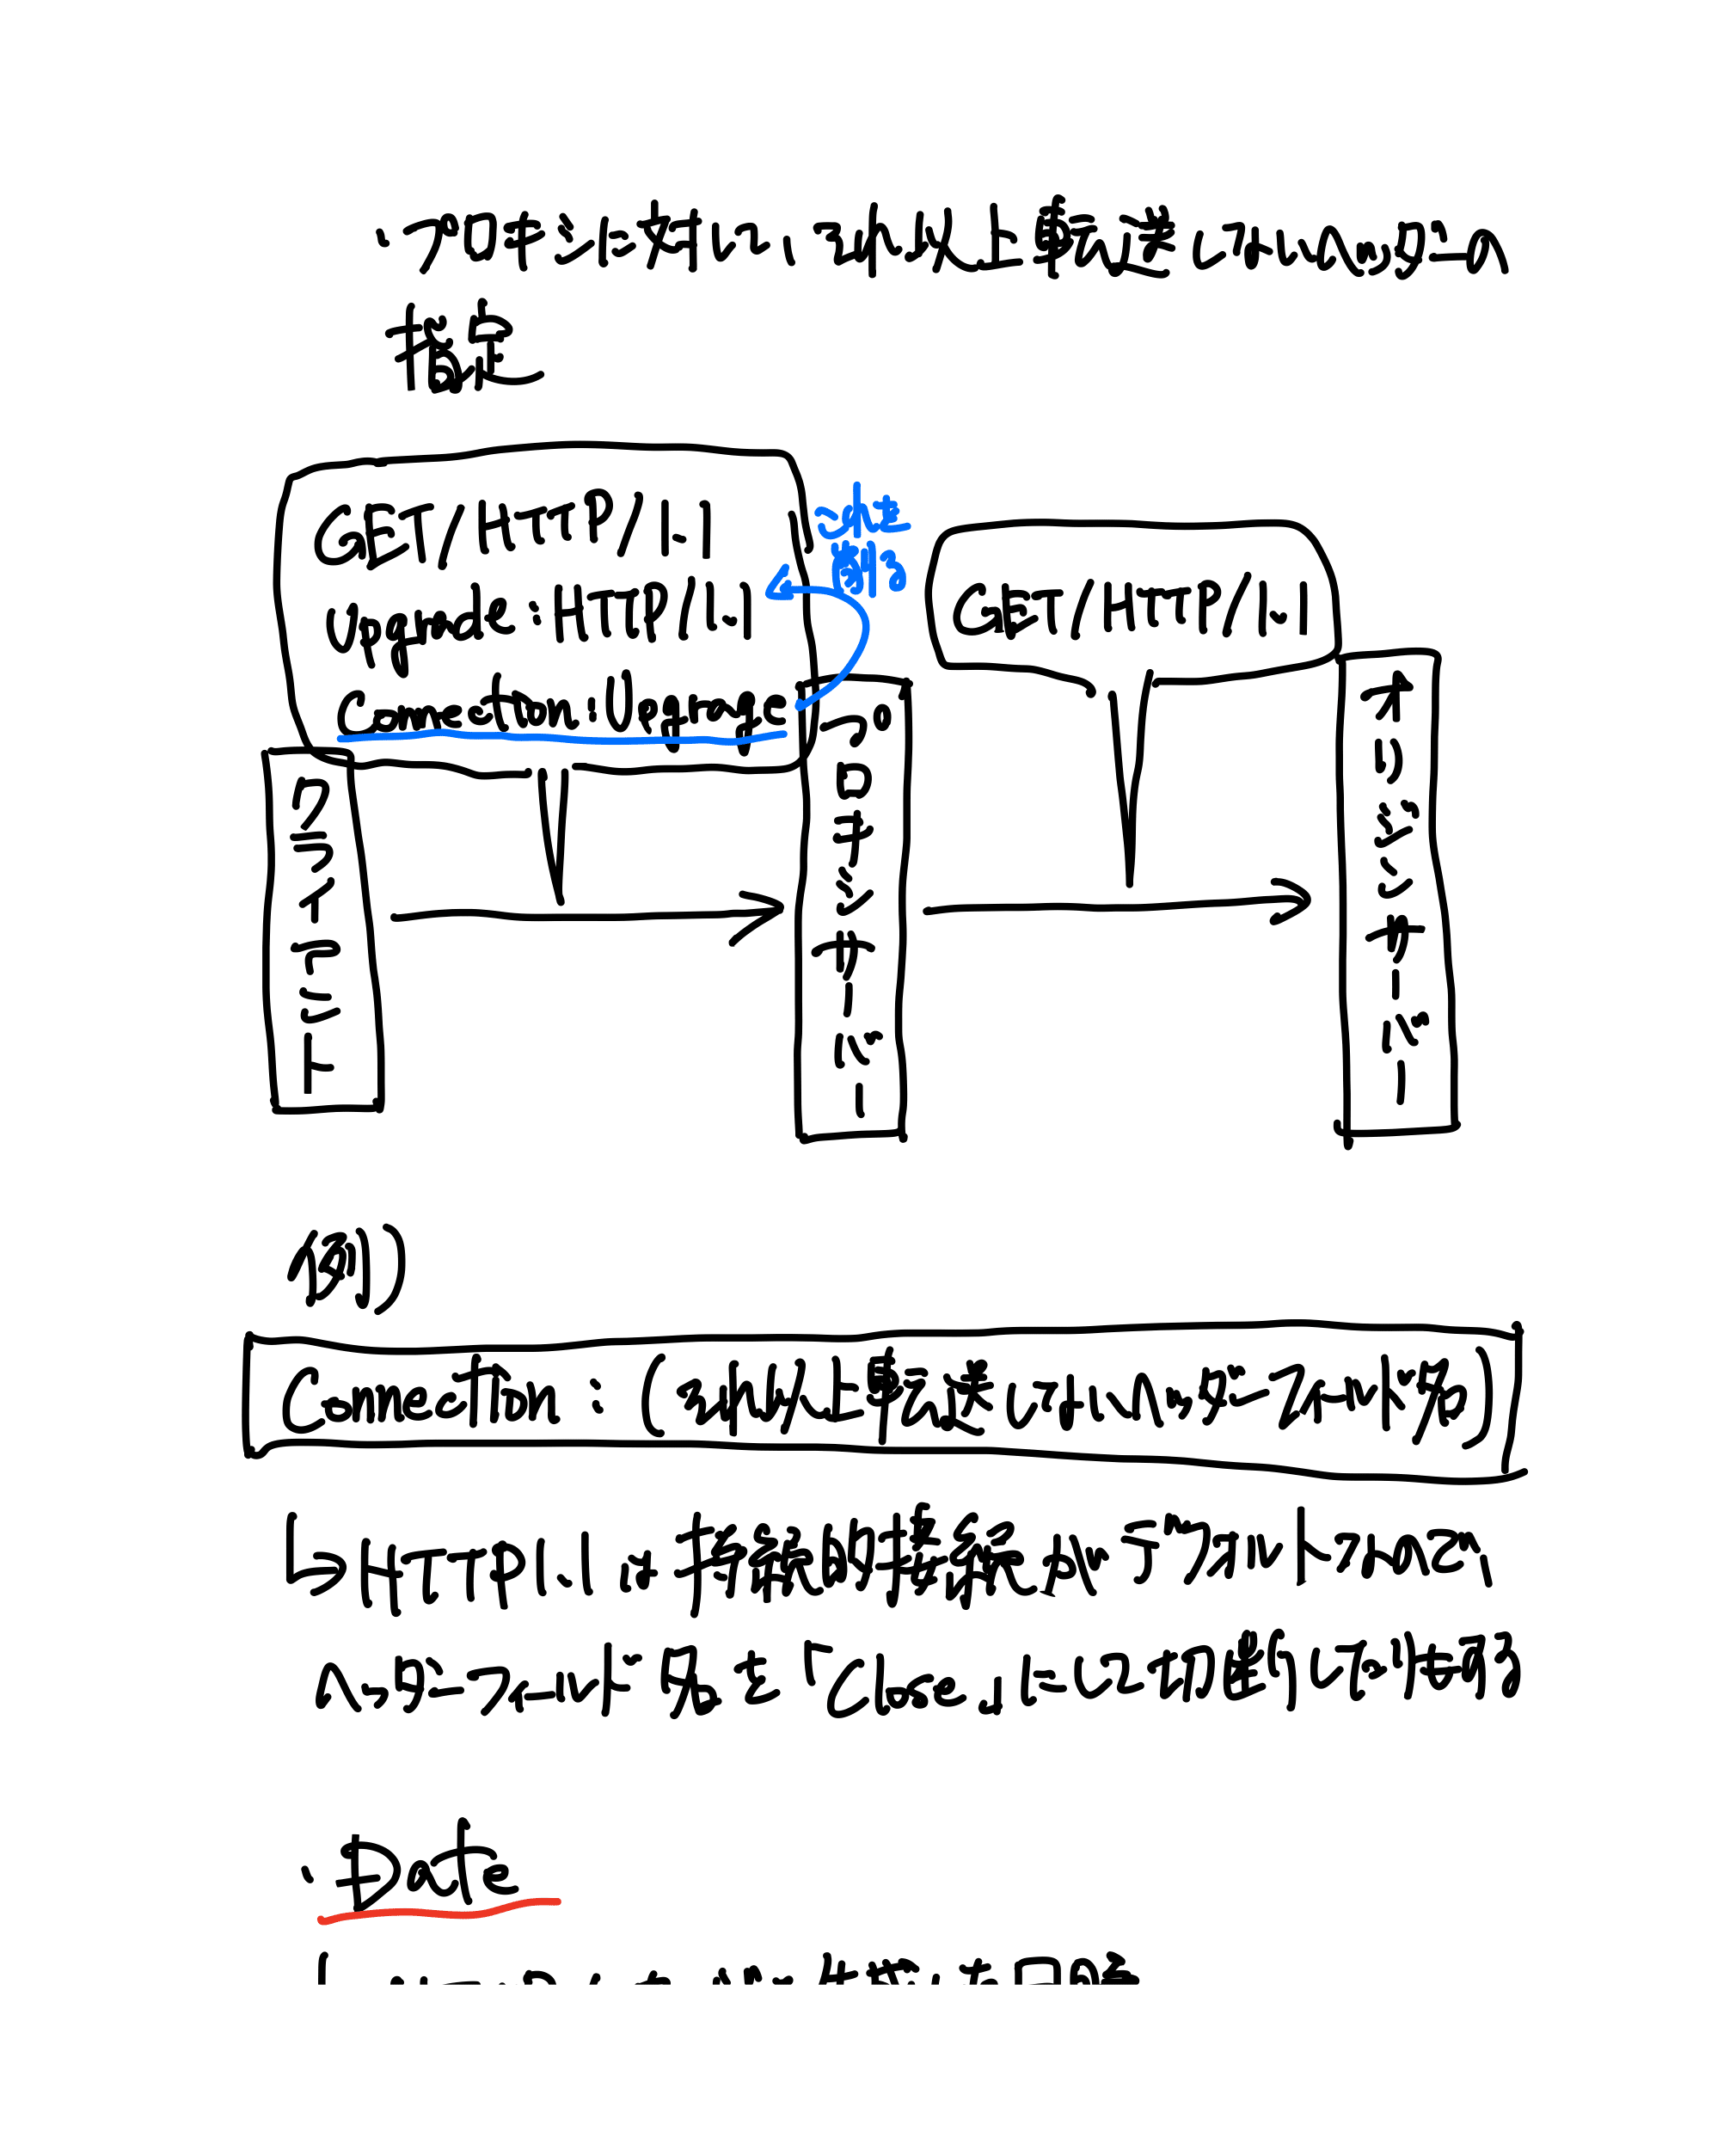
Cache-Control: private, max-age=0, no-cache - Connection → ①プロキシに対しそれ以上転送しないヘッダーの指定、②
Closeにして持続的接続を切断する(HTTP1.1は持続的接続がデフォルト)。 - Date → HTTPメッセージを生成した日時。
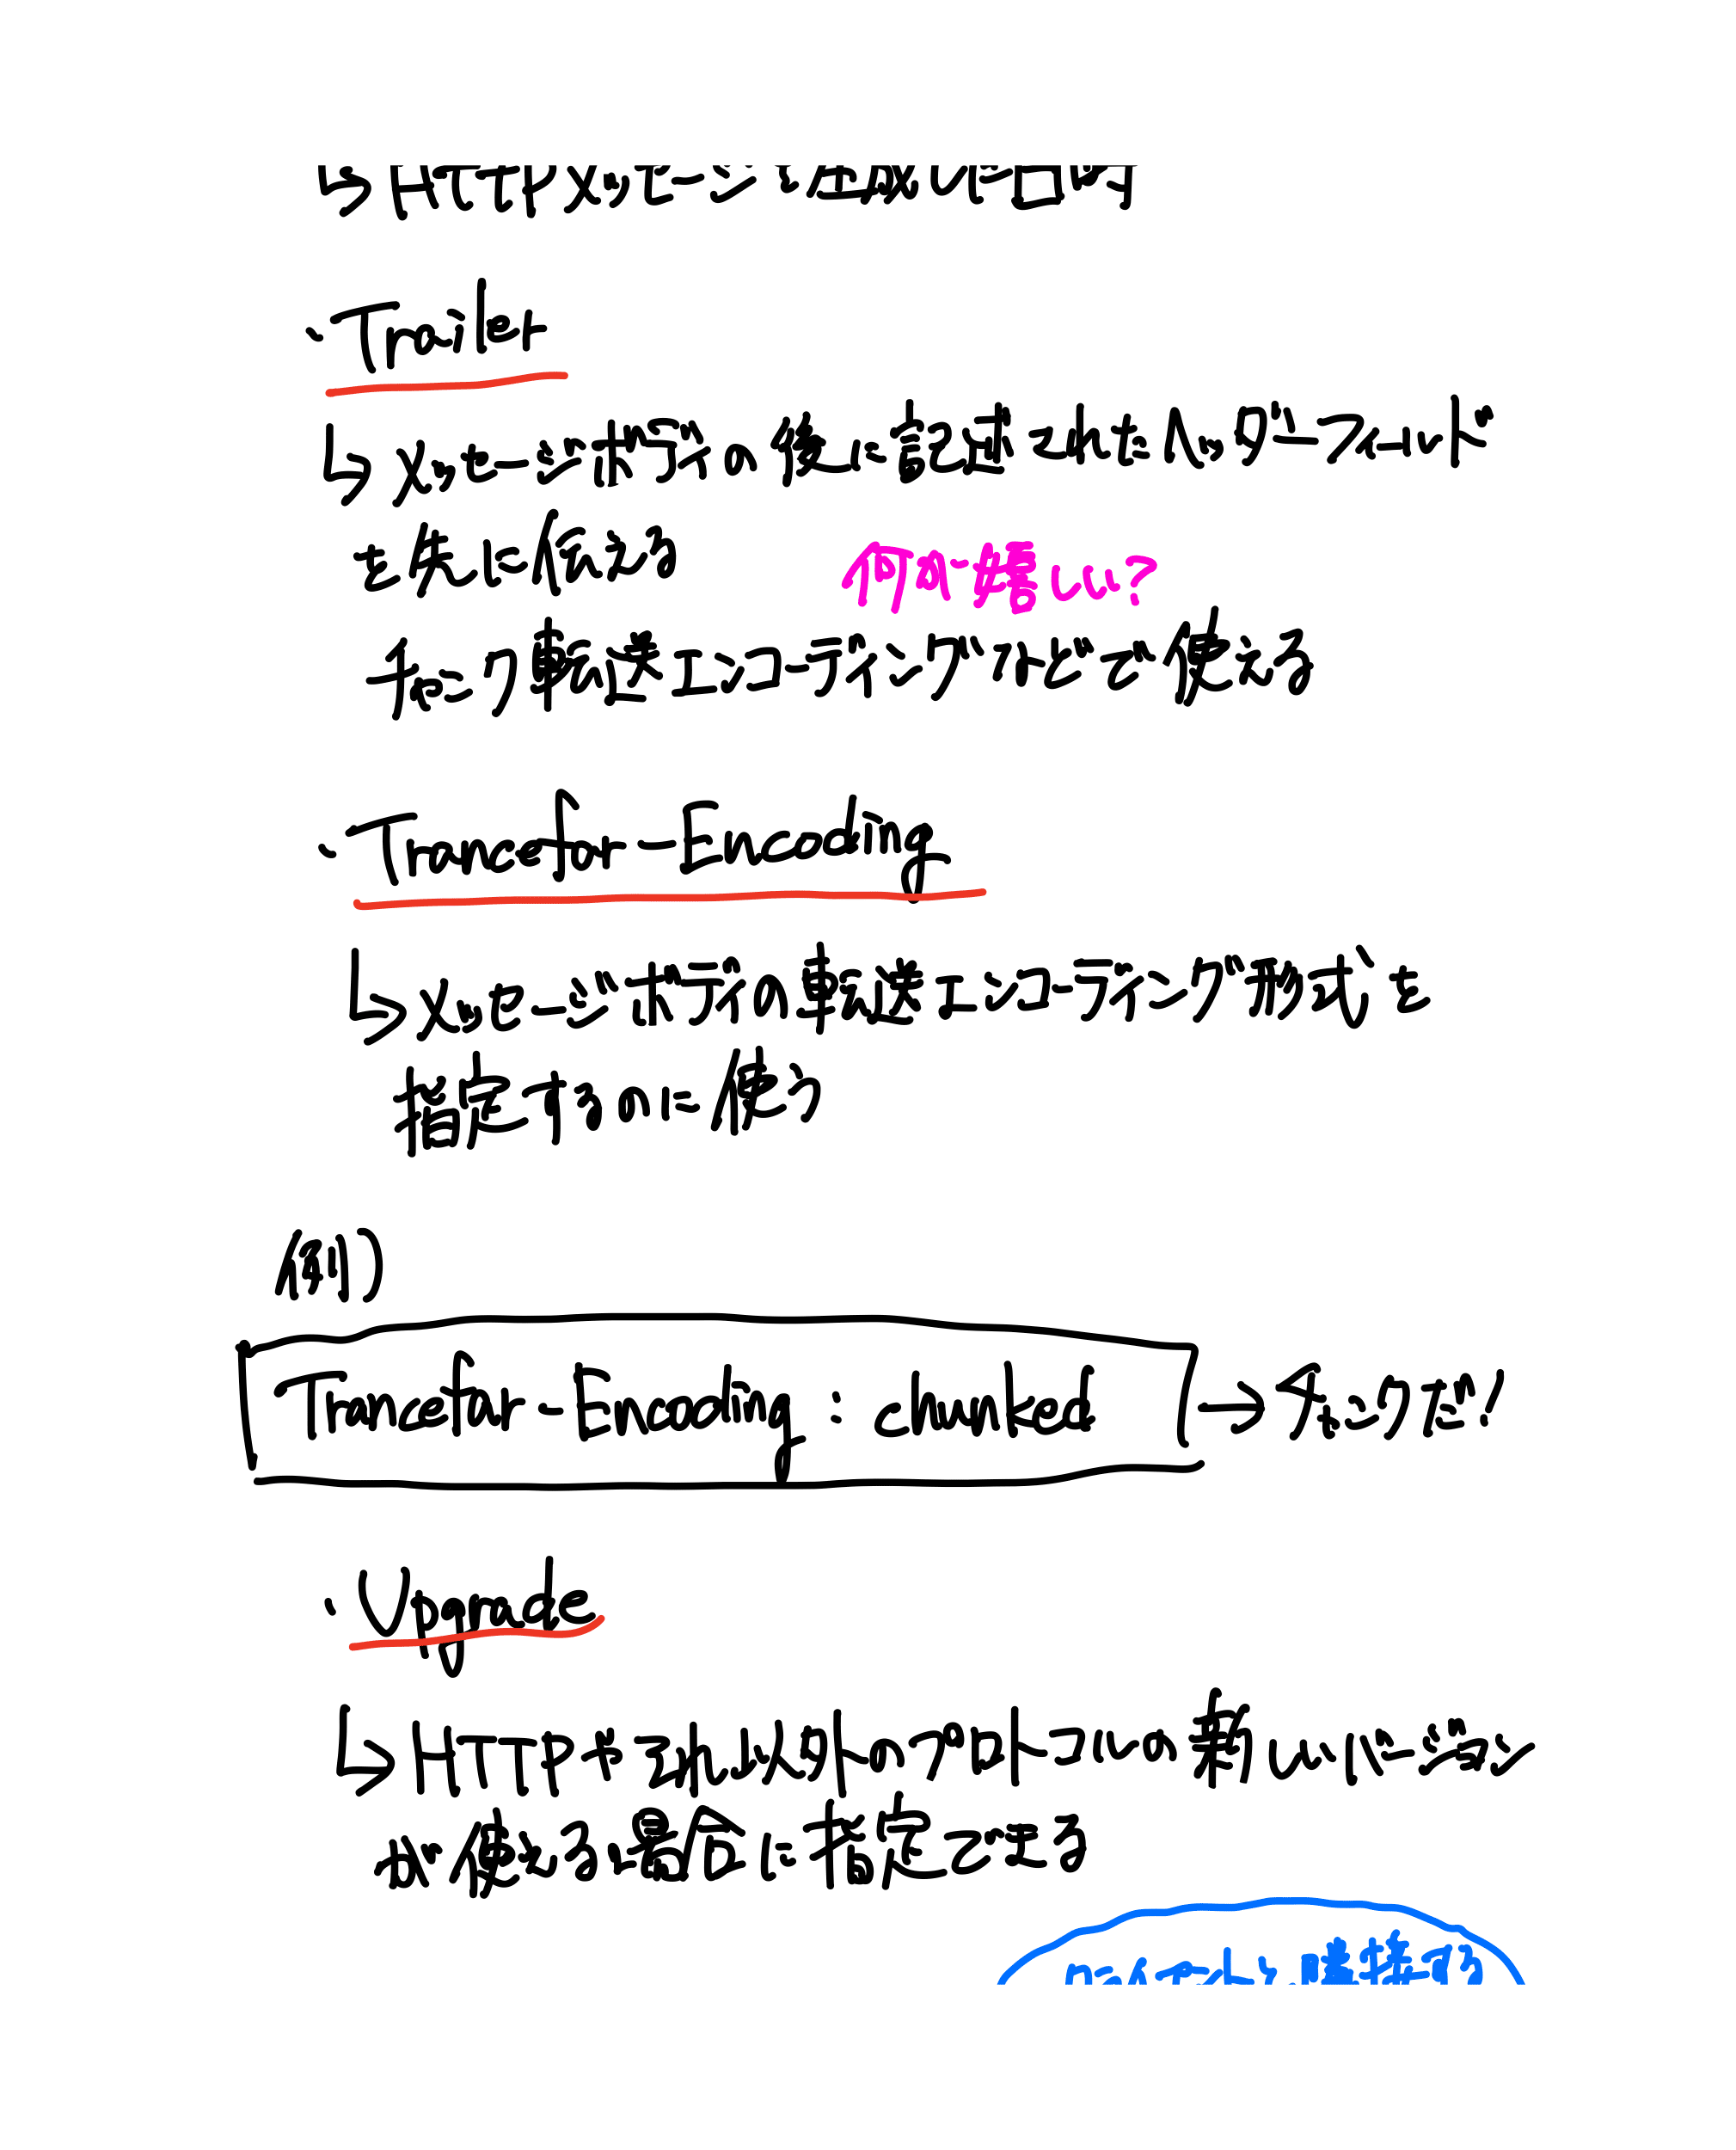
- Trailer → メッセージボディの後に記述されたヘッダーフィールドを先に伝える(チャンク転送などで使える)。
- Transfer-Encoding → メッセージボディの転送エンコーディング形式を指定。例)
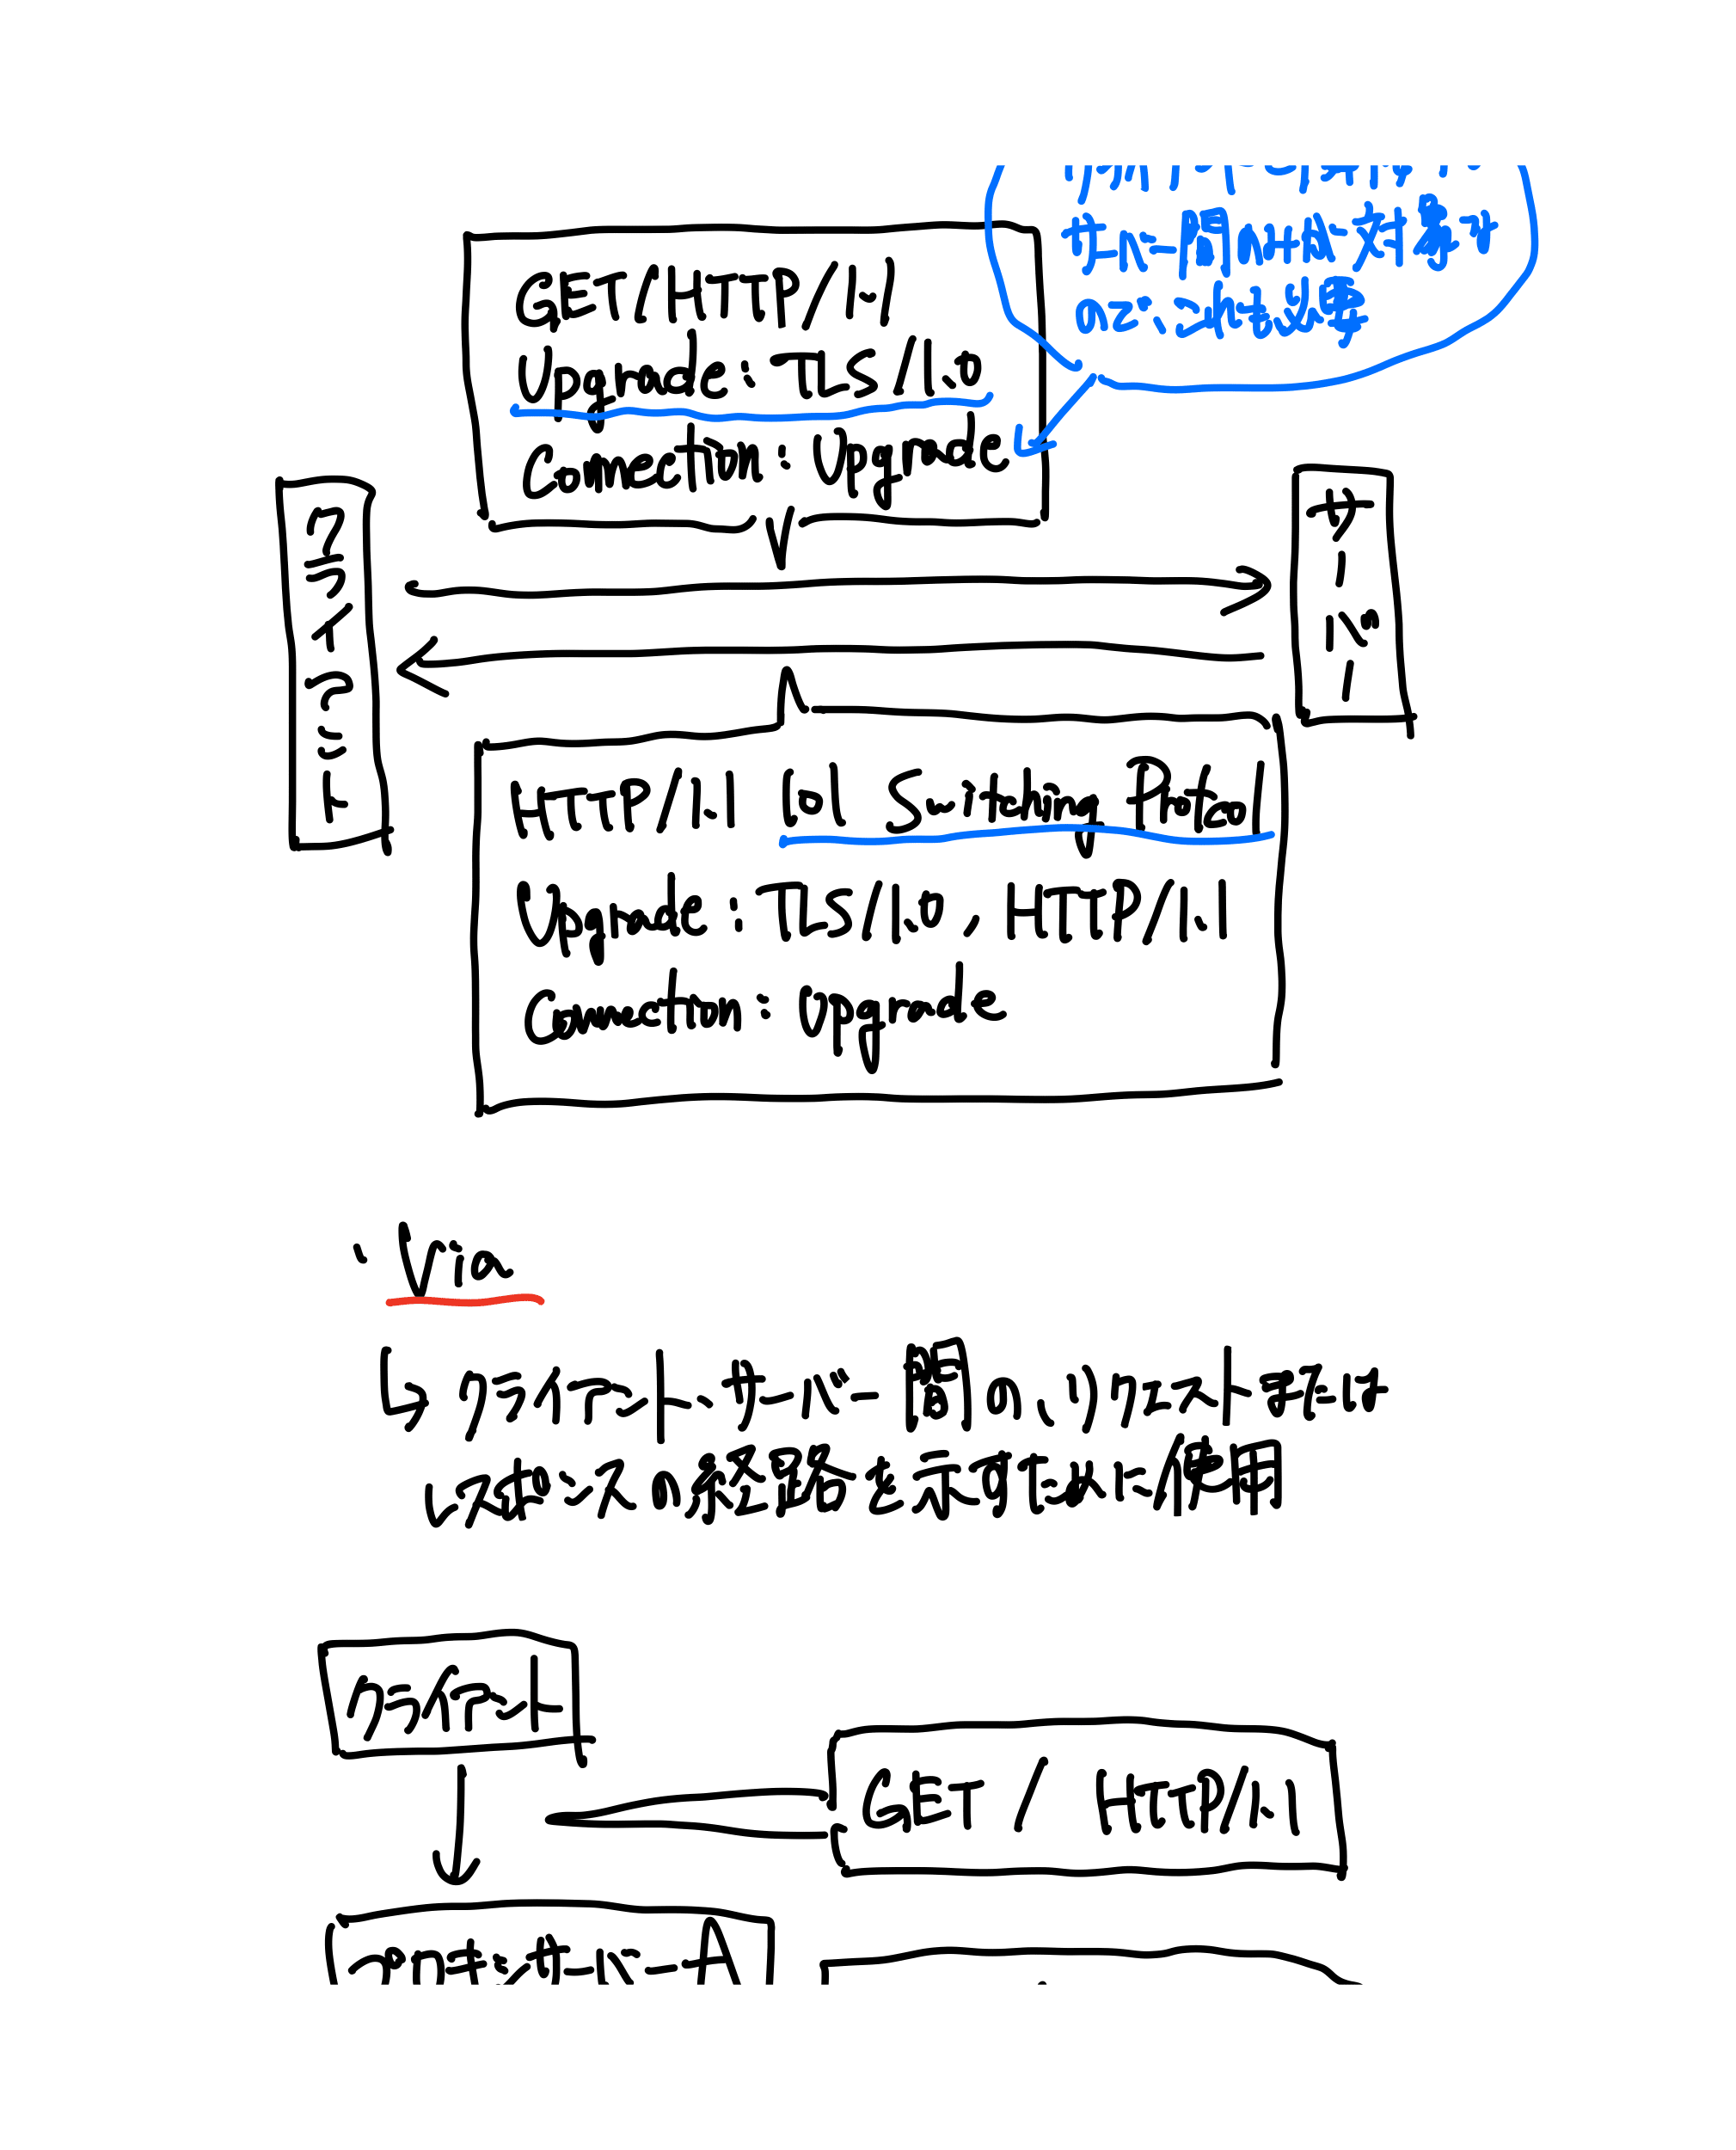
Transfer-Encoding: chunked - Upgrade → HTTP以外のプロトコルや新しいバージョンが使える場合に指定できる。
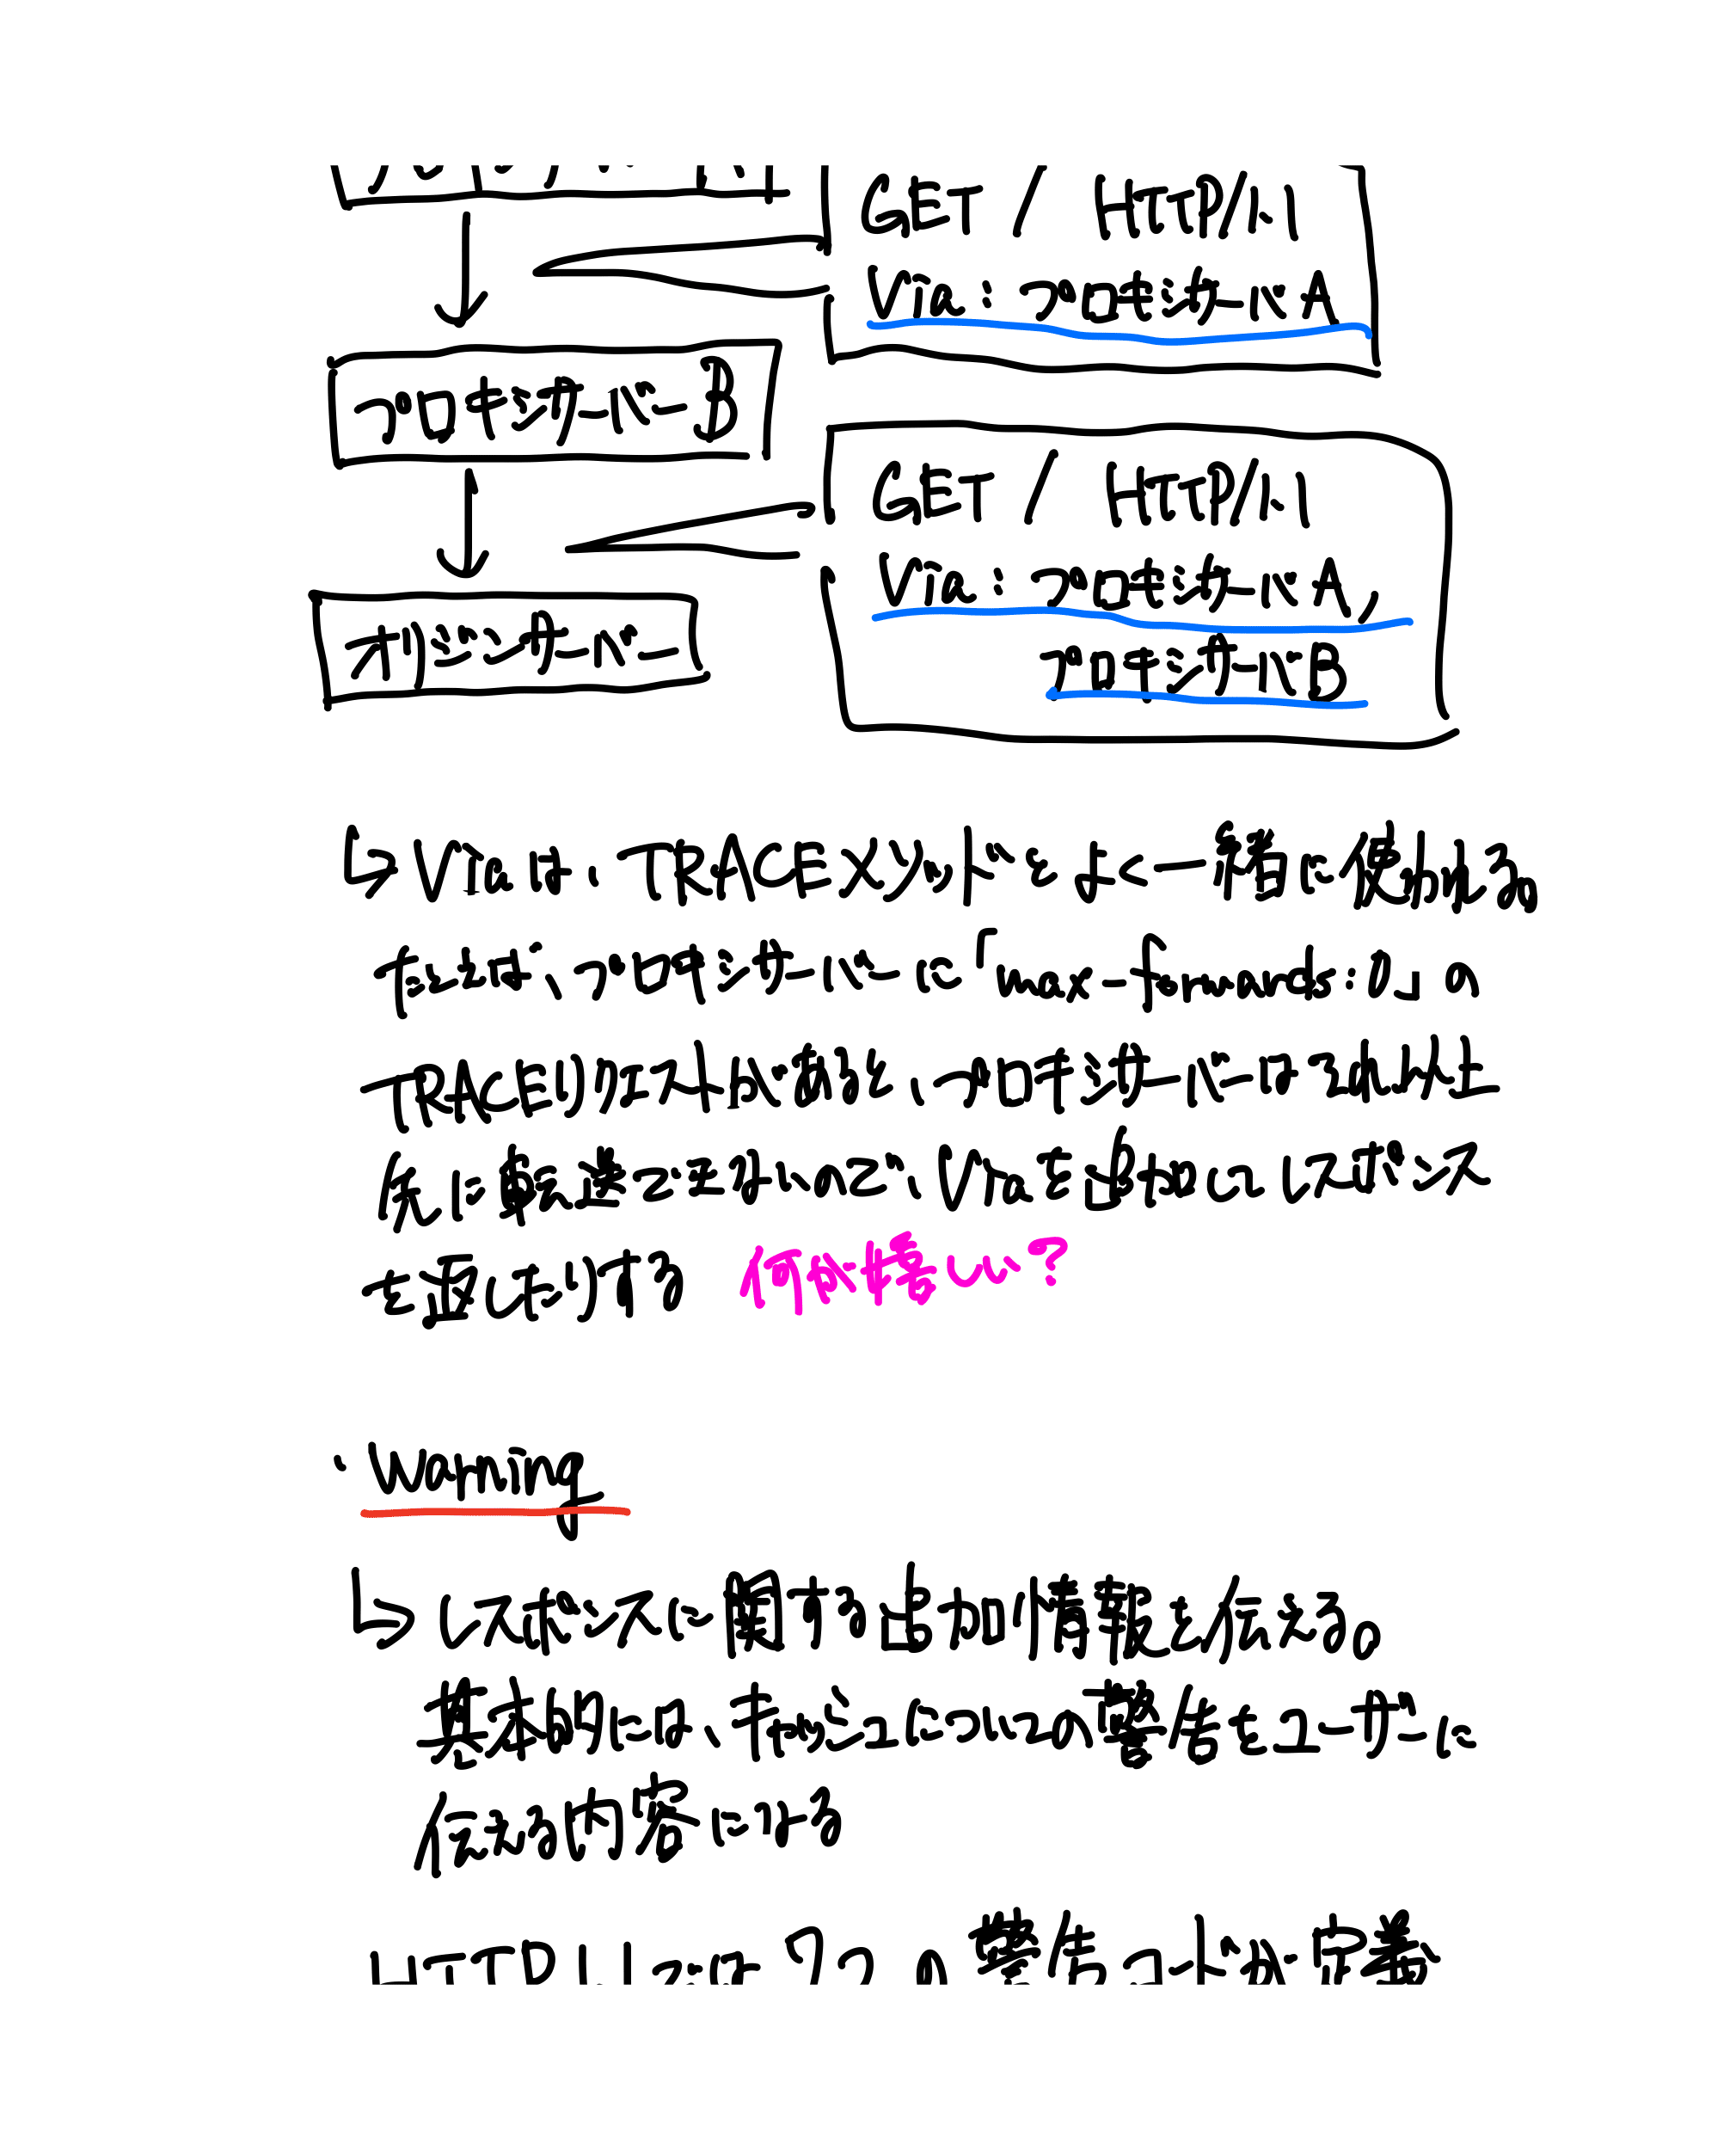
- Via → クライアント・サーバー間のリクエスト/レスポンスの経路を示す。通過するプロキシを追記していく。TRACE メソッドとよく一緒に使われる。
- Warning → レスポンスに関する追加情報(主にキャッシュについての警告)を伝える。HTTP1.1では7つの警告コードが定義される。
リクエストヘッダーフィールド
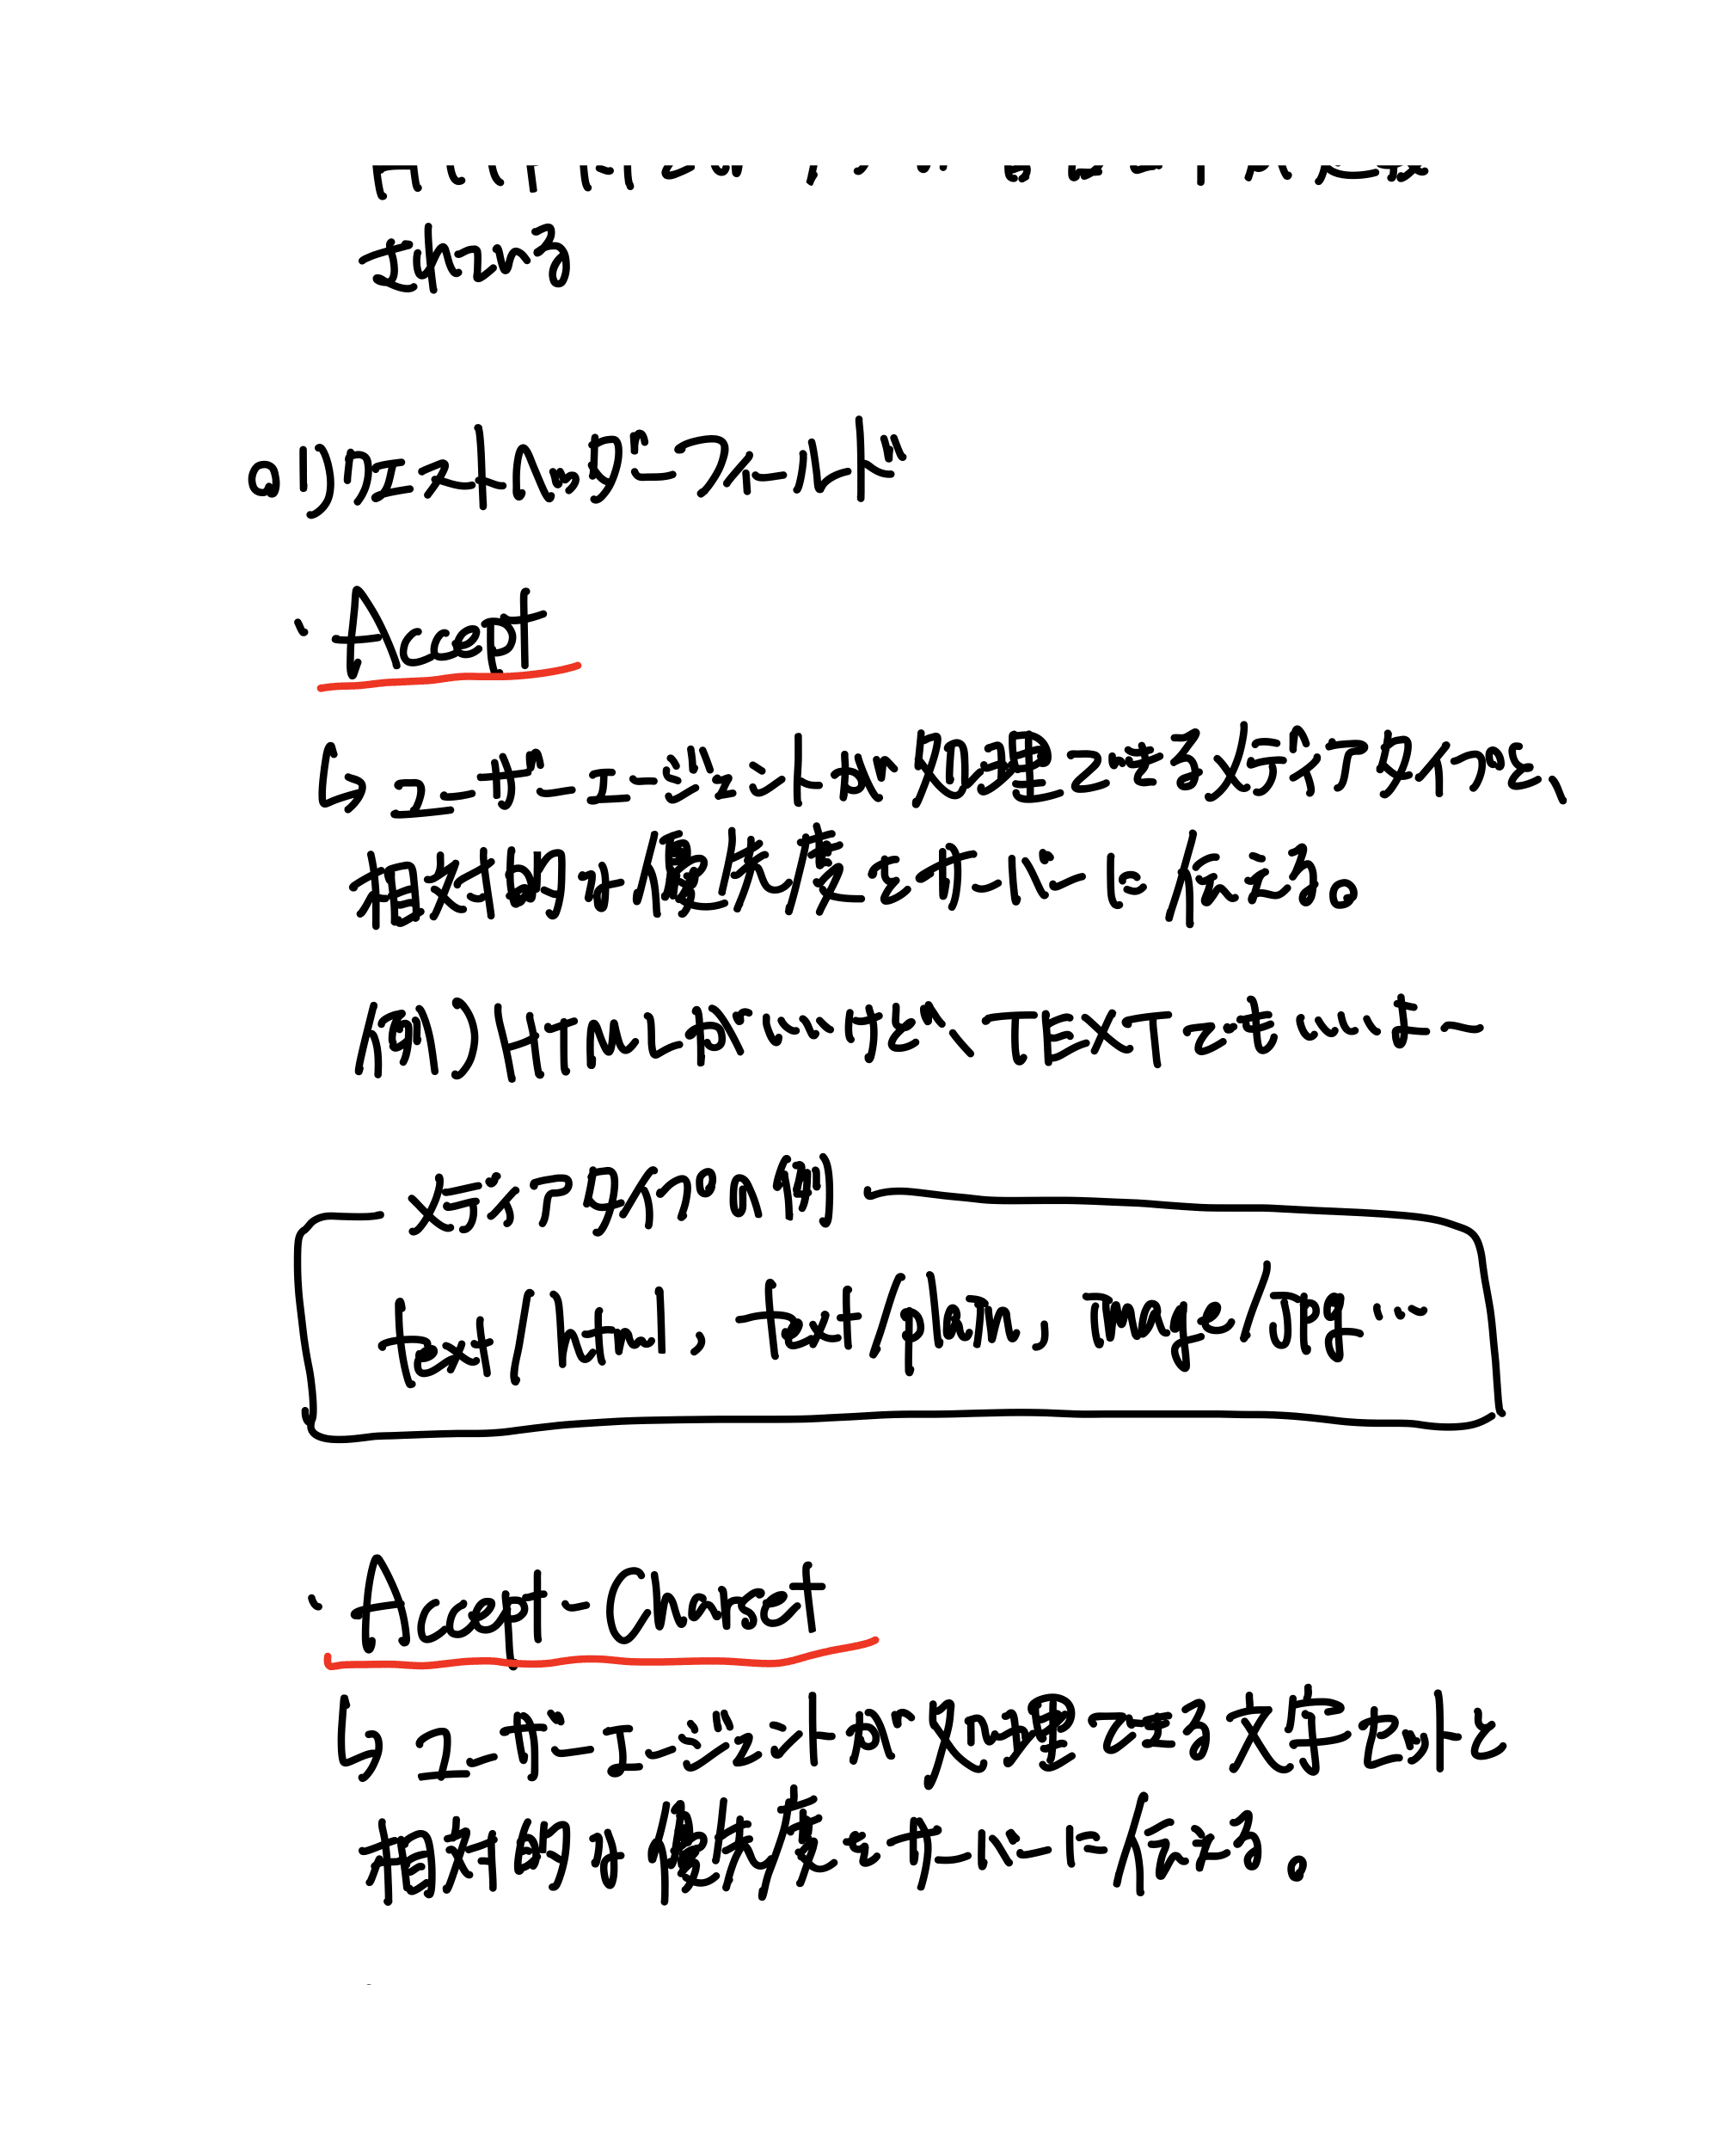
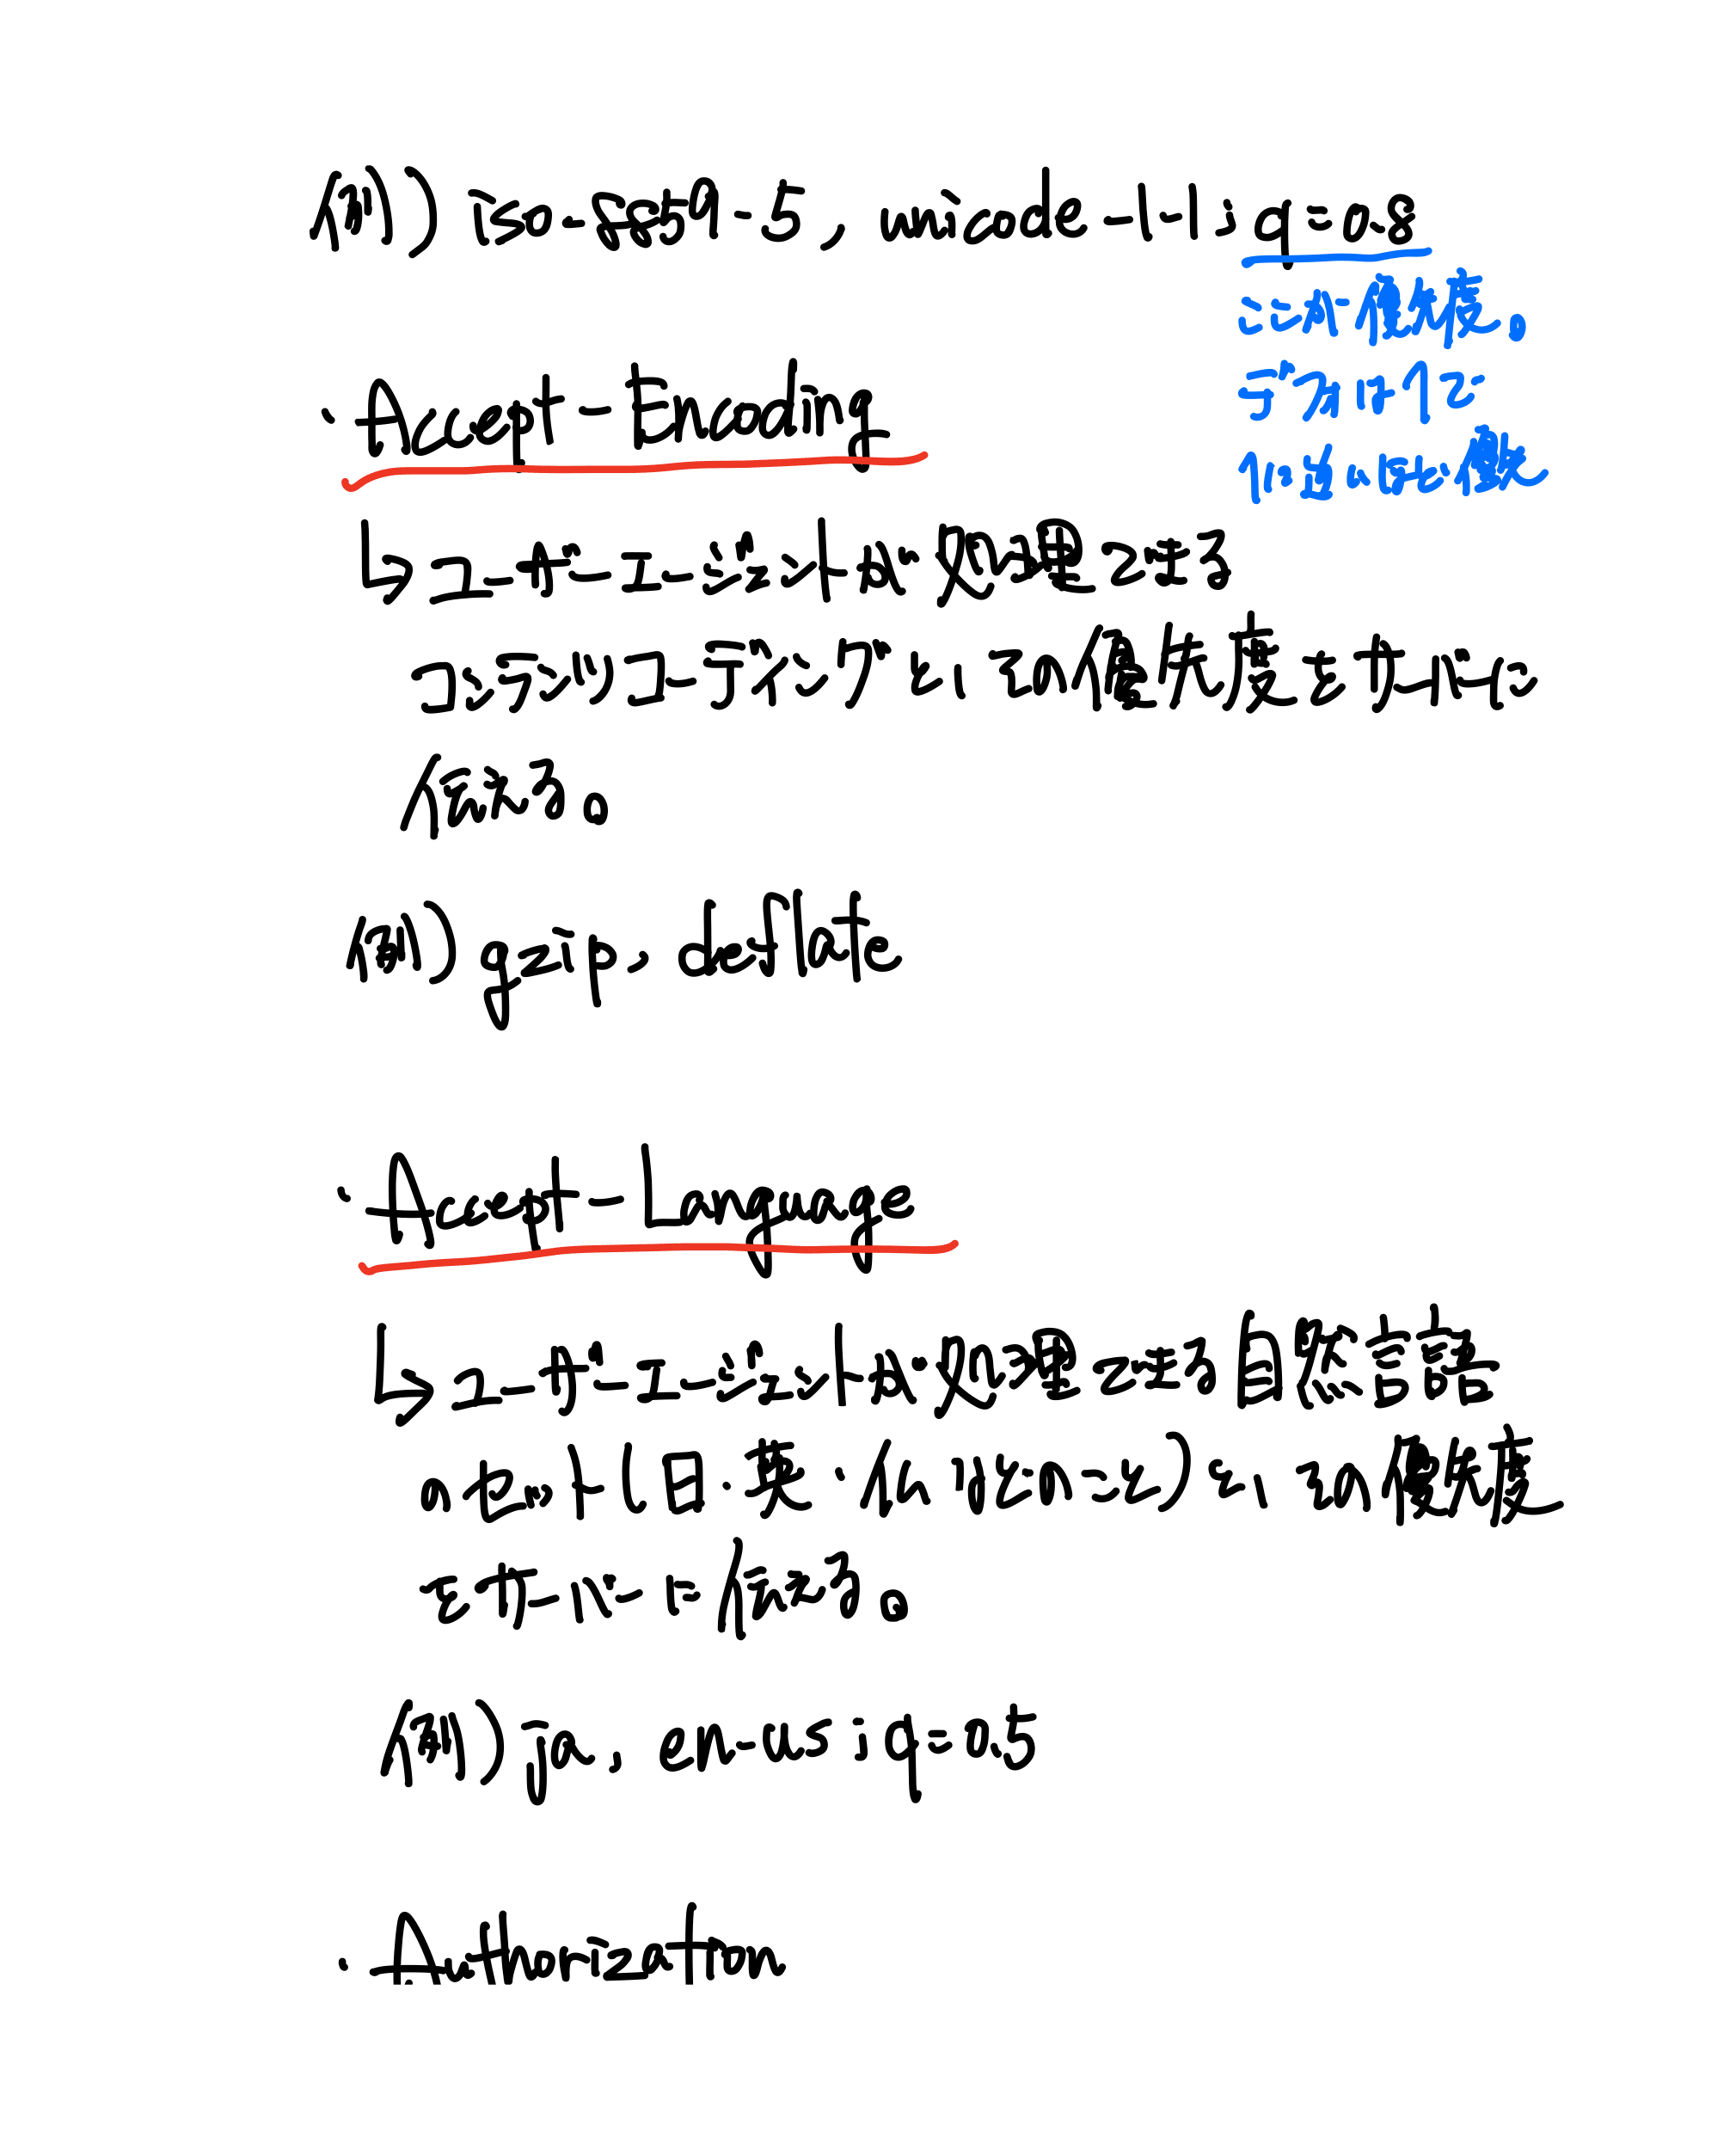
- Accept → 処理できるメディアタイプと相対的な優先度をサーバーに伝える(例:
text/html, text/plain, image/jpg …)。 - Accept-Charset → 処理できる文字セットと優先度を伝える。例)
iso-8859-5, unicode-1-1; q=0.8(q が優先度。デフォルト1、1に近いほど高い)。 - Accept-Encoding → 処理できるコンテンツコーディングと優先度(例:
gzip, deflate)。 - Accept-Language → 処理できる自然言語のセットと優先度(例:
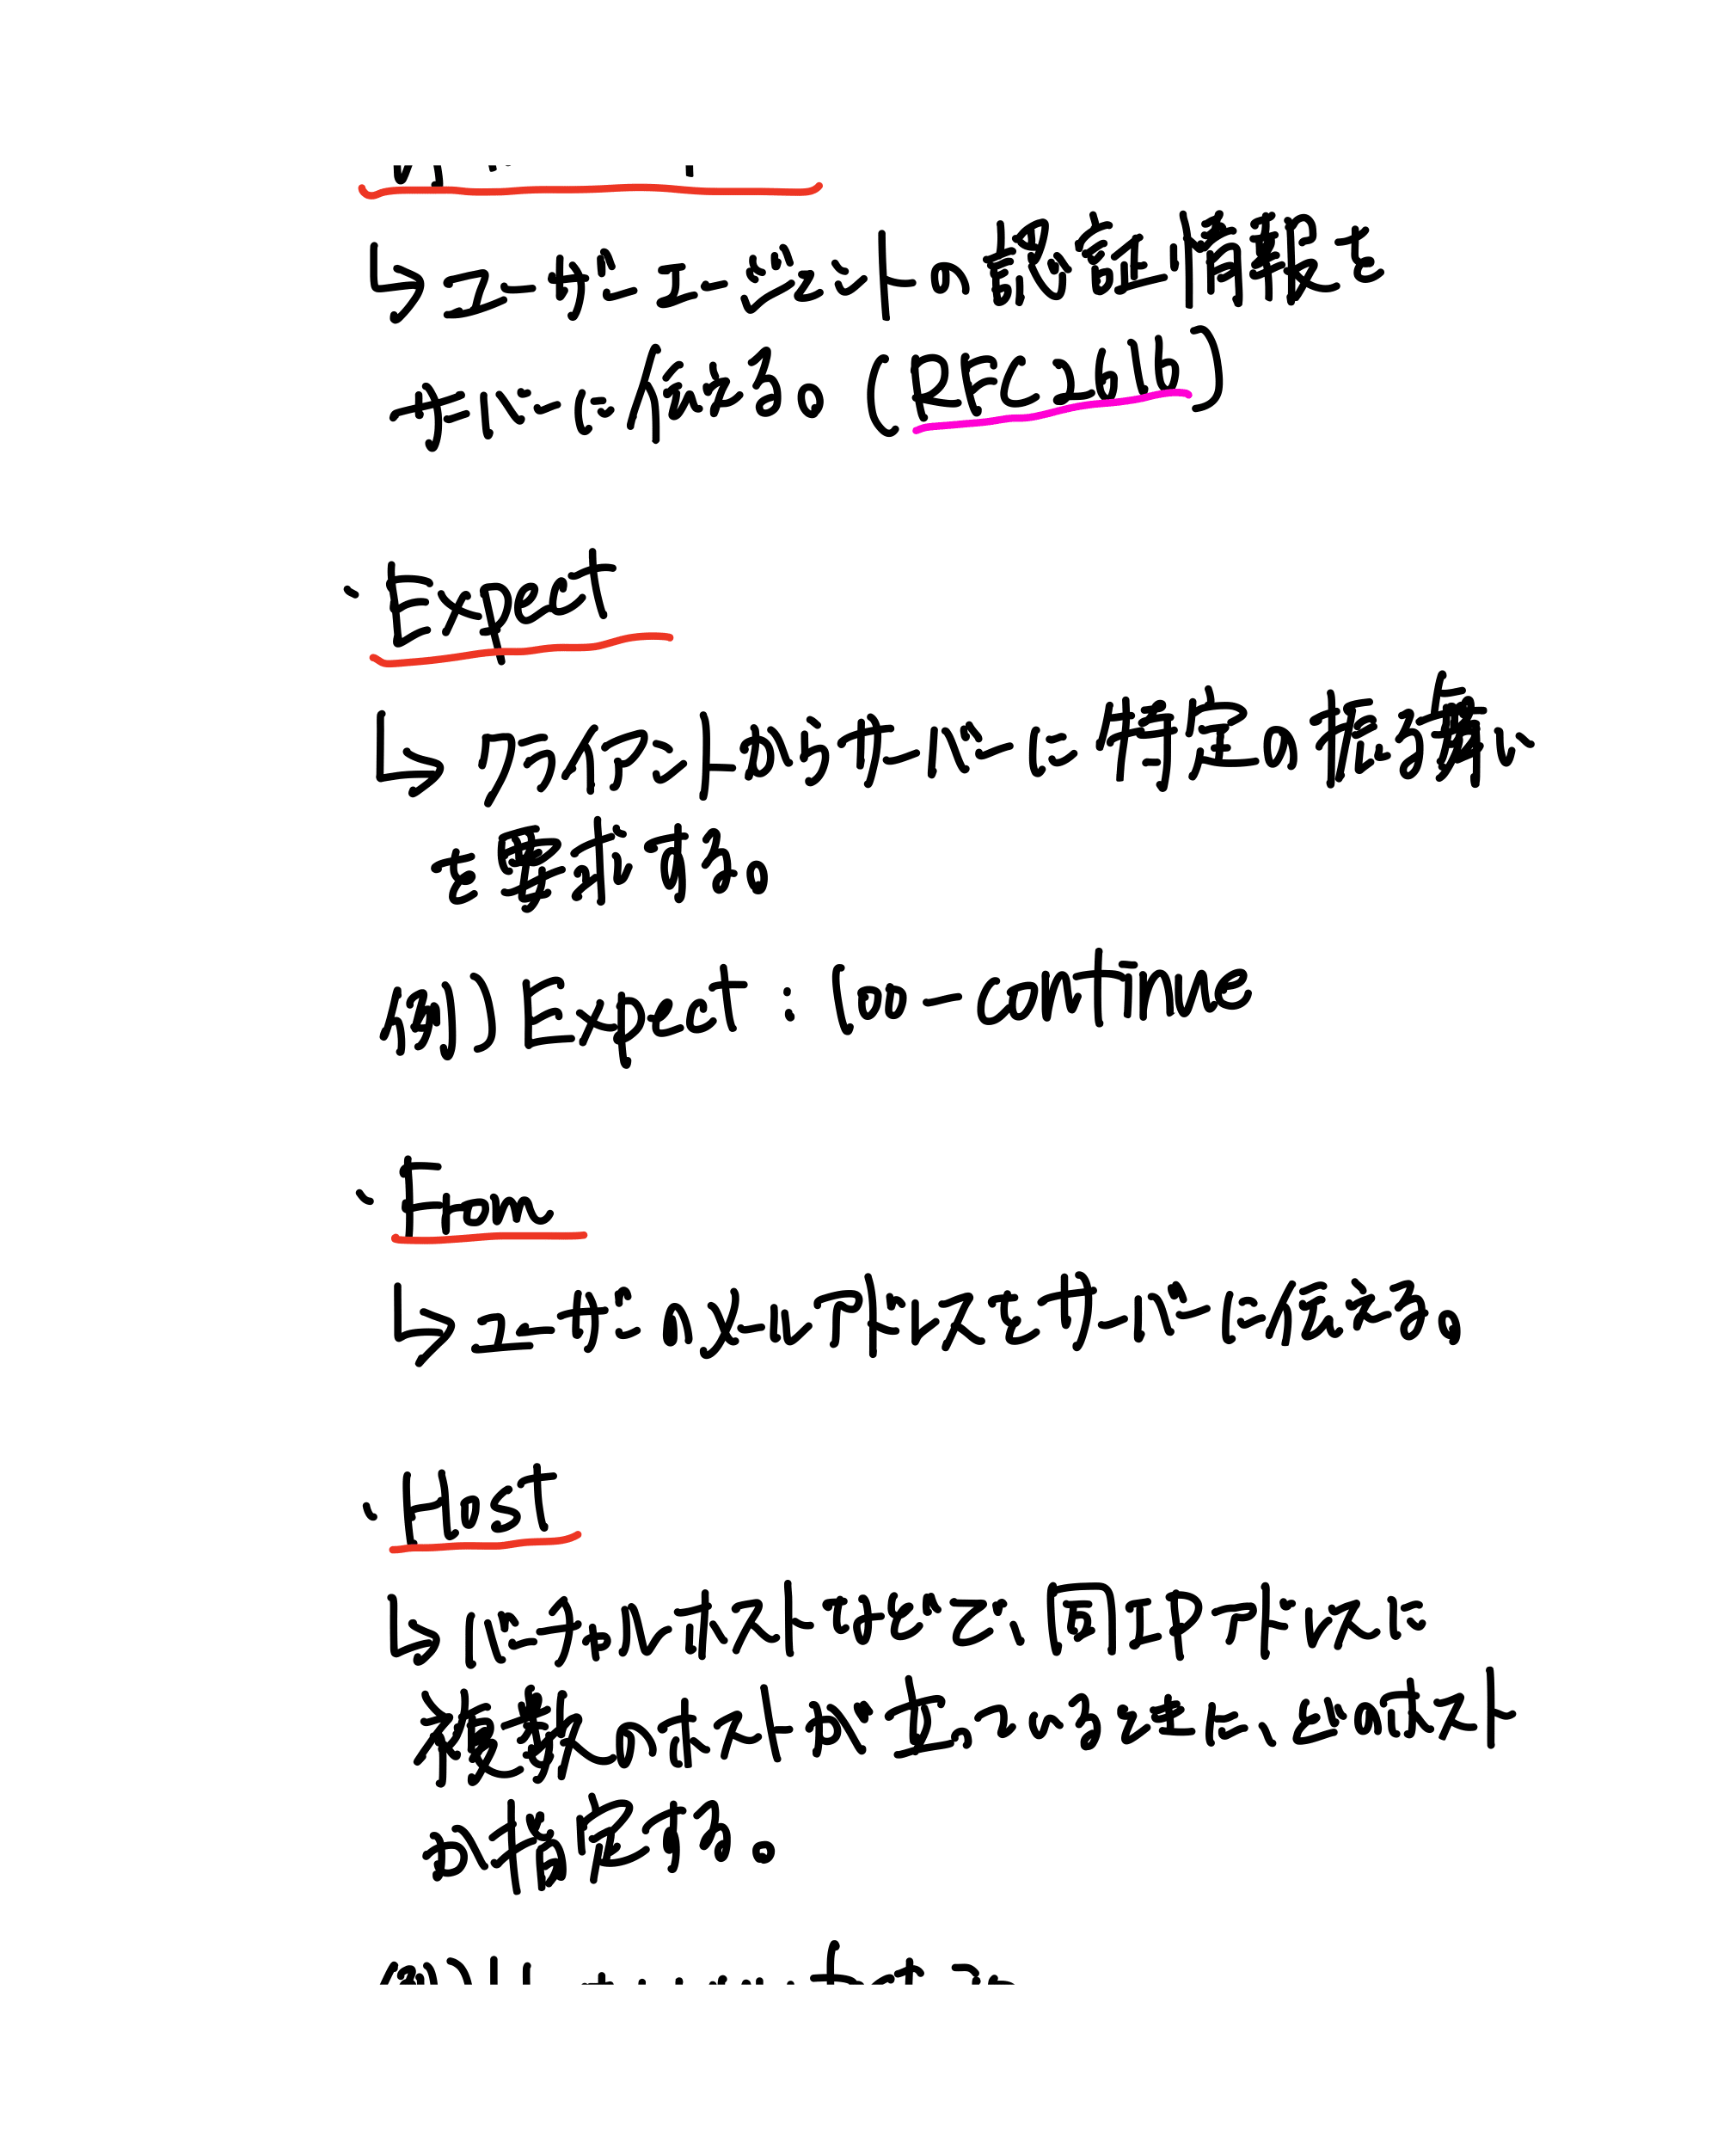
ja, en-us; q=0.5)。 - Authorization → ユーザーエージェントの認証情報をサーバーに伝える(RFC 2616)。
- Expect → クライアントからサーバーに特定の振る舞いを要求する。例)
Expect: 100-continue - From → ユーザーのメールアドレスをサーバーに伝える。
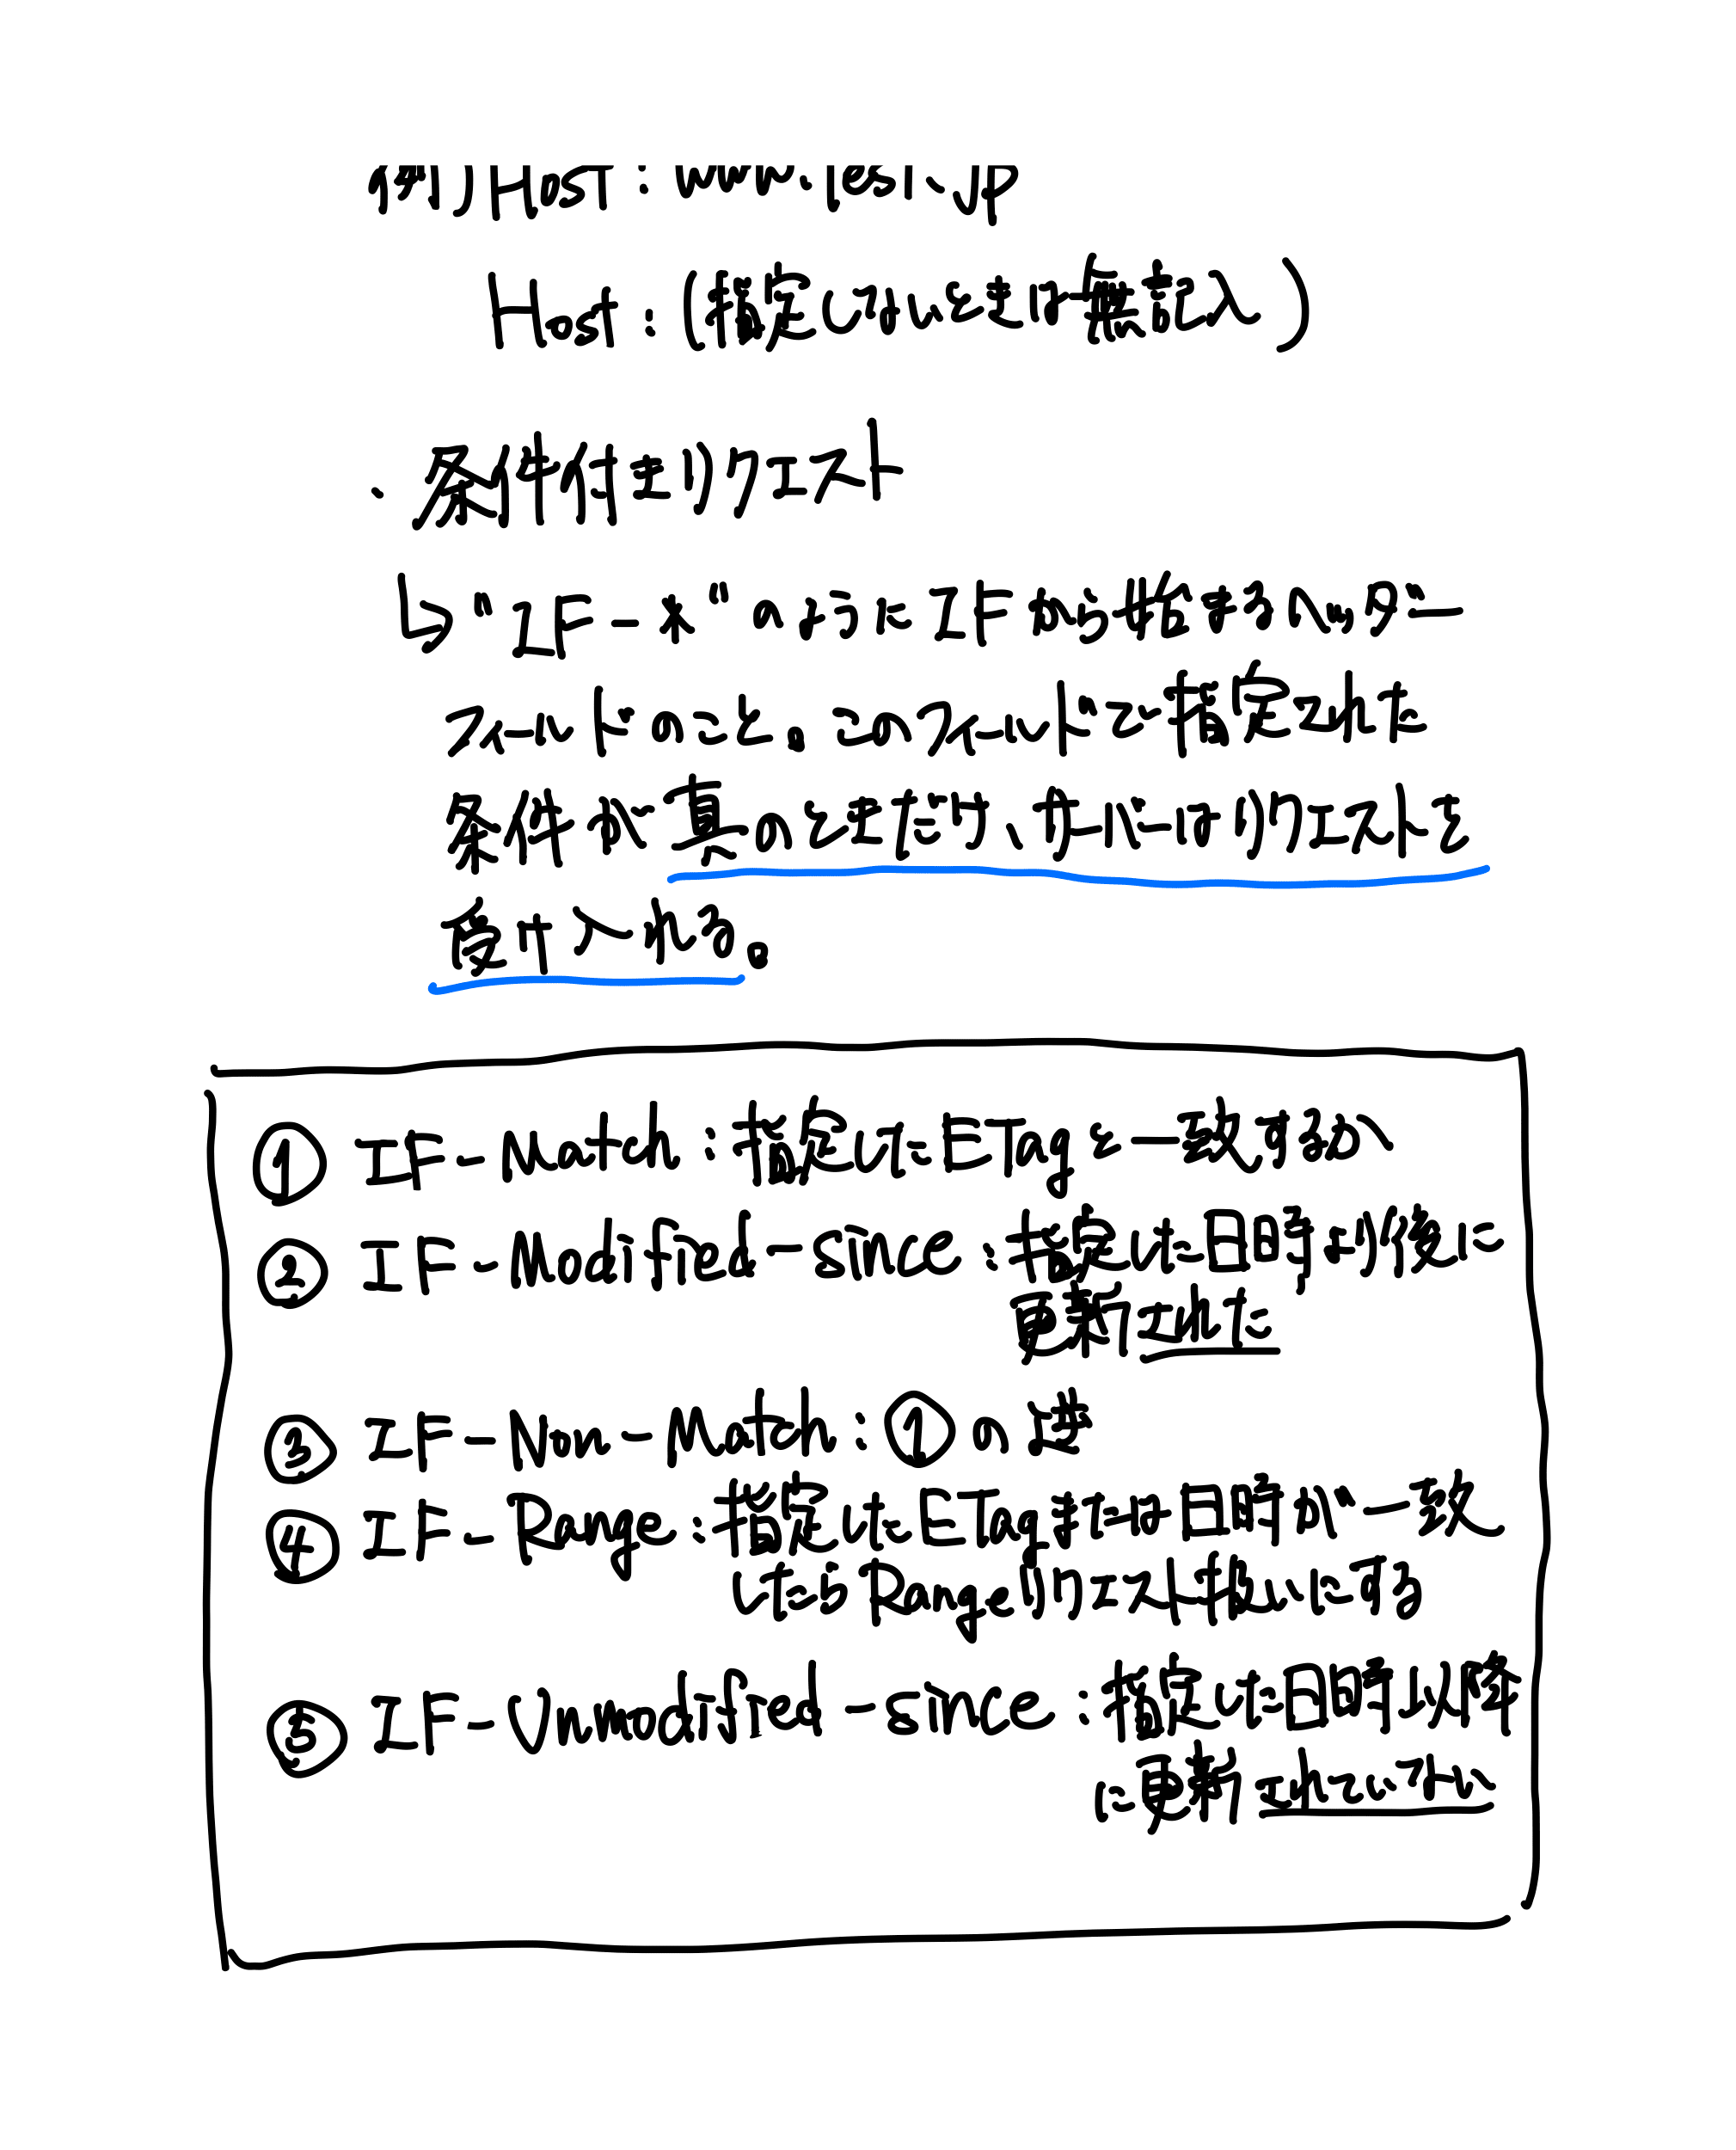
- Host → バーチャルホストなどで、同一IPに複数ホストが立つとき、どのホストか指定する。例)
Host: www.test.jp - 条件付きリクエスト →
IF-*のように IF から始まるフィールド。条件が真のときだけサーバーはリクエストを受け入れる。- IF-Match:指定した ETag と一致するか
- IF-Modified-Since:指定した日時より後に更新された
- IF-None-Match:IF-Match の逆
- IF-Range:指定した ETag または日時が一致したら Range リクエスト扱いにする
- IF-Unmodified-Since:指定した日時以降に更新されていない
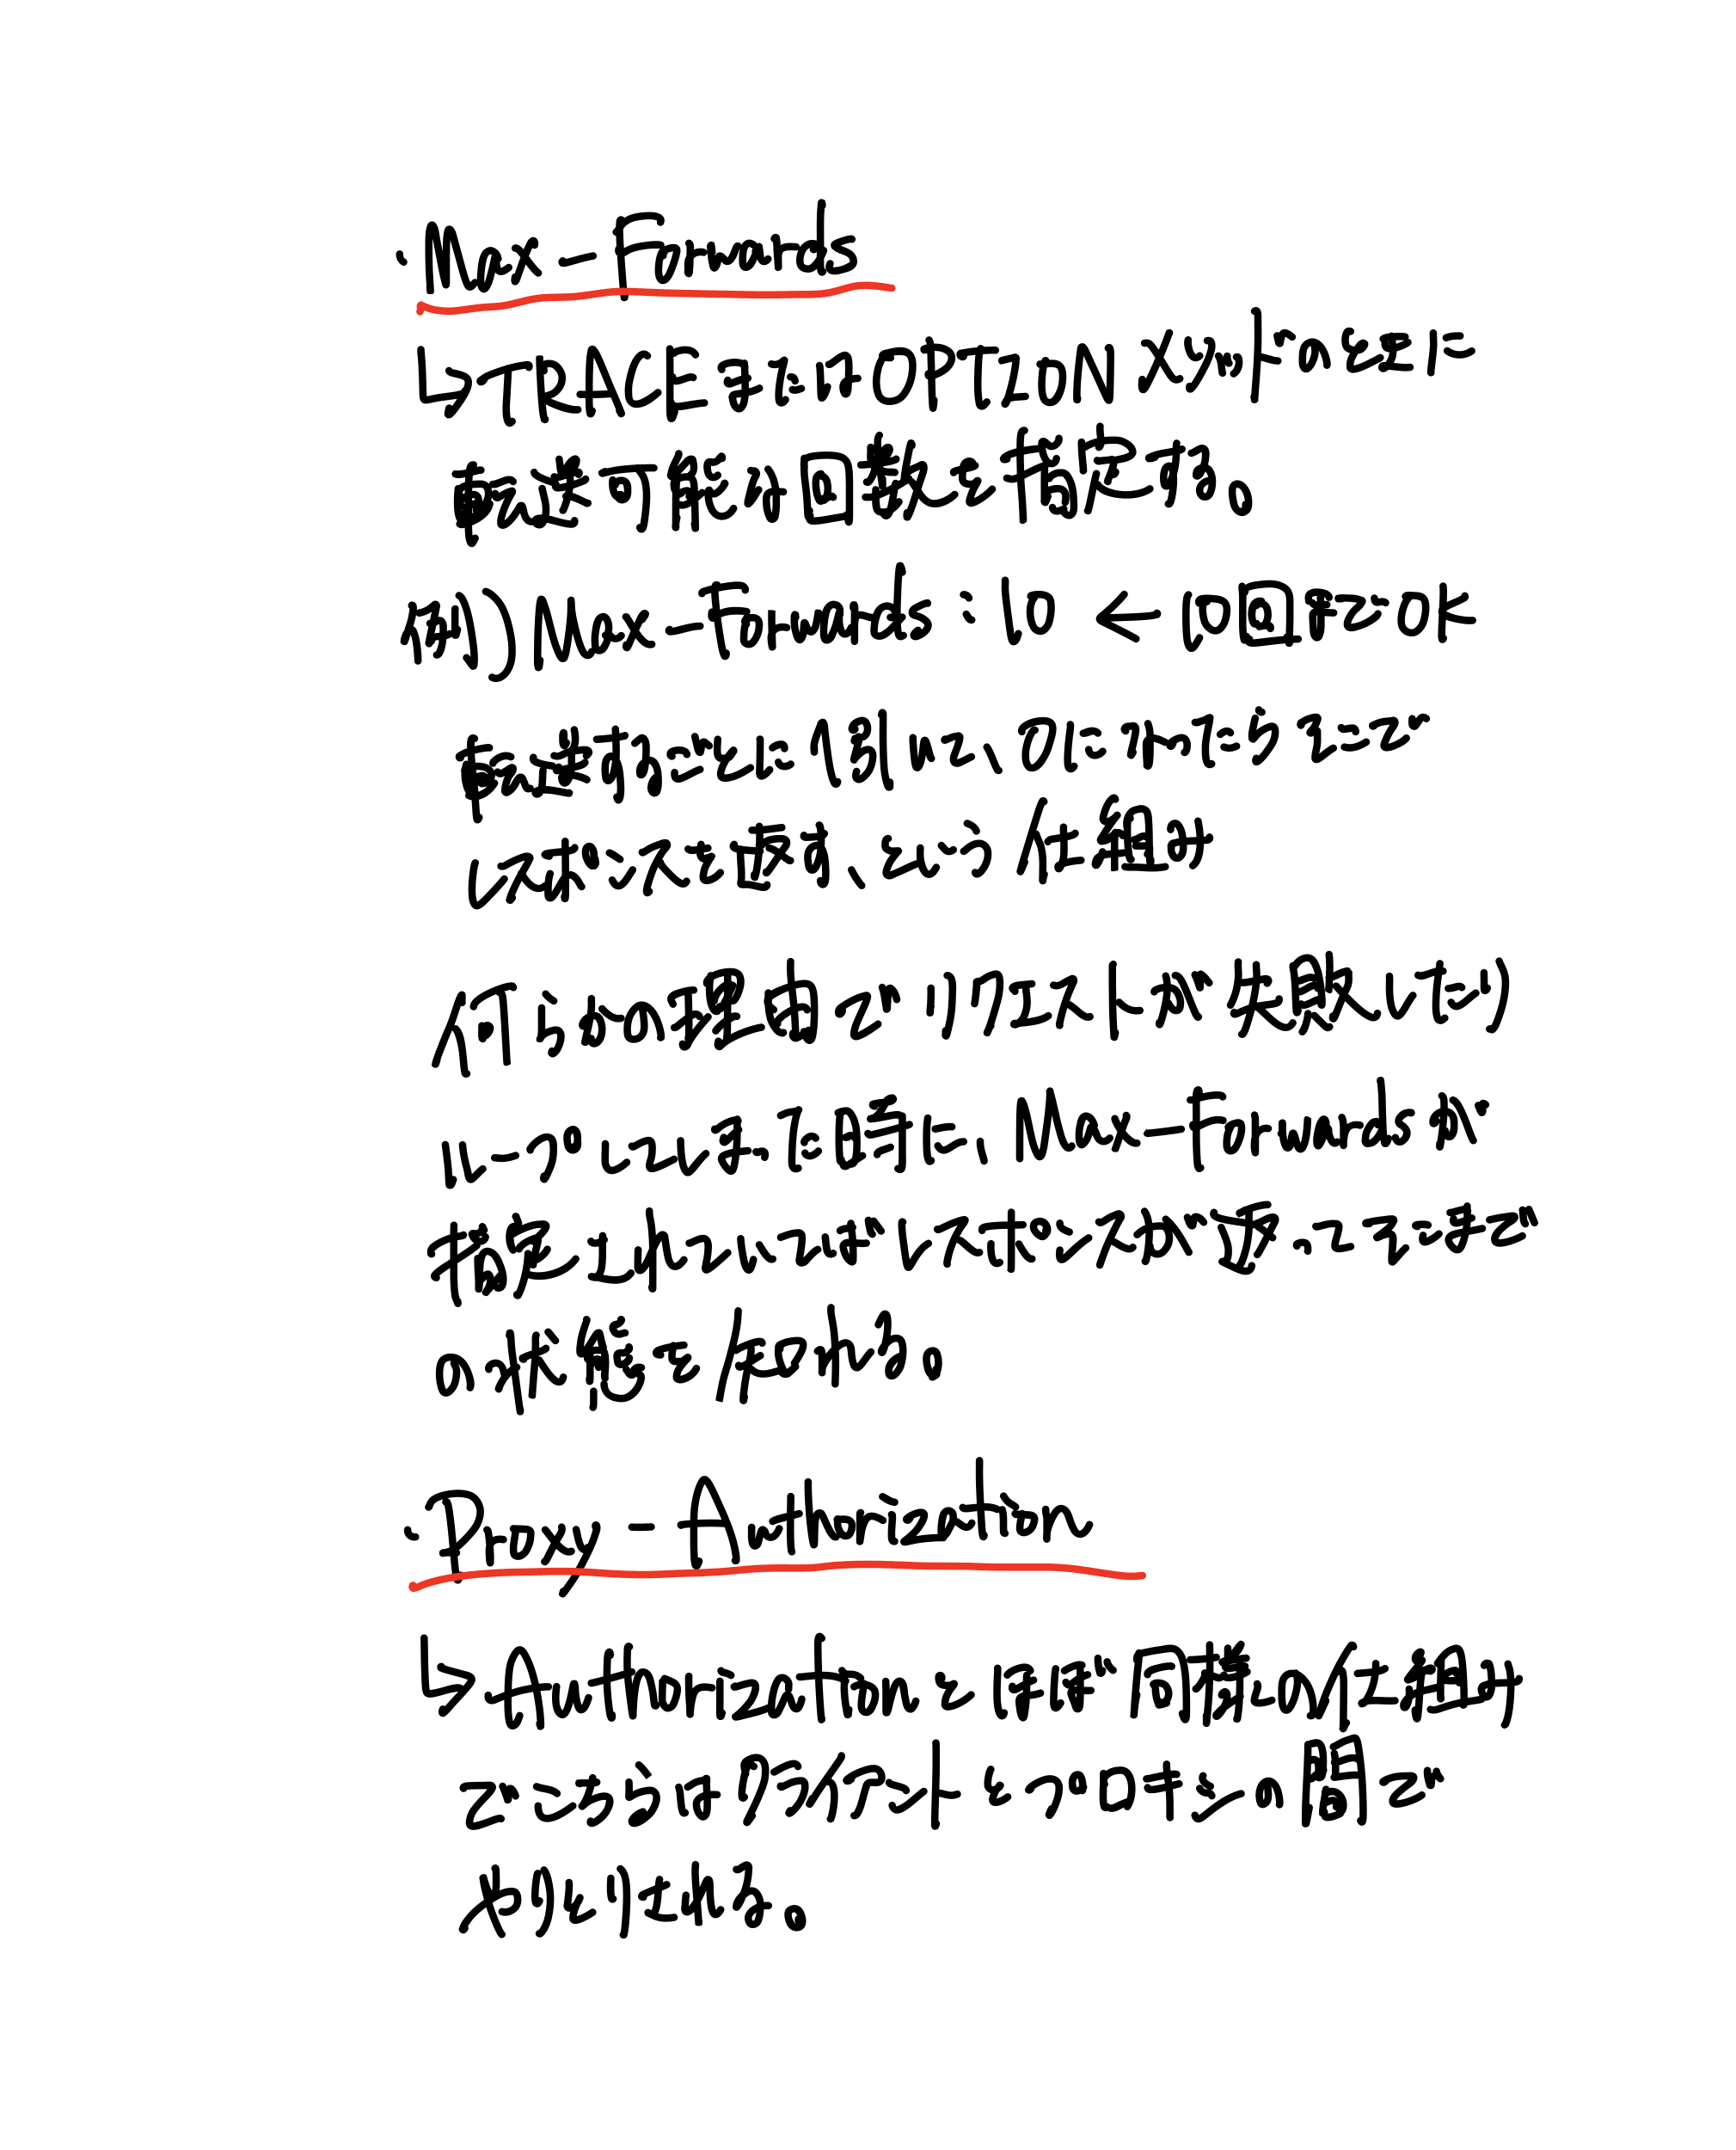
- Max-Forwards → TRACE / OPTIONS のときに転送可能な回数を指定。例)
Max-Forwards: 10。転送ごとに1引き、0になったらそこでレスポンスを返す。リクエストが失敗・ループしたときに状態を知れる。 - Proxy-Authorization → Authorization とほぼ同様だが、クライアントとプロキシの間でやりとりされる。
- Range → 3章のレンジリクエスト。サーバーが処理できれば206、できなければ200で全リソースが返る。
- Referer → リクエストが発生した元のリソースの URI を伝える。セキュリティ上好ましくない場合は使わなくてよい。
- TE → レスポンスに受け入れ可能な転送エンコーディングと優先度を伝える。Accept-Encoding に似るが、TEは転送エンコーディング、A-Eはコンテンツエンコーディング。
レスポンスヘッダーフィールド
- Accept-Ranges → サーバーがレンジリクエストを受けられるか(
bytes/none)。 - Age → どれくらい前にオリジンサーバーで生成されたか。
- ETag → エンティティタグ。サーバーがリソースごとに割り当てる。キャッシュの特定やダウンロード再開などで使う。
- 強いETag:わずかに違うだけで値が全く異なる。例)
ETag: "usage-1234" - 弱いETag:「リソースが同じもの」ということしか示せない。先頭に
W/を付く。例)ETag: "W/usage-1234"
- 強いETag:わずかに違うだけで値が全く異なる。例)
- Location → リクエストリソース以外の URI へのアクセスをうながす。主にリダイレクト先の指定で使う。
- Proxy-Authenticate → プロキシサーバーからの認証要求をクライアントに伝える。
- Retry-After → クライアントがどれくらい後に再リクエストすべきかを伝える(日時 or 秒数)。
- Server → サーバーに実装されているHTTPサーバーソフトウェアを伝える。例)
Server: Apache/2.2.7 (Unix) - Vary → プロキシが Vary 指定のリソース宛リクエストを受けたとき、同じリクエストヘッダーを持てばキャッシュから、異なればオリジンに取りに行く。例)
Vary: Accept-Language。キャッシュ制御に使う。 - WWW-Authenticate → HTTPアクセス認証に使う。認証スキーム(Basic か Digest)とパラメータを示す challenge を伝える。401レスポンスに必ず含まれる。
エンティティヘッダーフィールド
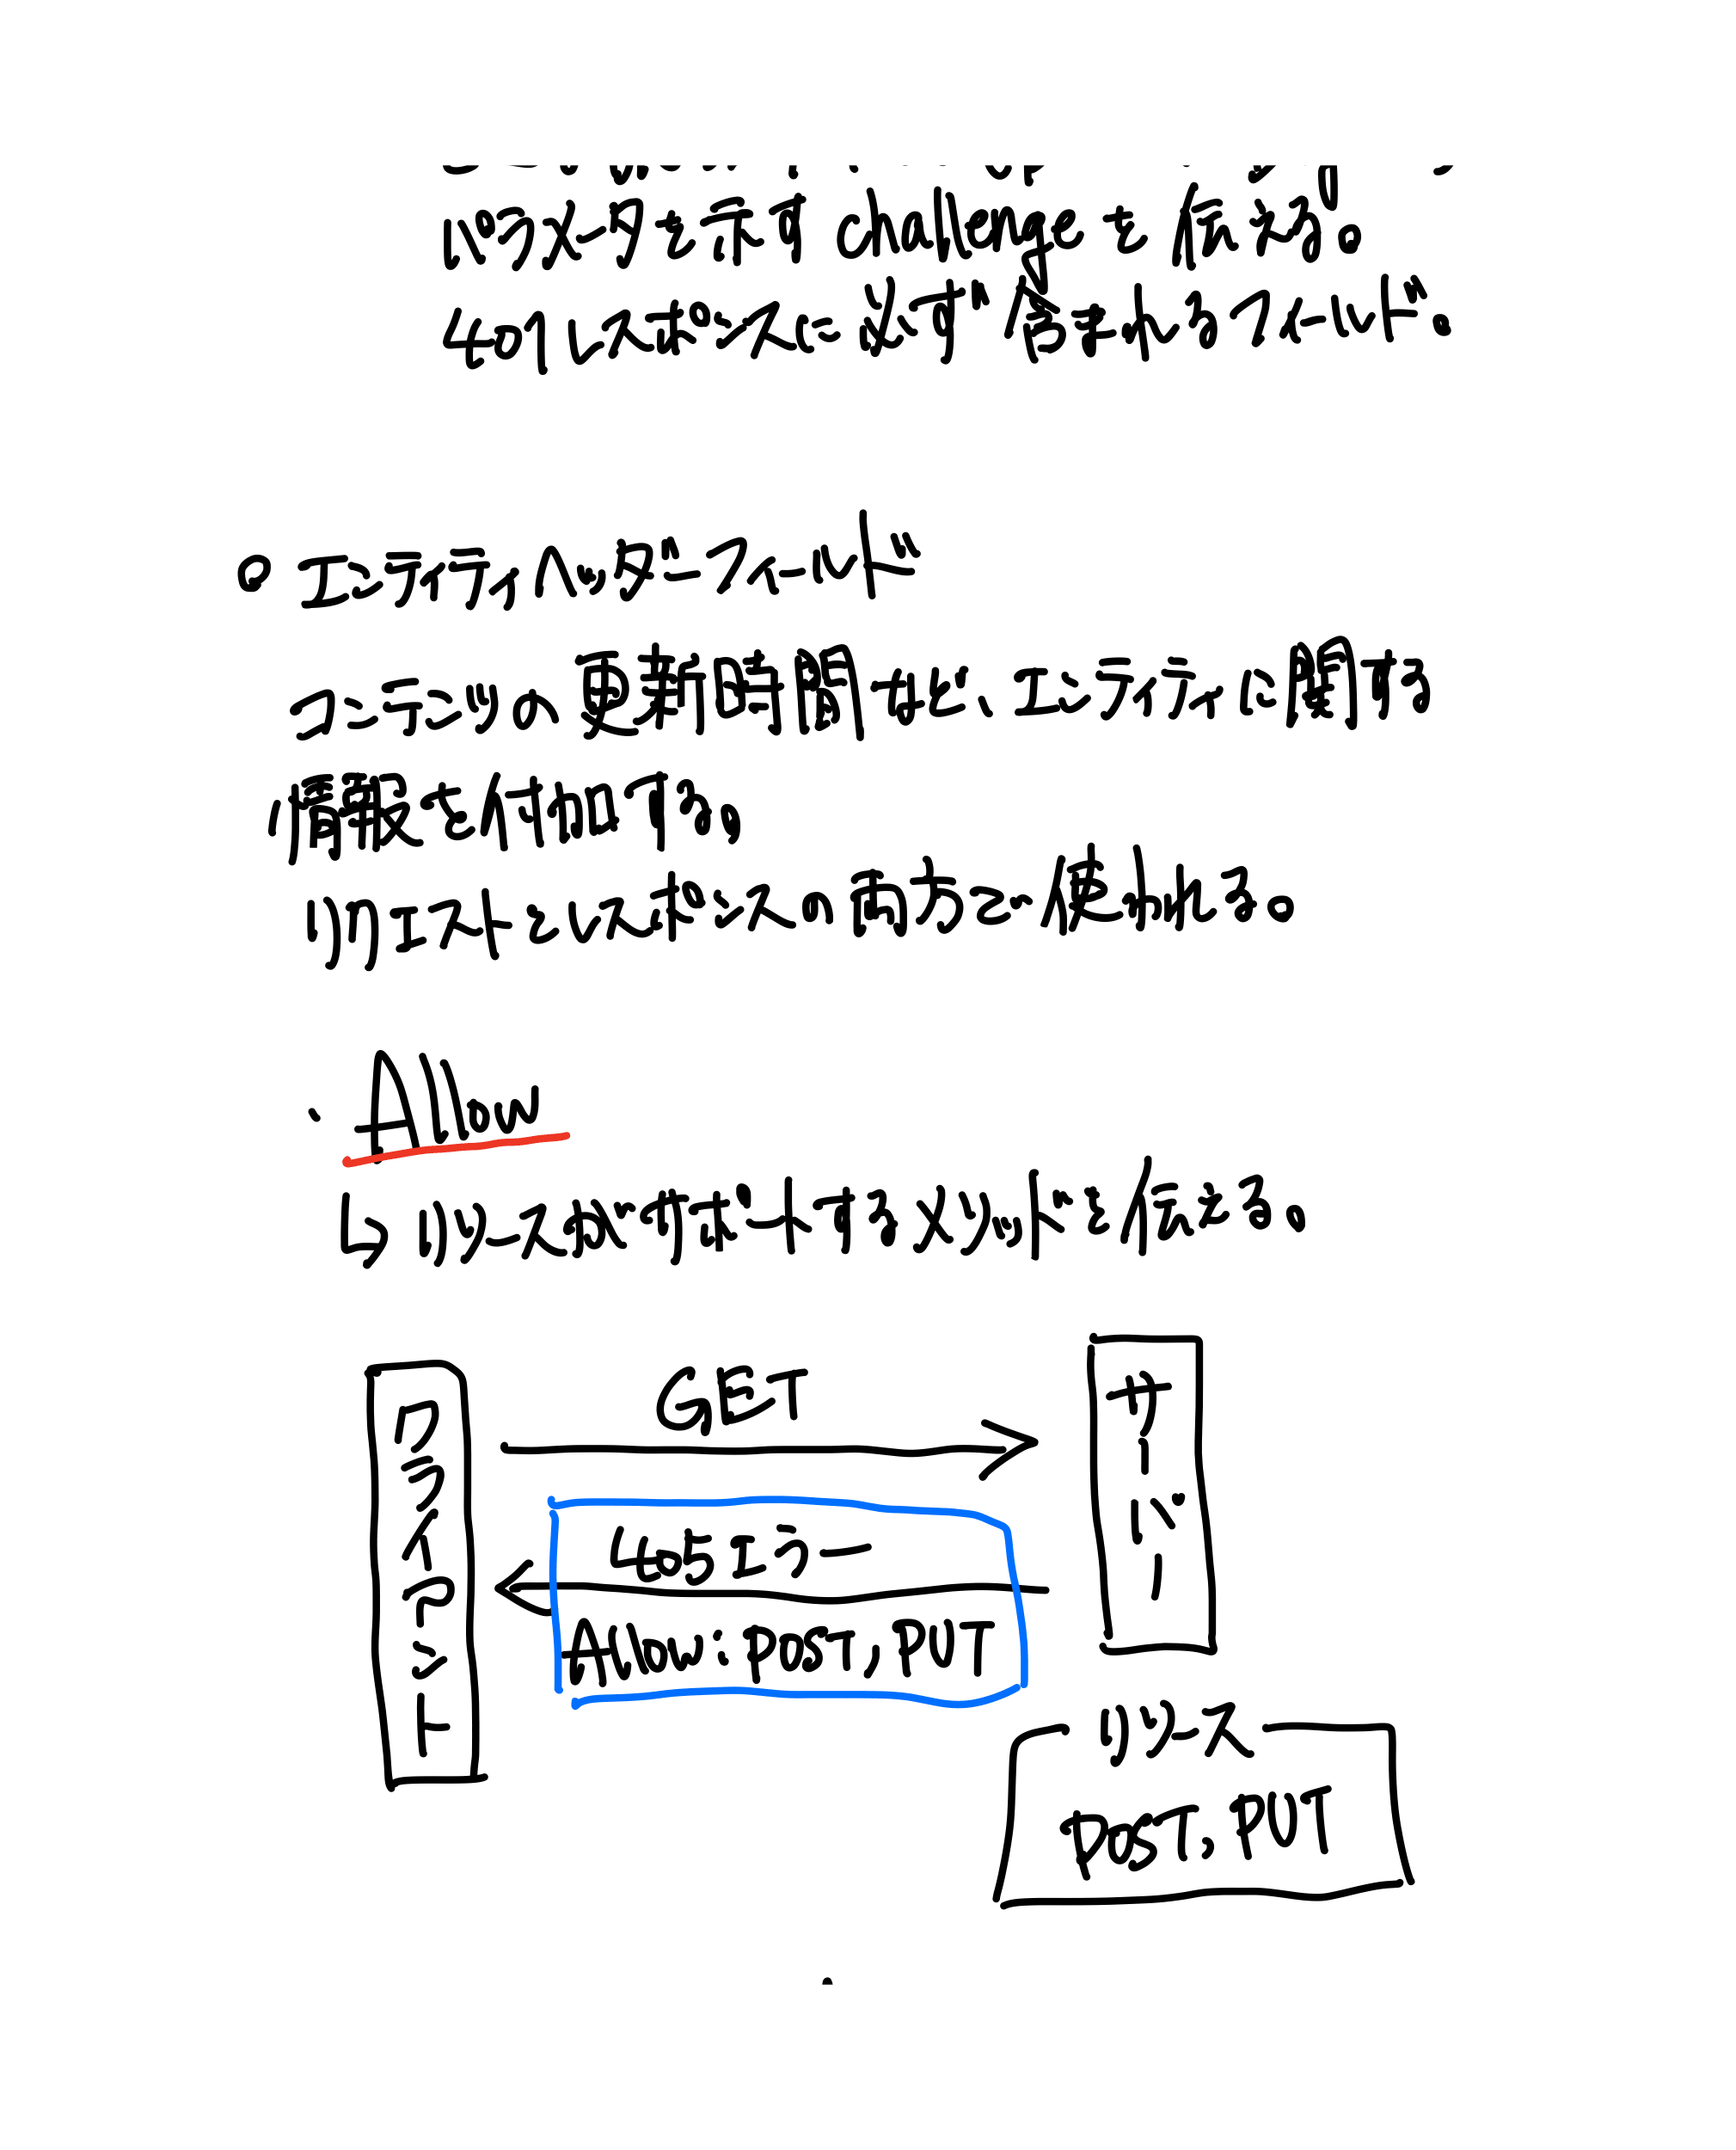
- Allow → リソースがサポートするメソッドを伝える(未対応メソッドには405+
Allow: POST, PUT)。 - Content-Encoding → サーバーがエンティティに施したエンコーディング形式を伝える。
- Content-Language → エンティティボディに使用されている自然言語を伝える。
- Content-Length → エンティティボディのサイズ(bytes)。転送エンコーディング使用時は使ってはいけない。
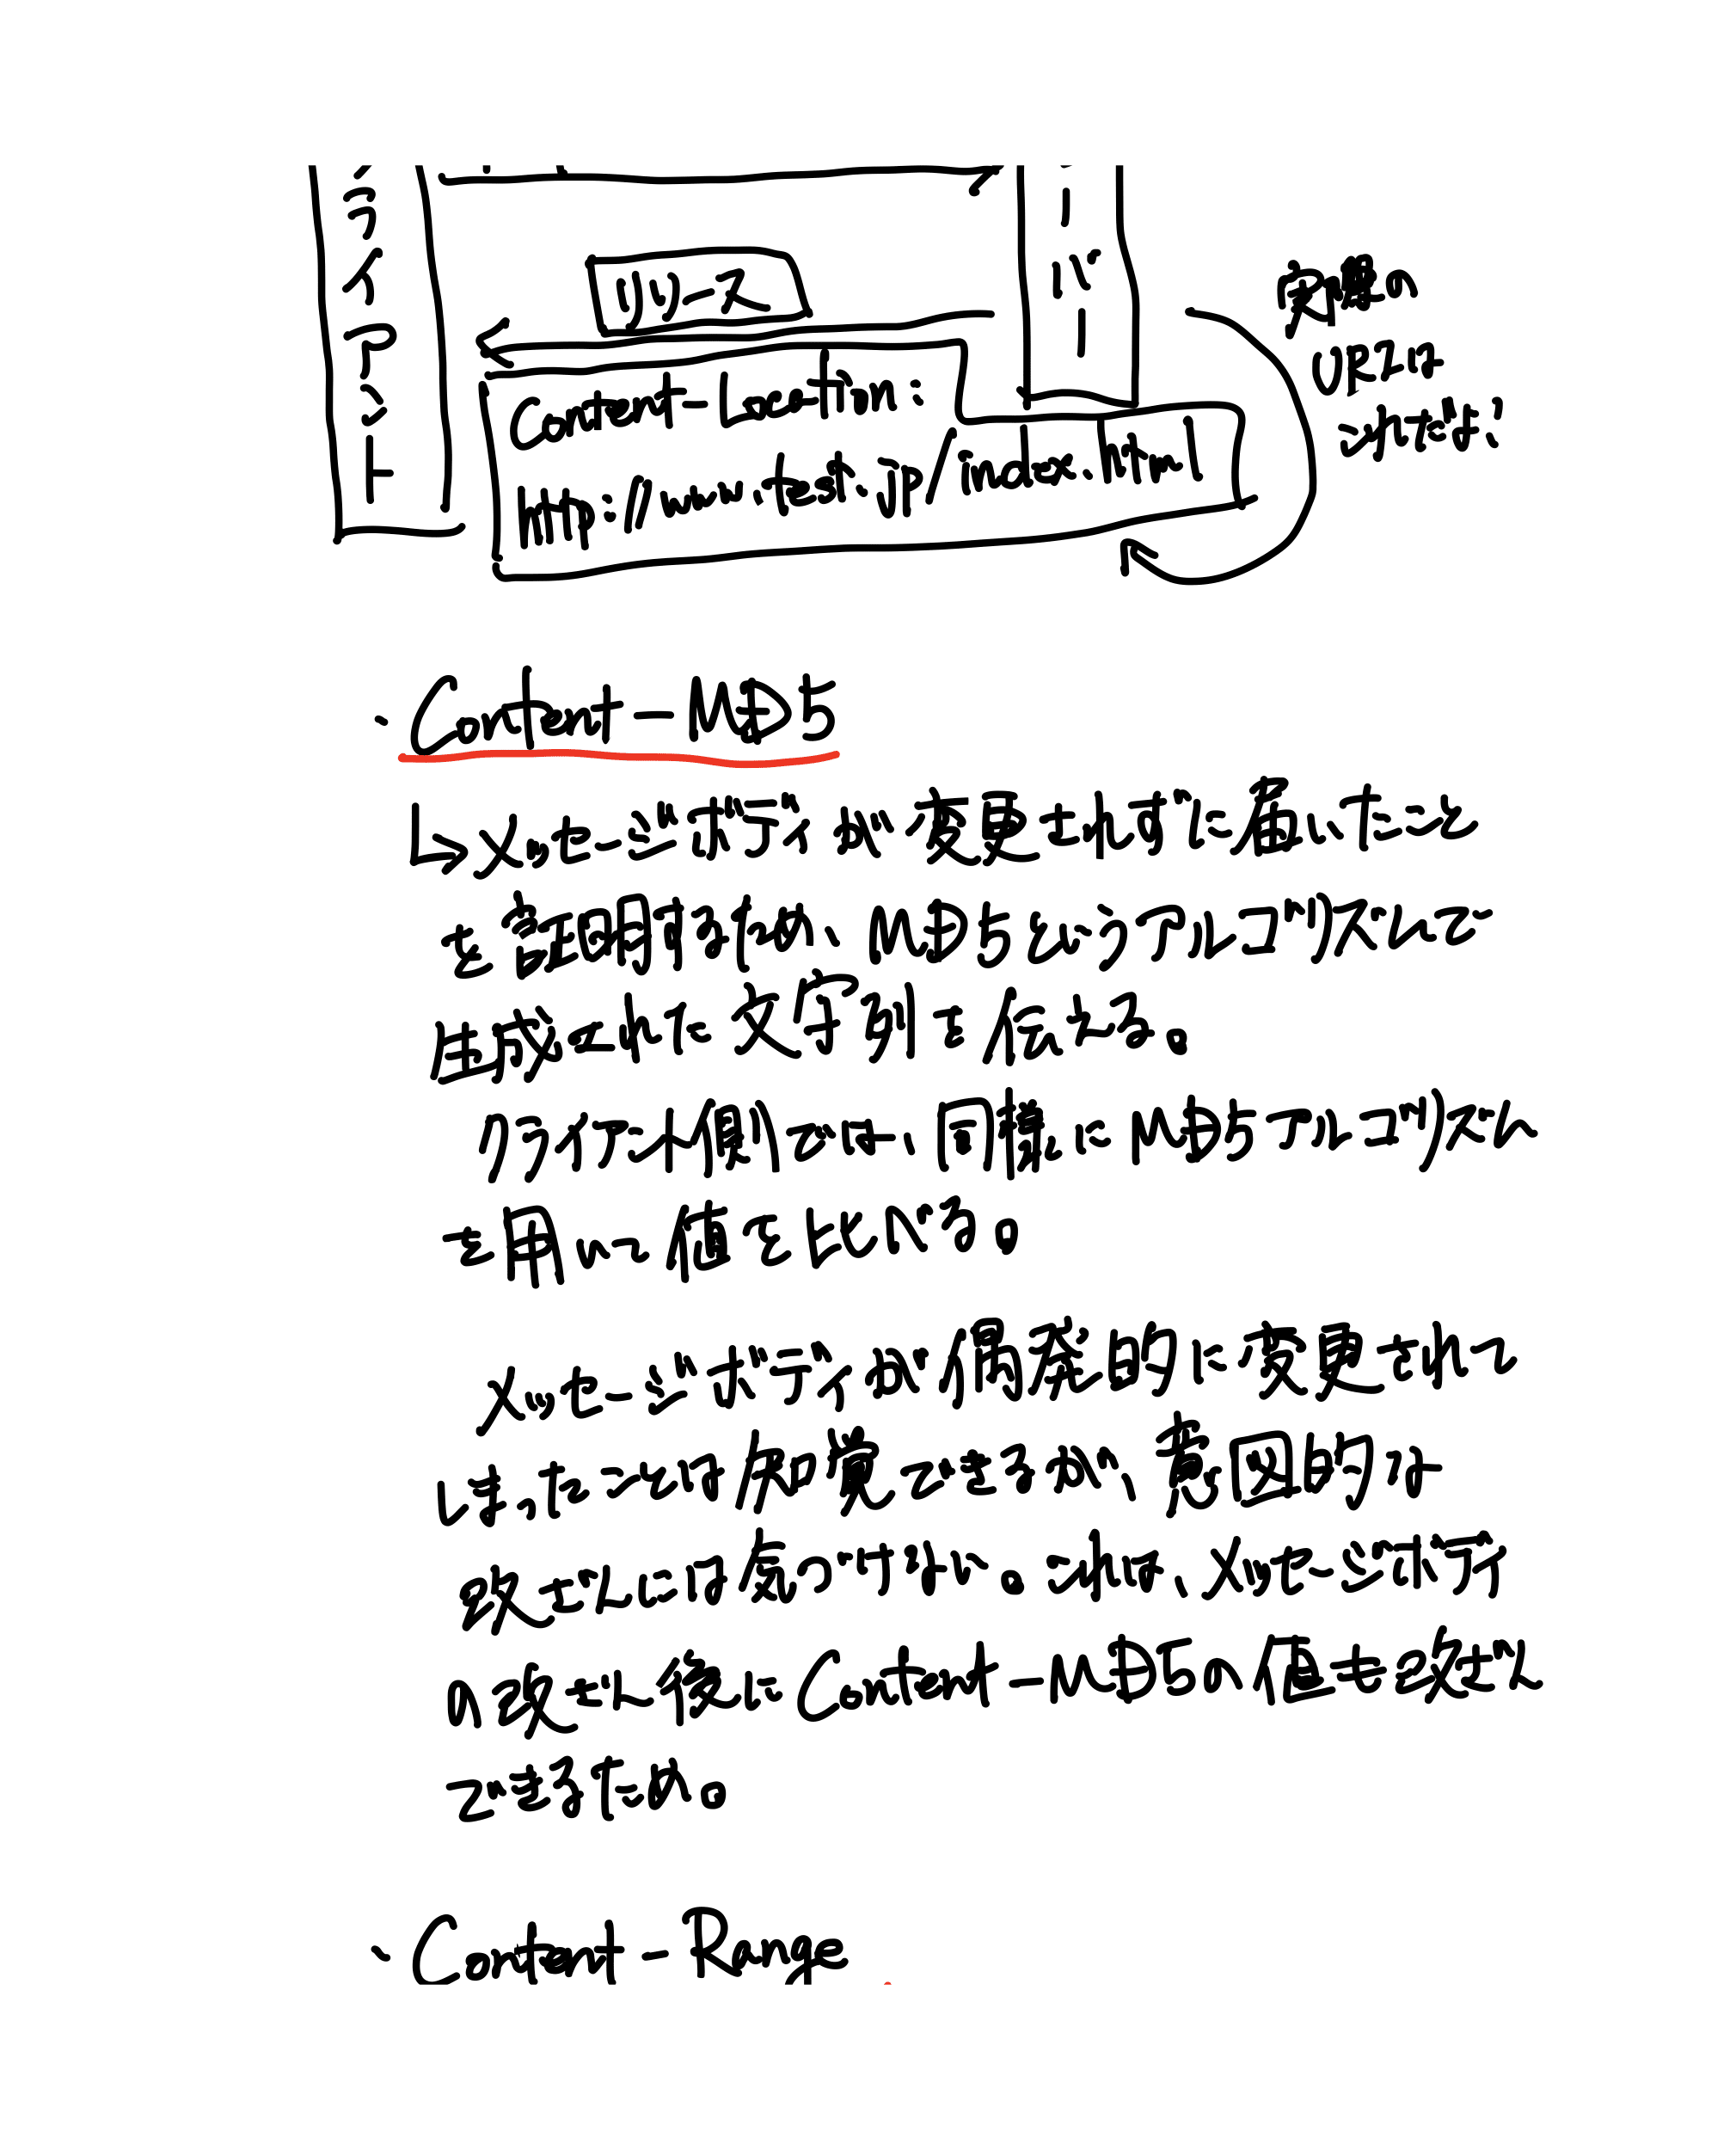
- Content-Location → メッセージボディに対応する URI を返す(Location とは異なる)。
- Content-MD5 → メッセージボディが変更されずに届いたことを証明するため、MD5 で生成した文字列を伝える。偶発的な変更は検知できるが、意図的な改ざん(MD5値も改ざん)には気づけない。
- Content-Range → Range リクエストへのレスポンスで、送っているエンティティがどの範囲かを示す。
- Content-Type → エンティティボディのメディアタイプを伝える。
- Expires → リソースの有効期限の日時。期限までキャッシュから、過ぎたらオリジンから再取得。Cache-Control の max-age 指定時はそちらが優先。
- Last-Modified → リソースが最後に更新された日時。
Cookie のためのヘッダーフィールド
- Cookie には4種類の仕様書がある:
- Netscape 社による仕様 → Cookie を考案した Netscape 社のもの。現在最も普及している元。
- RFC 2109 → 現在は廃版。Cookie 標準化のために作られた。
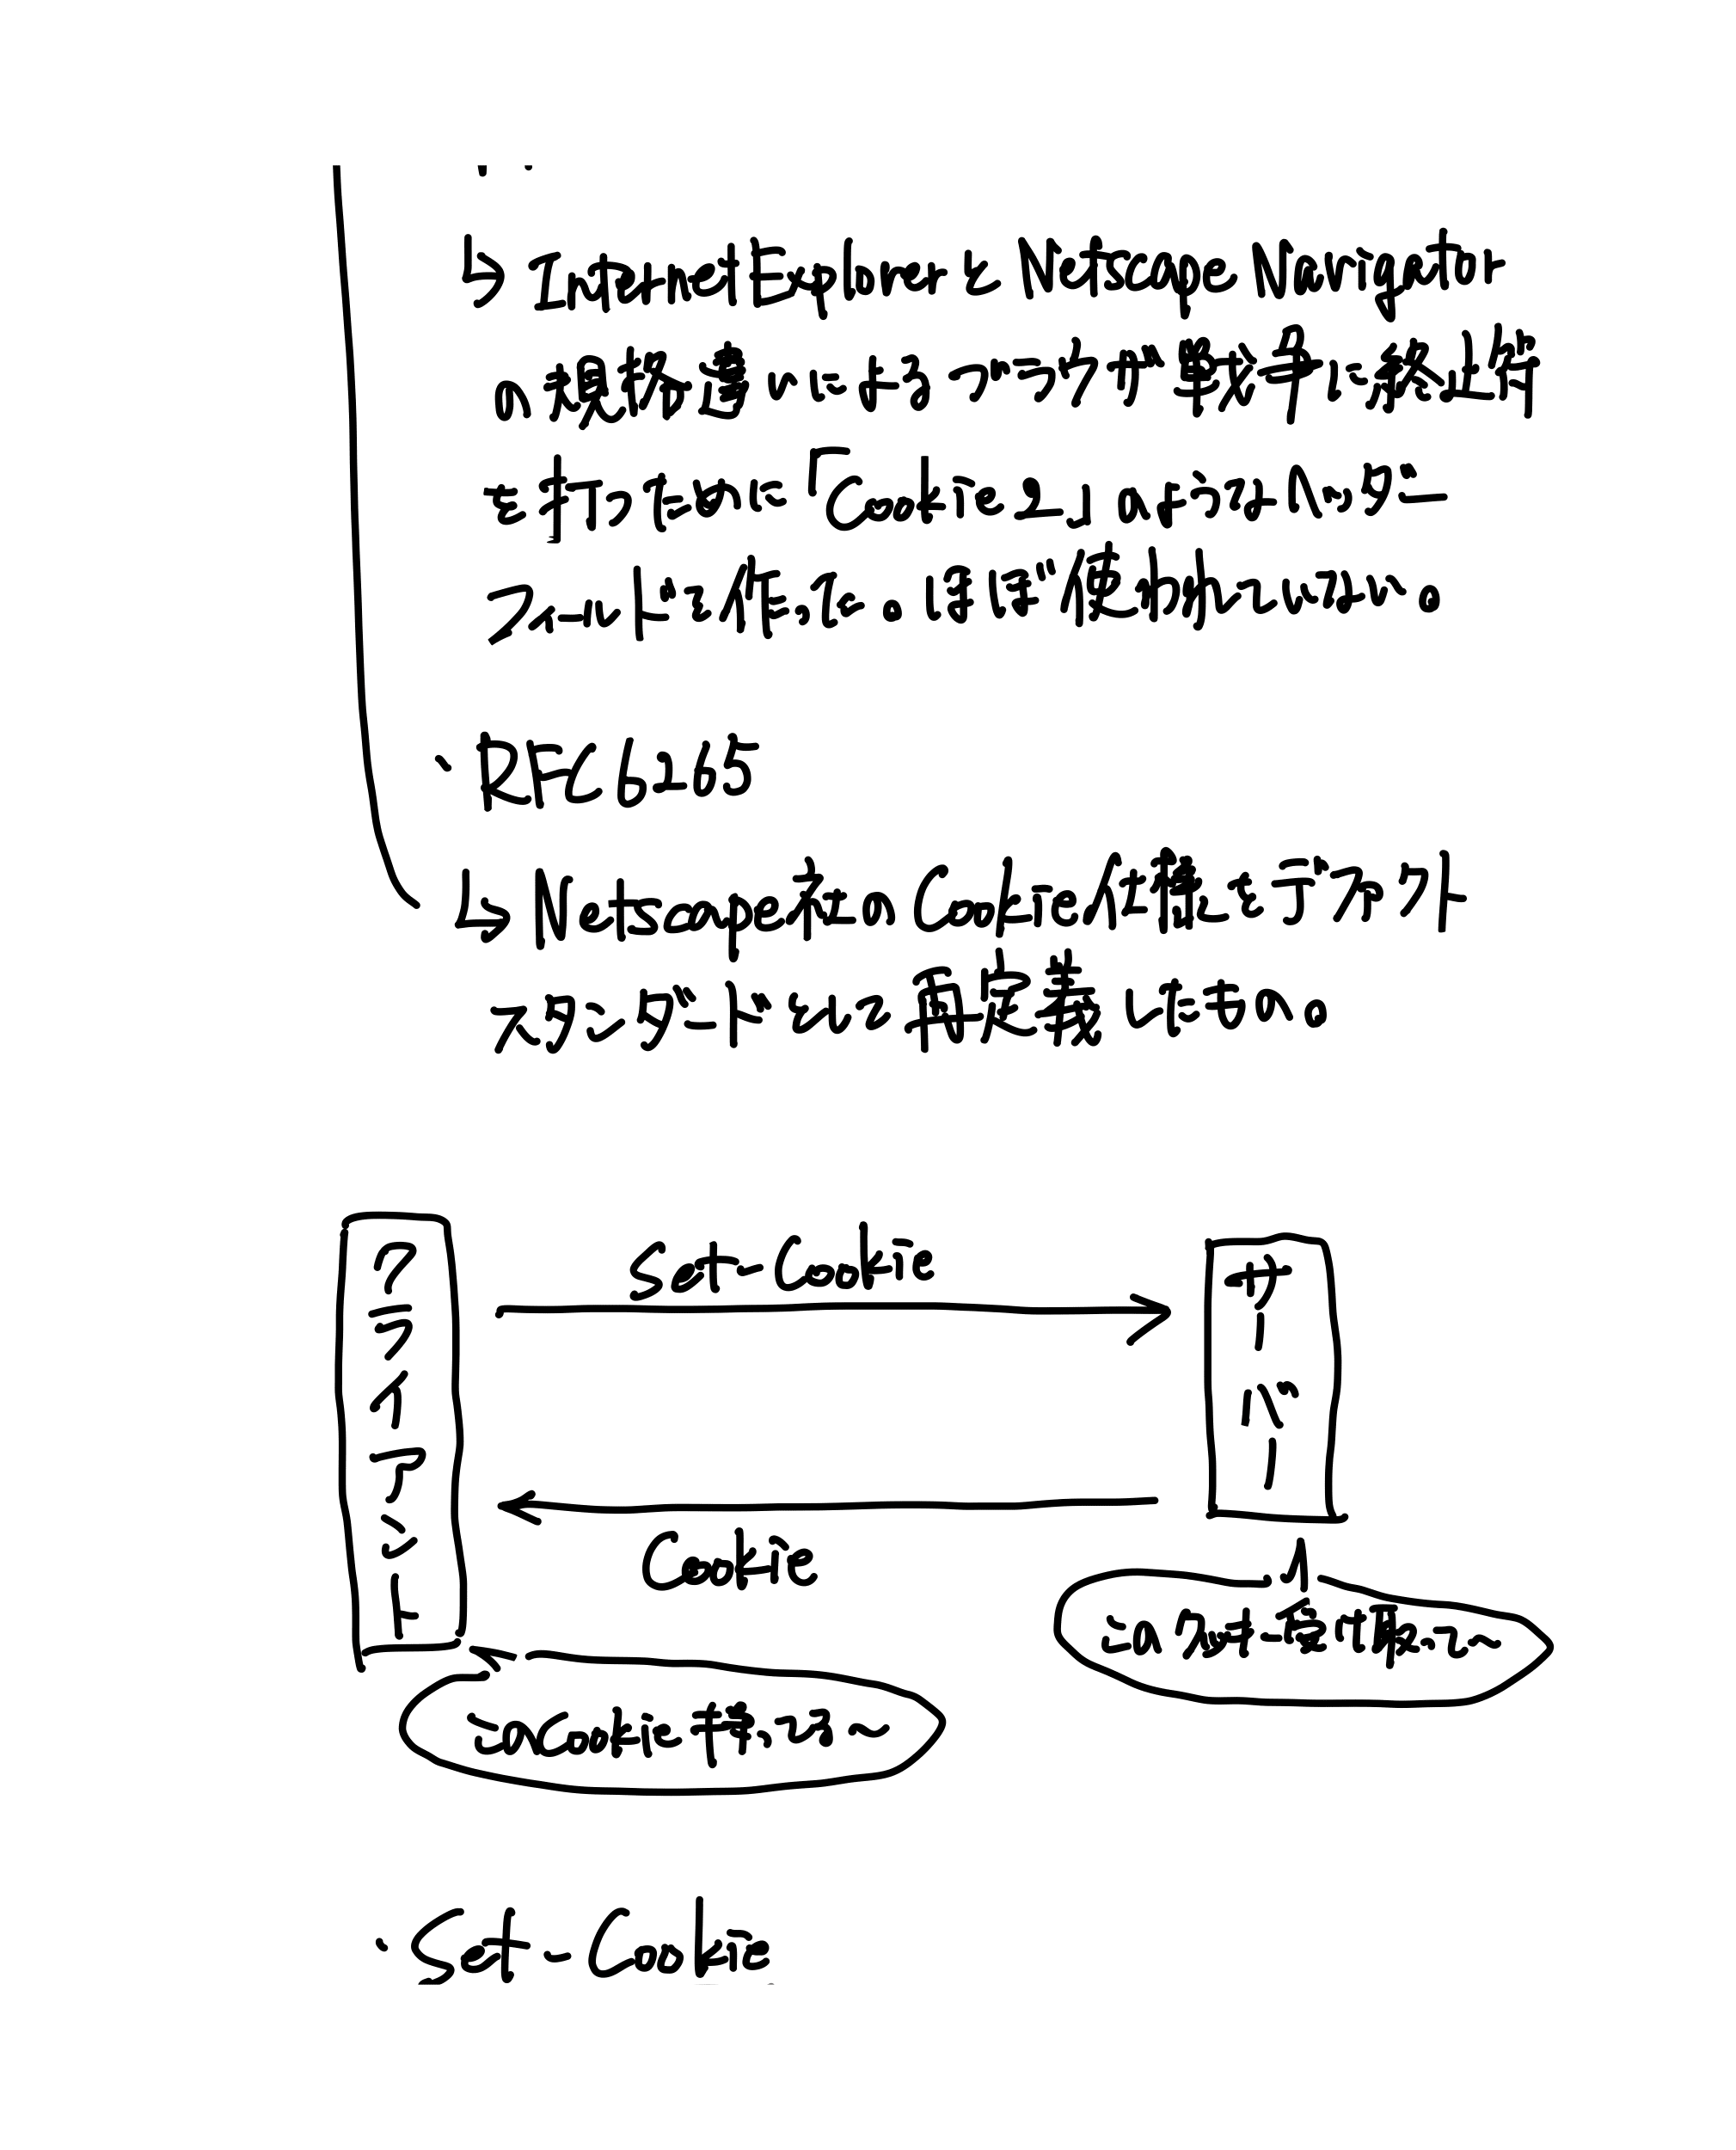
- RFC 2965 → ブラウザ戦争に終止符を打つため「Cookie2」的なヘッダーを作ったが、ほぼ使われていない。
- RFC 6265 → Netscape 社の Cookie 仕様をデファクトスタンダードとして再定義。
- Set-Cookie → サーバーがクライアントに状態管理を始める際に様々な情報を伝える。
- フィールド値:NAME(必須)、expires、path、domain、Secure、HttpOnly
- Secure → HTTPSのときだけ Cookie 送信
- HttpOnly → JS からアクセスできないよう制限 → XSS による窃取を防ぐ
- Cookie → サーバーから受け取った Cookie を、以後のリクエストに含めて伝える。
その他のヘッダーフィールド(独自拡張)
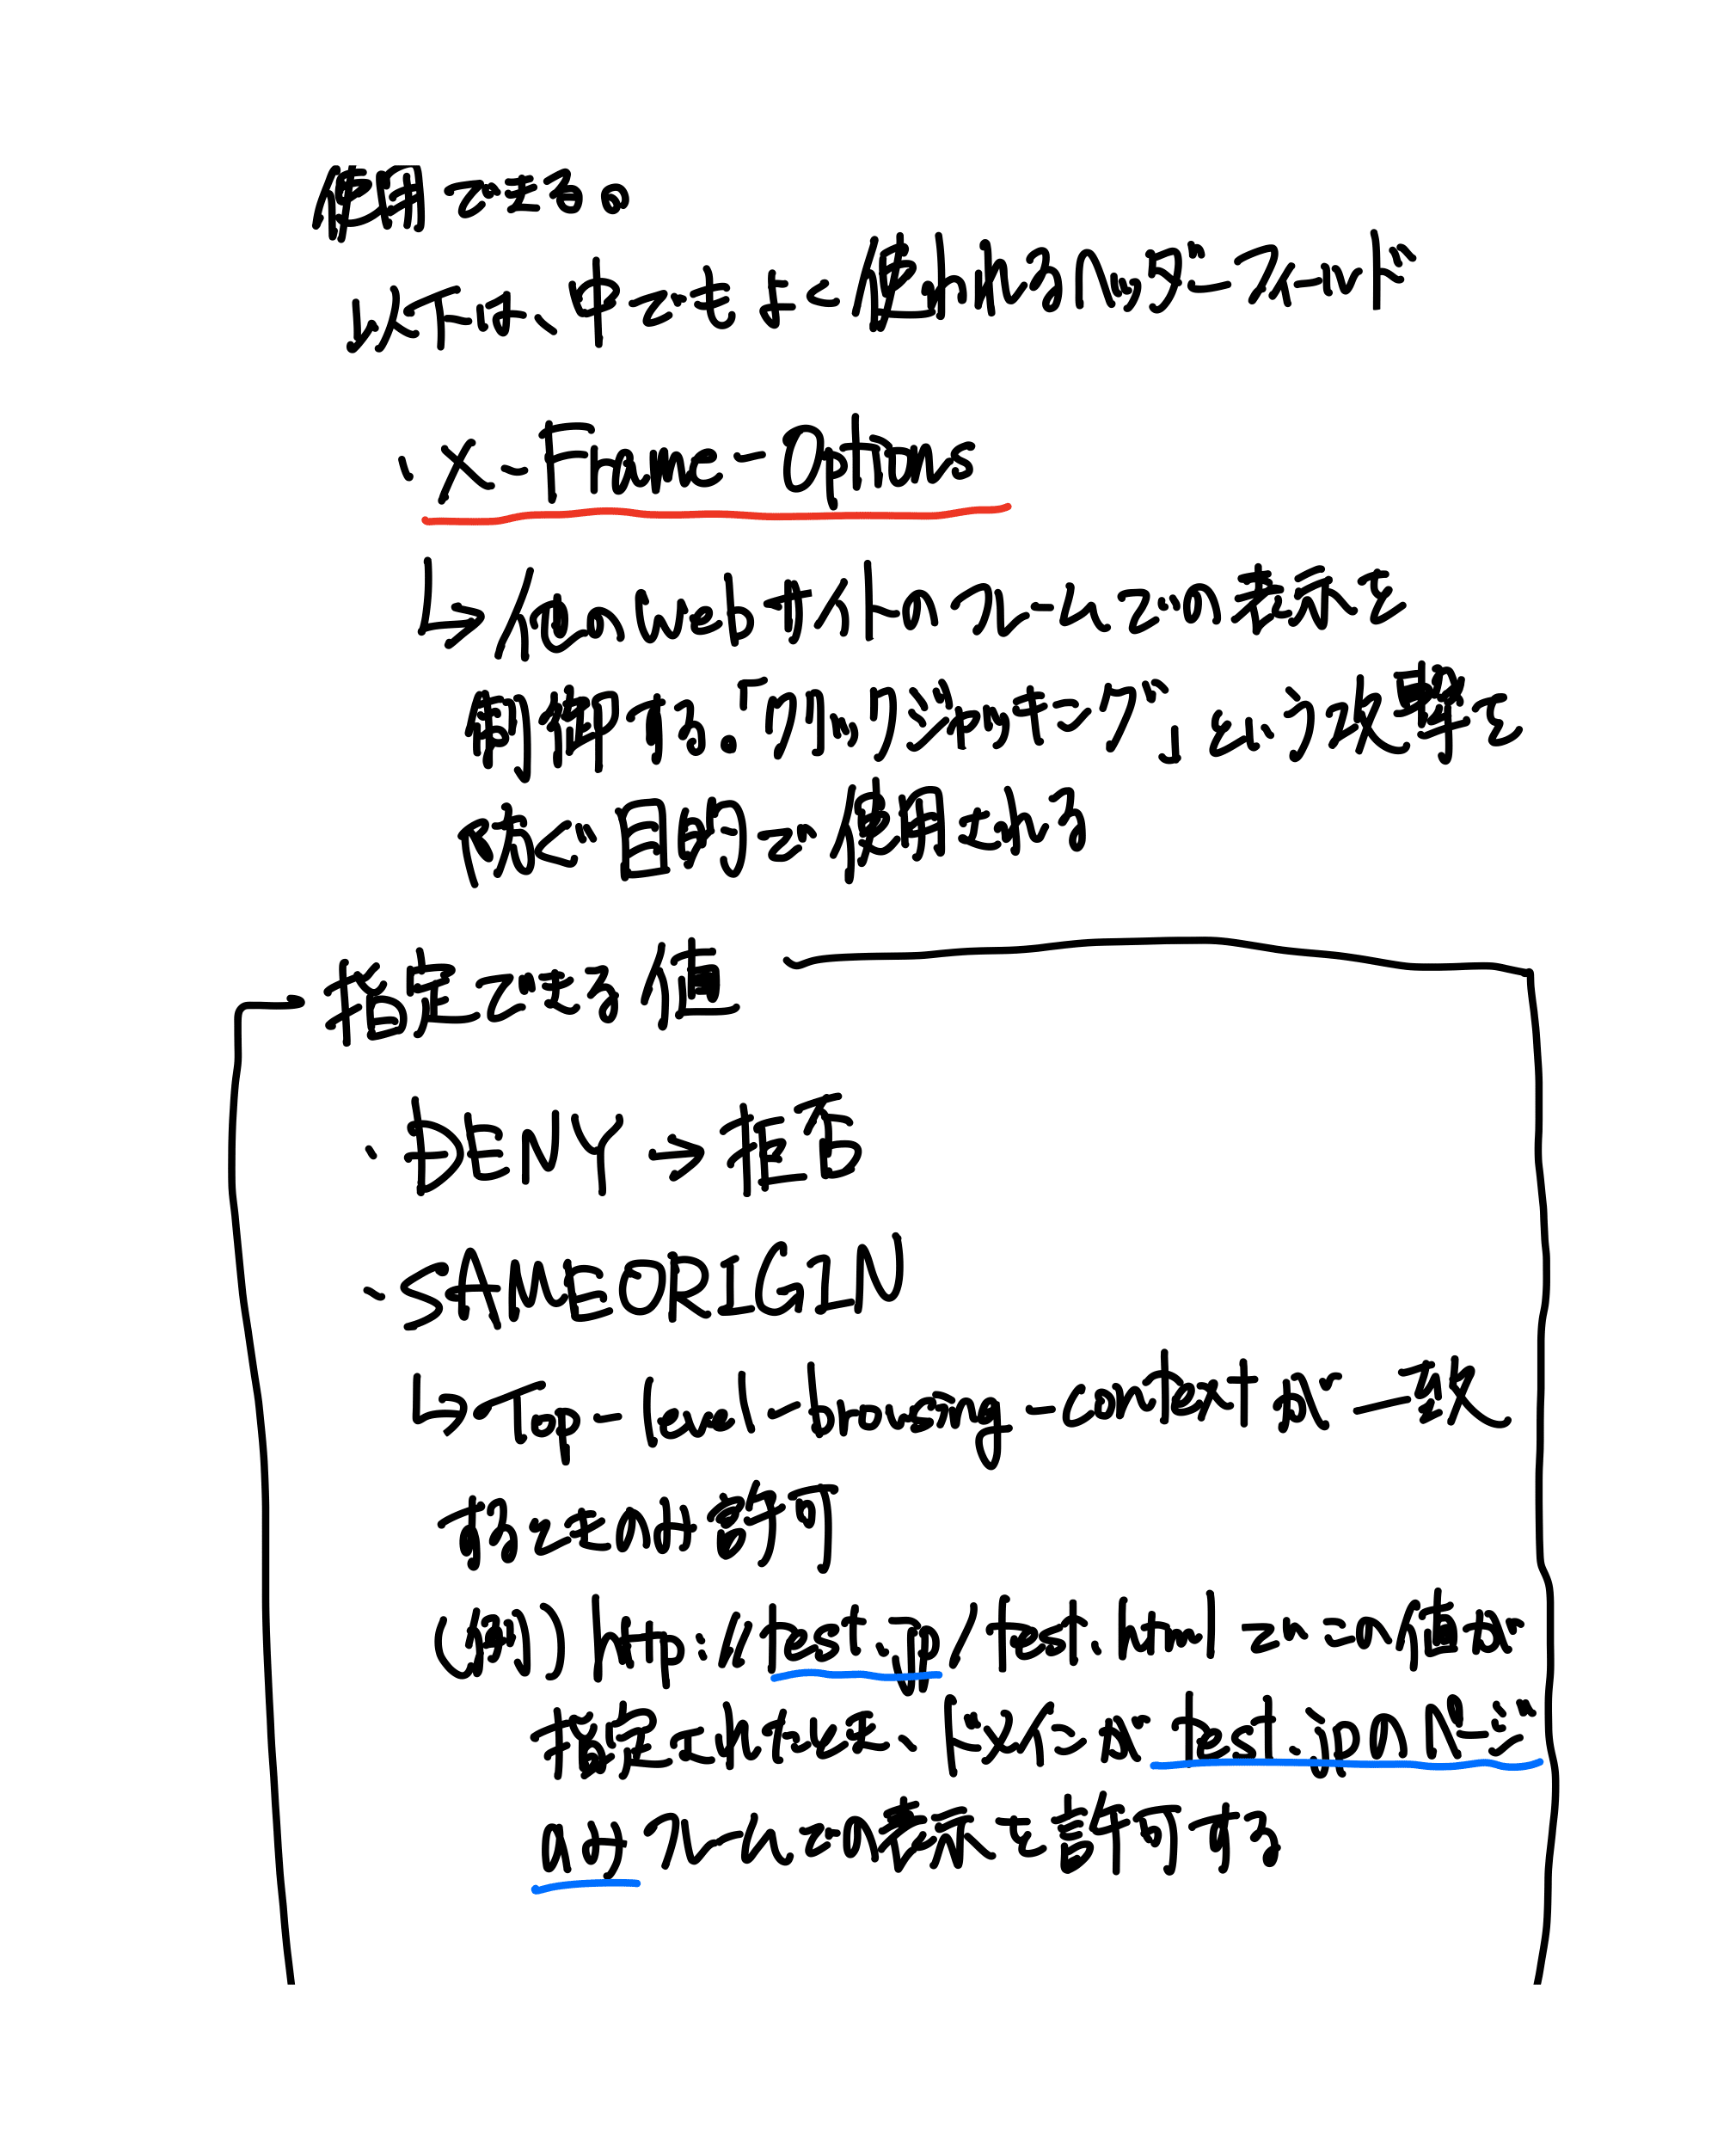
- X-Frame-Options → 他サイトのフレームでの表示を制御し「クリックジャッキング」を防ぐ。
- DENY → 拒否 / SAMEORIGIN → Top-level-browsing-context が一致するときのみ許可
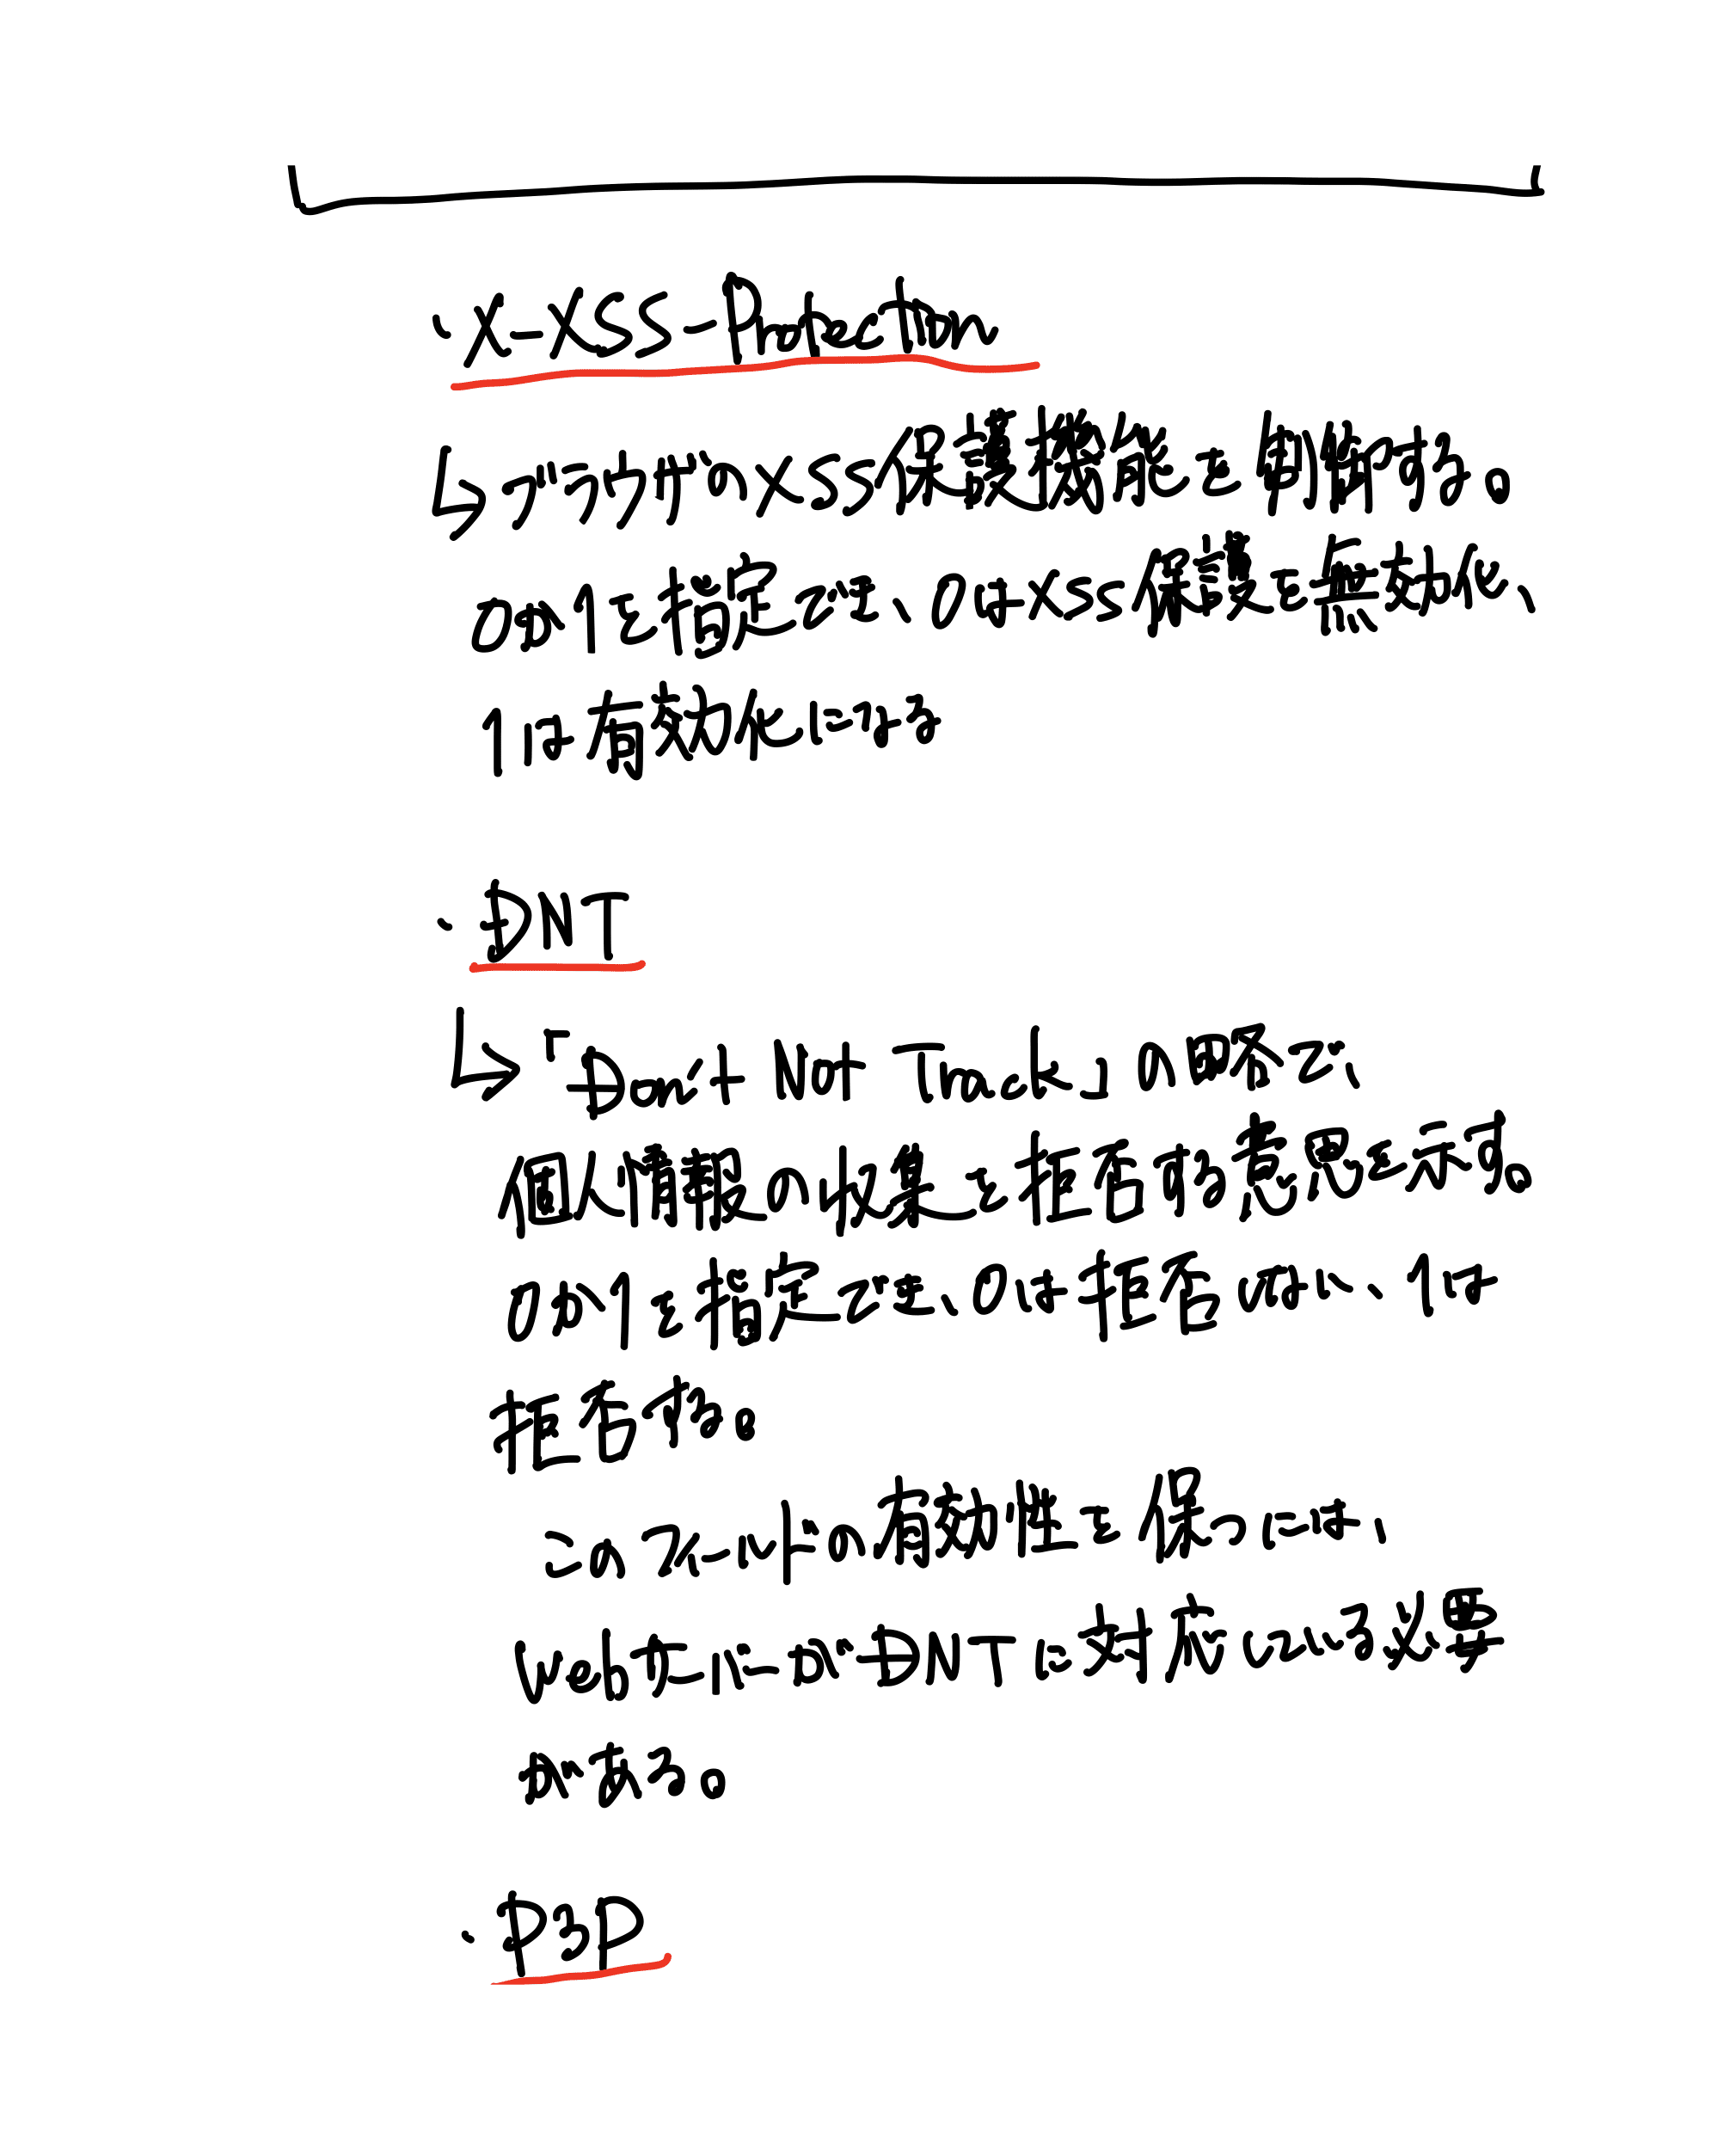
- X-XSS-Protection → ブラウザのXSS保護機能を制御(0=無効、1=有効)。
- DNT → 「Do Not Track」。個人情報の収集拒否の意思(0=拒否しない、1=拒否する)。サーバーがDNT対応している必要がある。
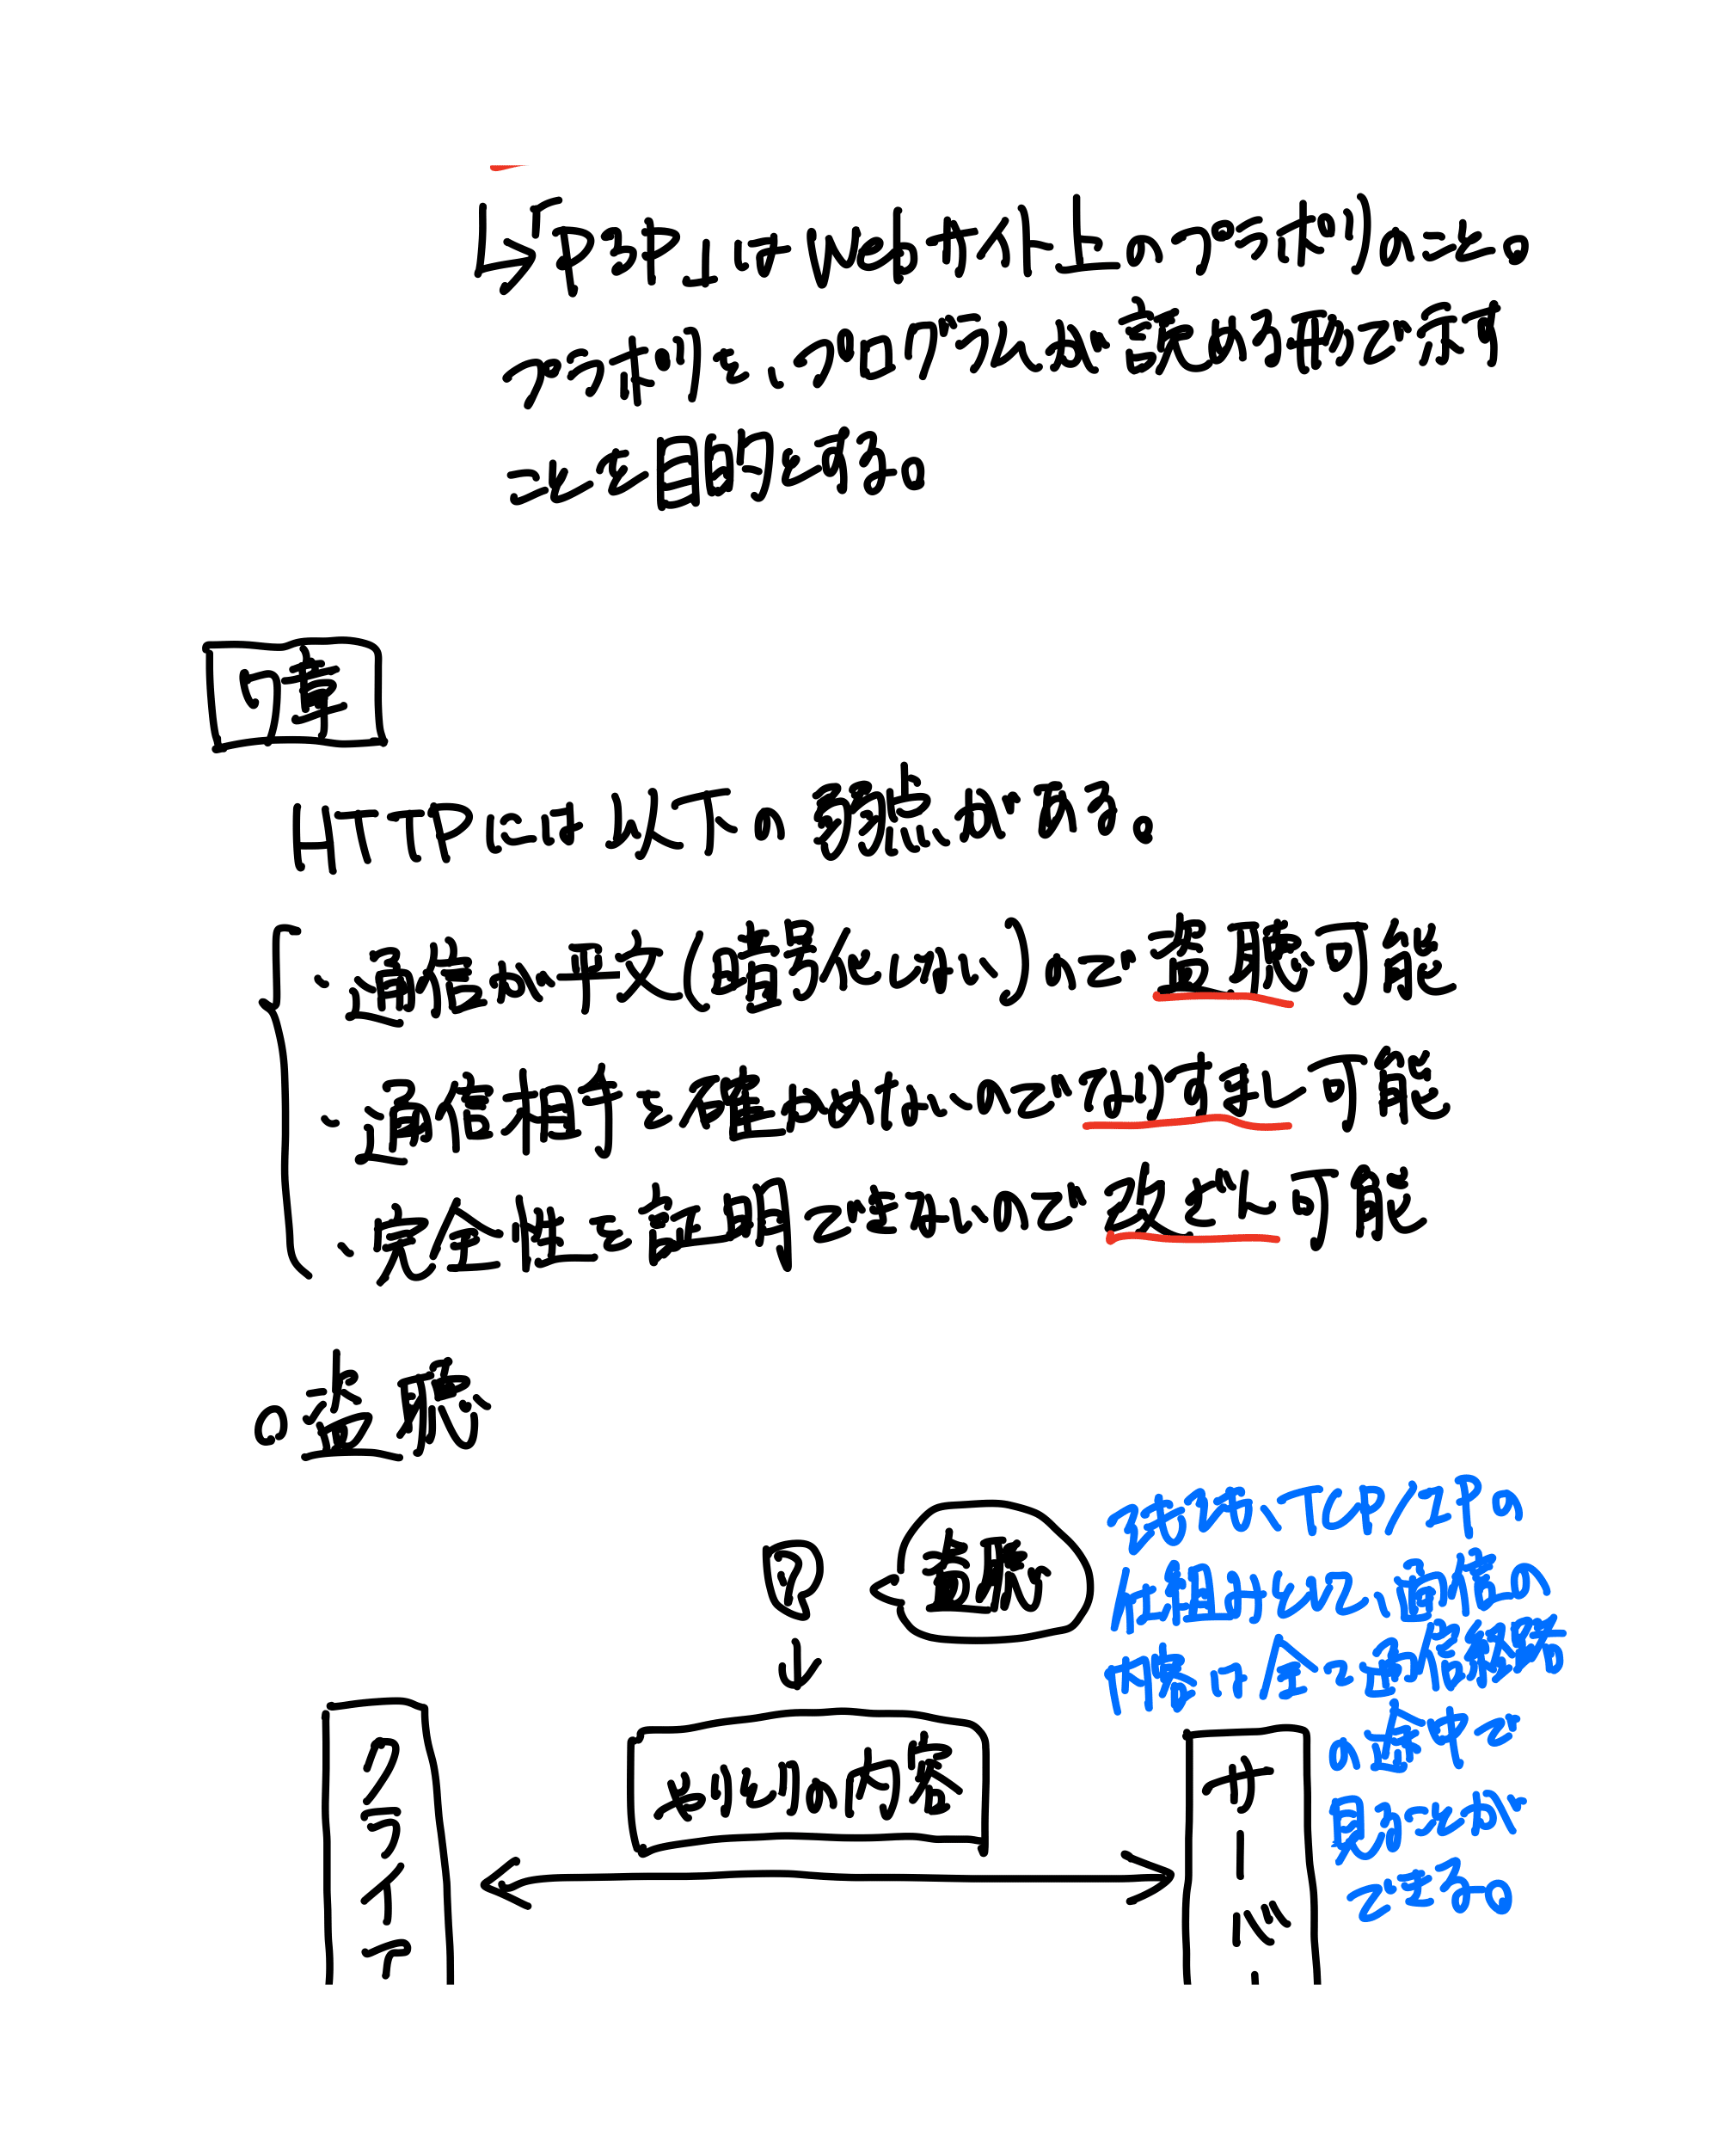
- P3P → Webサイト上のプライバシーを、プログラムが読める形で示すことを目的とする。
7章 HTTPの弱点とHTTPS
HTTPには以下の弱点がある。
- 通信が平文(暗号化しない)ので盗聴可能
- 通信相手を確かめないのでなりすまし可能
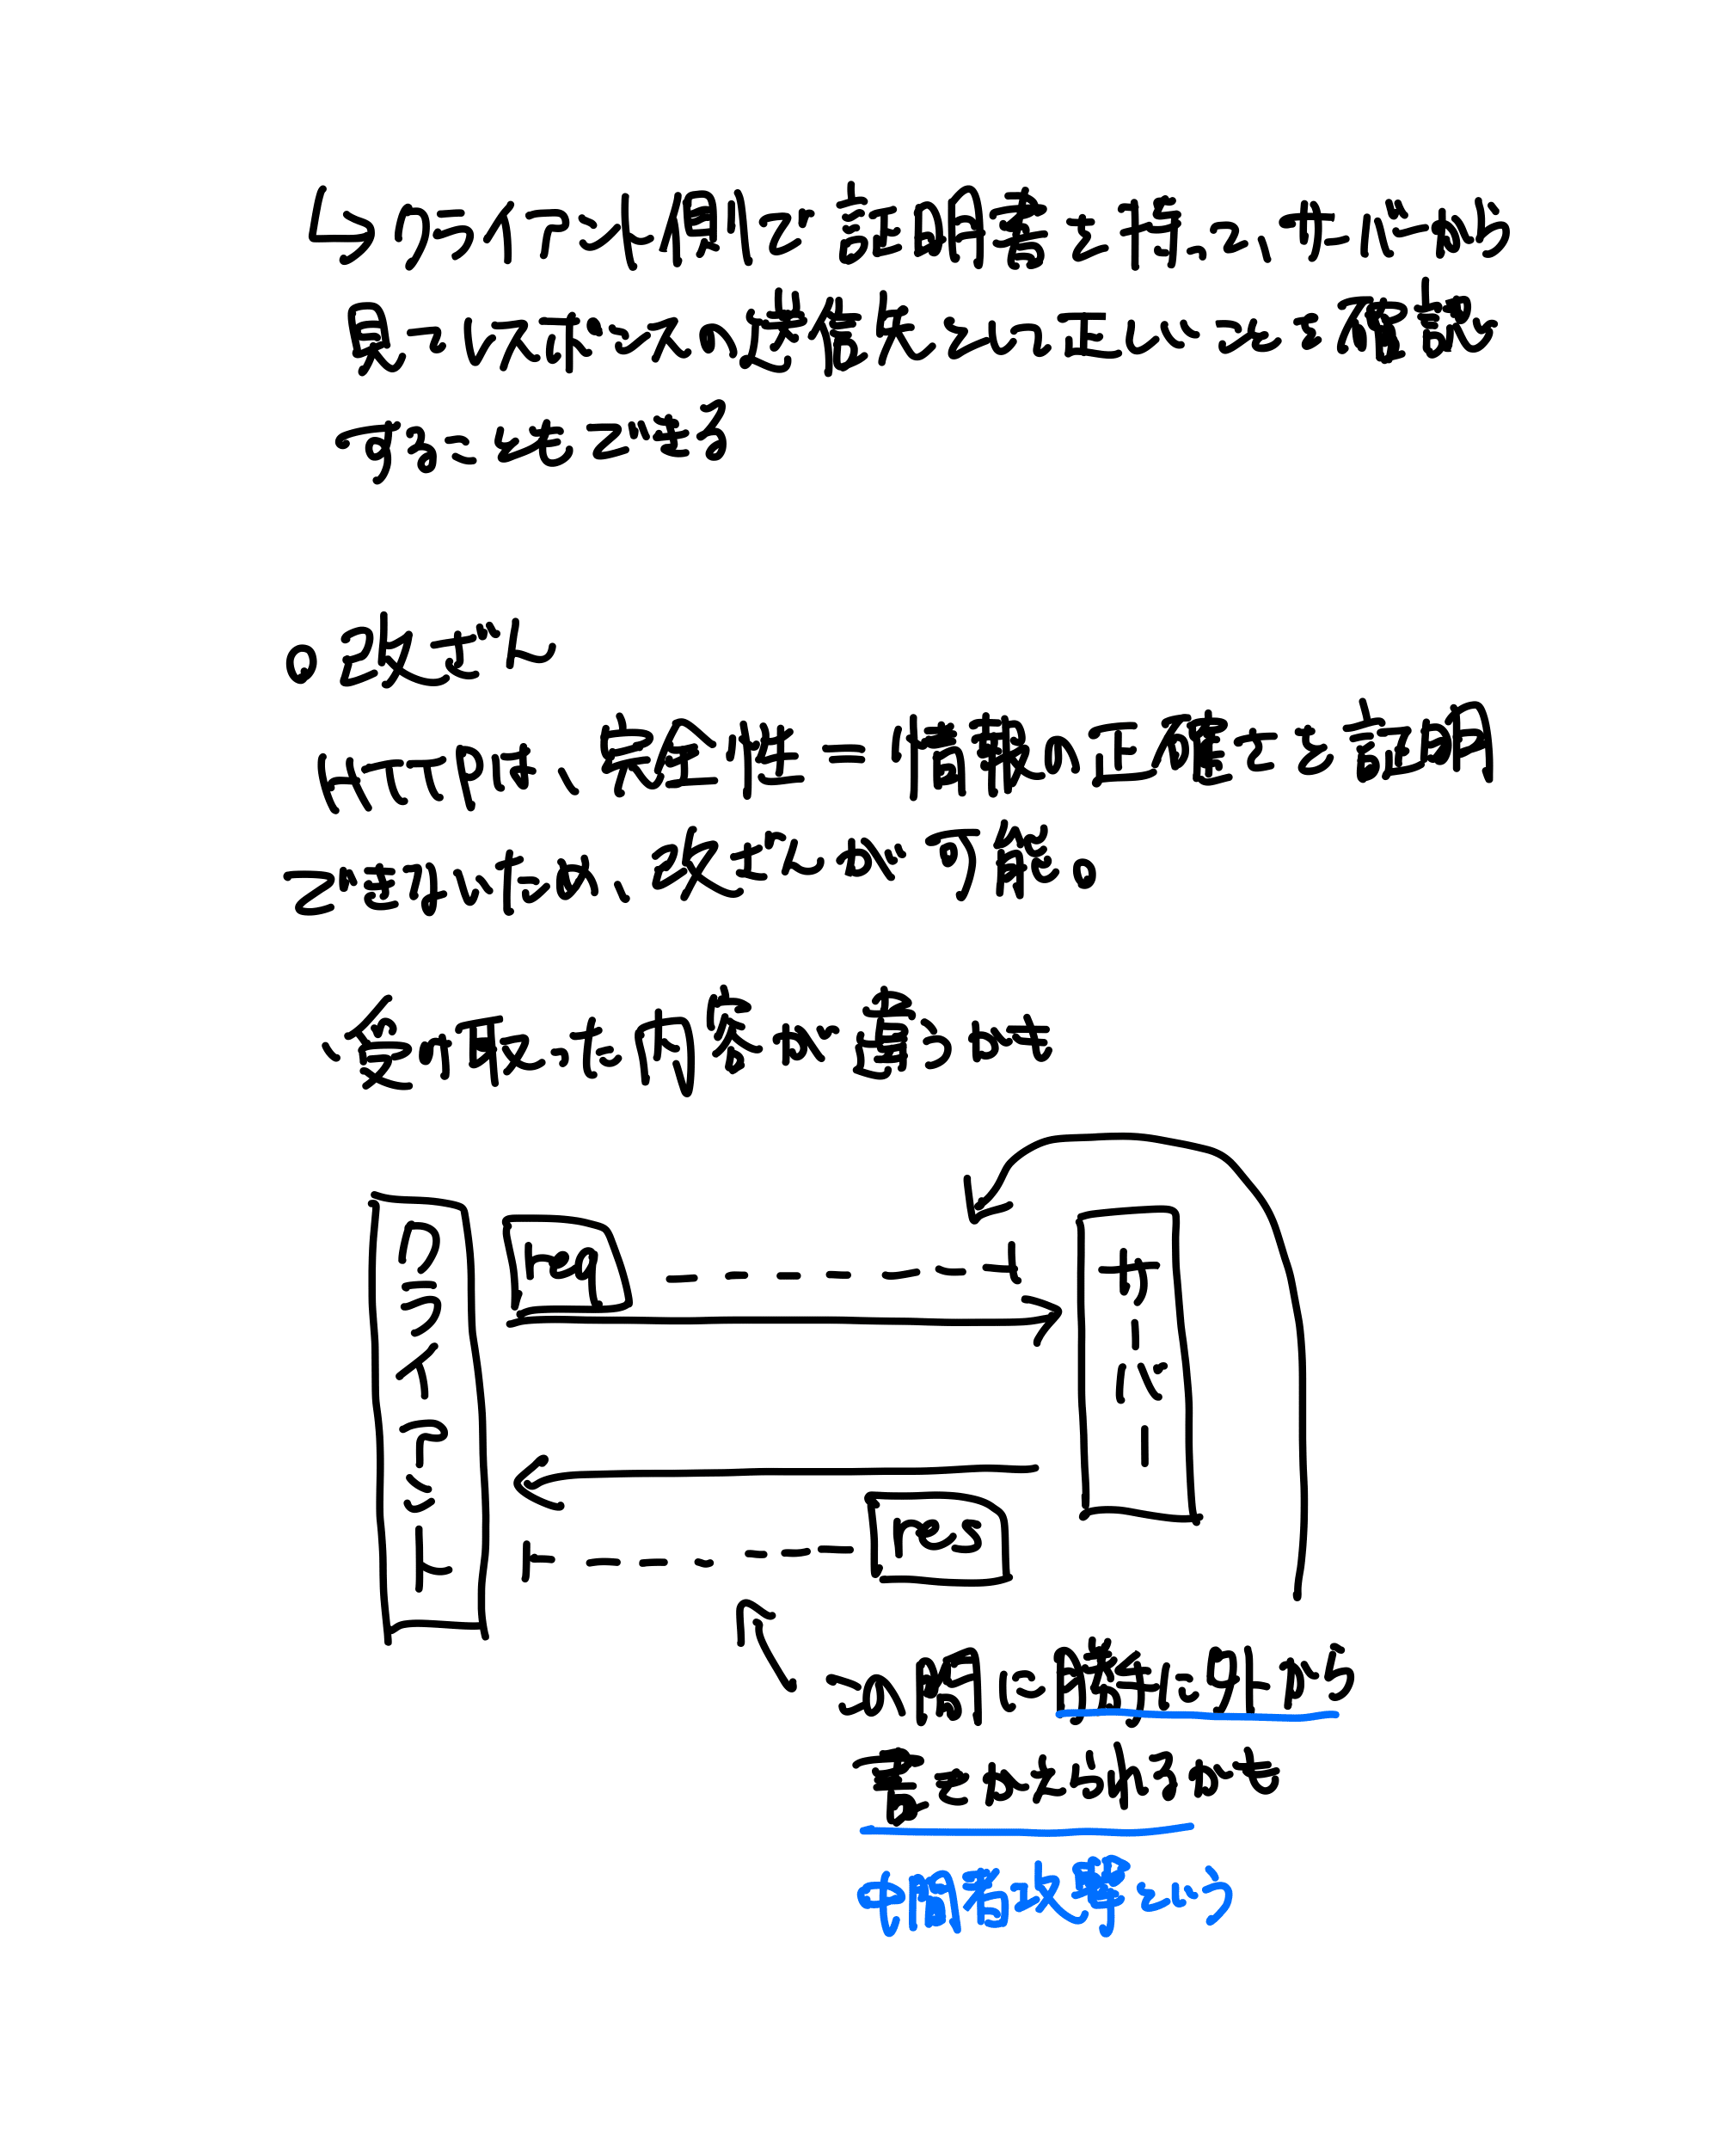
- 完全性を証明できないので改ざん可能
盗聴
- そもそもTCP/IPの仕組みとして、通信の内容は全て通信経路の途中で見ることができる。
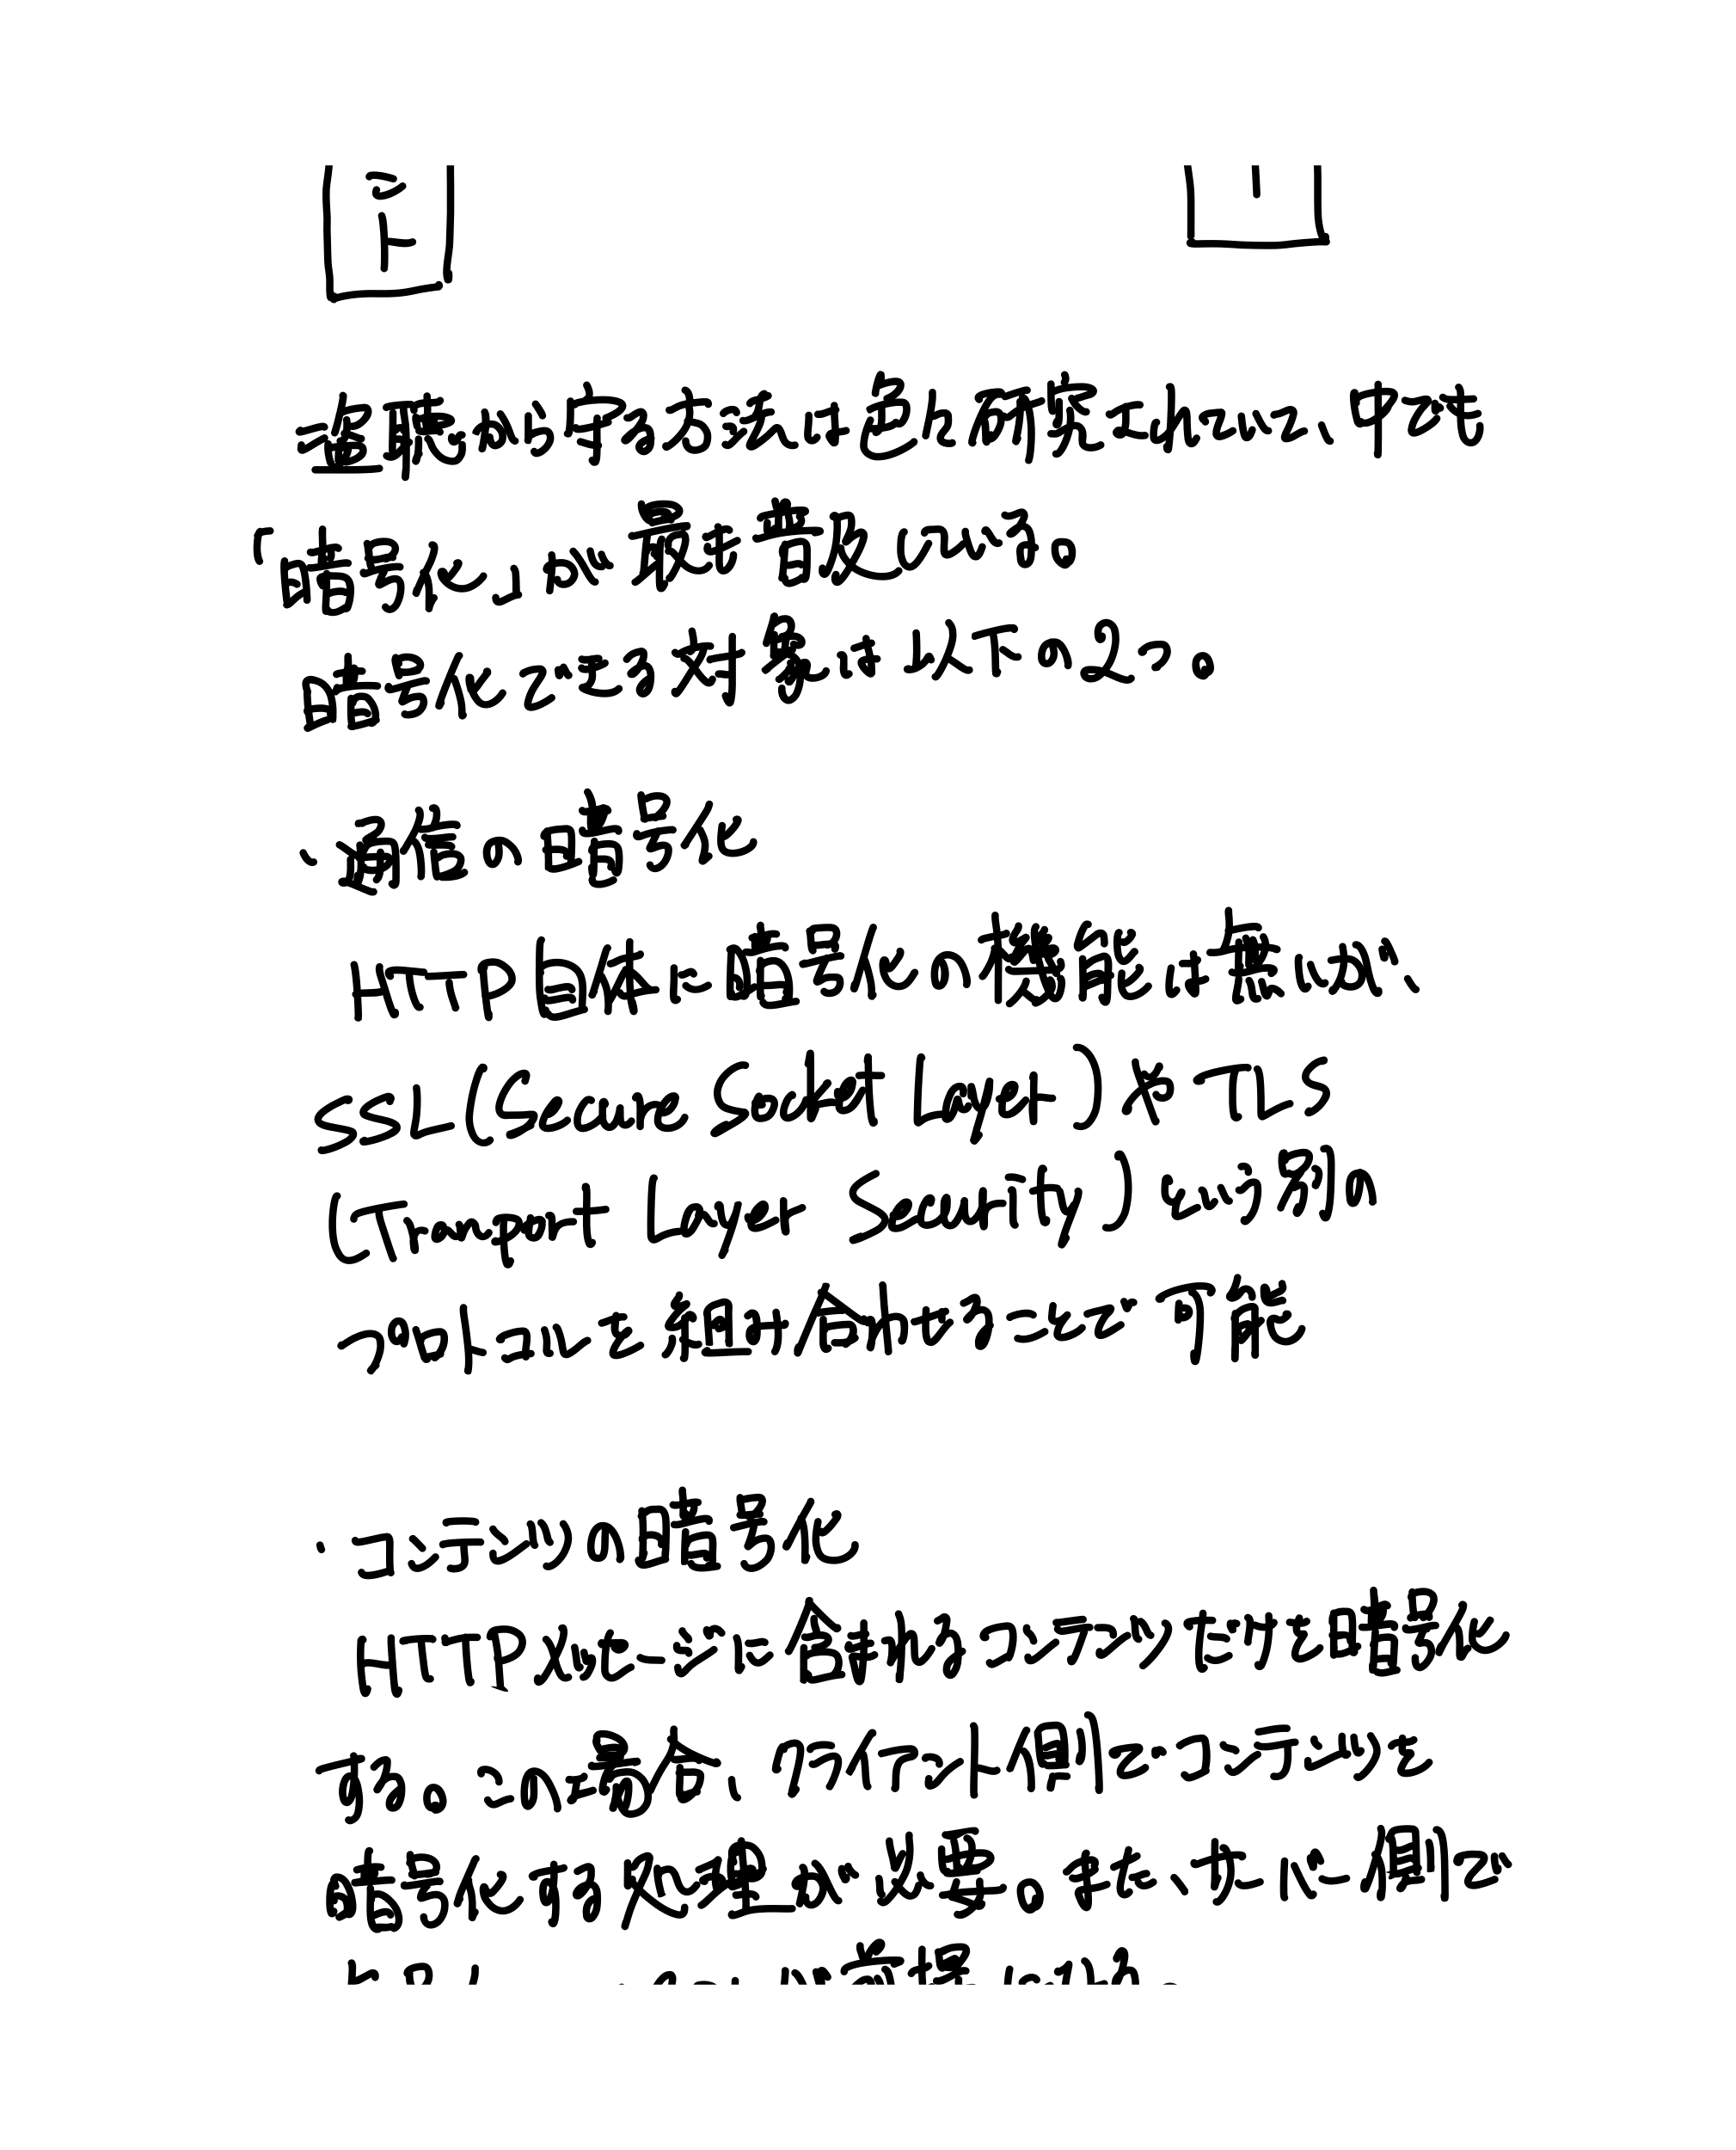
- 対策として「暗号化」が最も普及。対象は2つ:
- 通信の暗号化 → HTTP自体に暗号化機能はないが、SSL(Secure Socket Layer)や TLS(Transport Layer Security)を組み合わせることで可能。
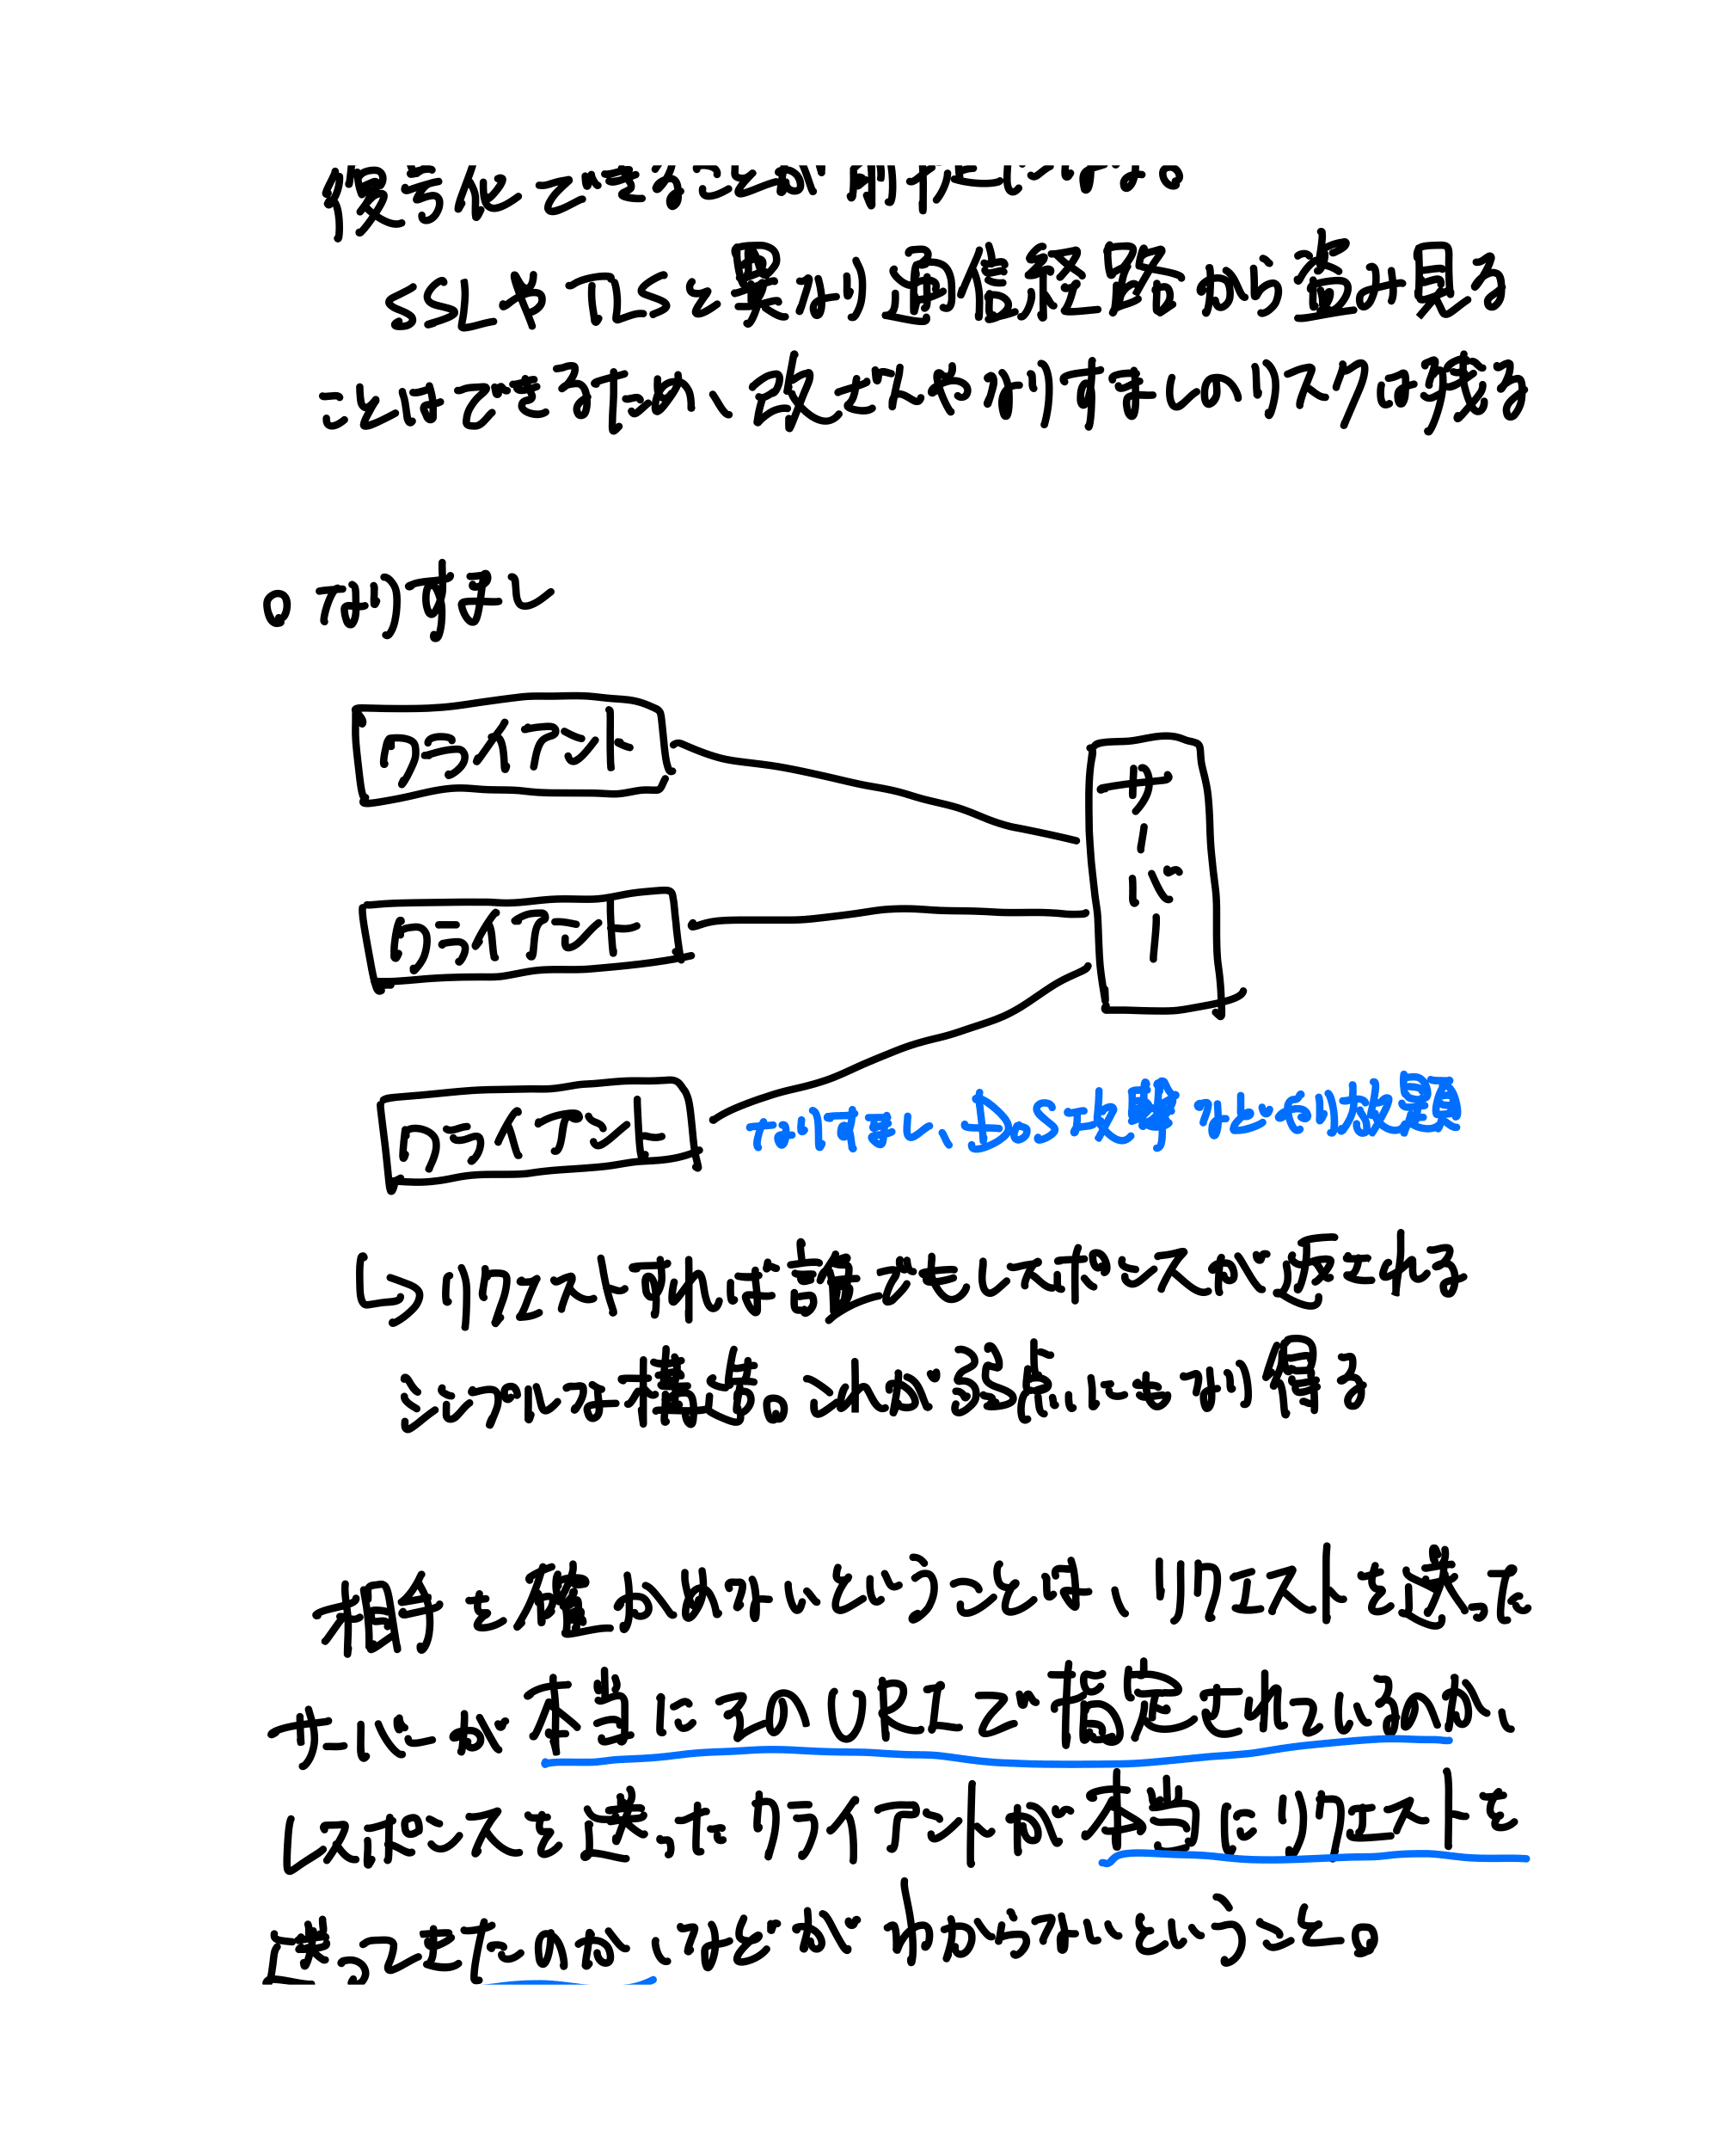
- コンテンツの暗号化 → HTTPメッセージのコンテンツだけを暗号化。クライアント側で暗号化、サーバー側で復号化できることが要件。SSL/TLSと違い通信経路から盗み見ることはできるため、改ざん・なりすましのリスクは残る。
なりすまし
- リクエストすれば誰にでもレスポンスが返るシンプルな構造 → これが弱点にもなり、なりすましやDoS攻撃がやり放題。
- 相手を確かめないと、リクエスト先のサーバーが本当に指定URLのものか、レスポンス先のクライアントが本当にリクエストを送ってきたのか、がわからない。
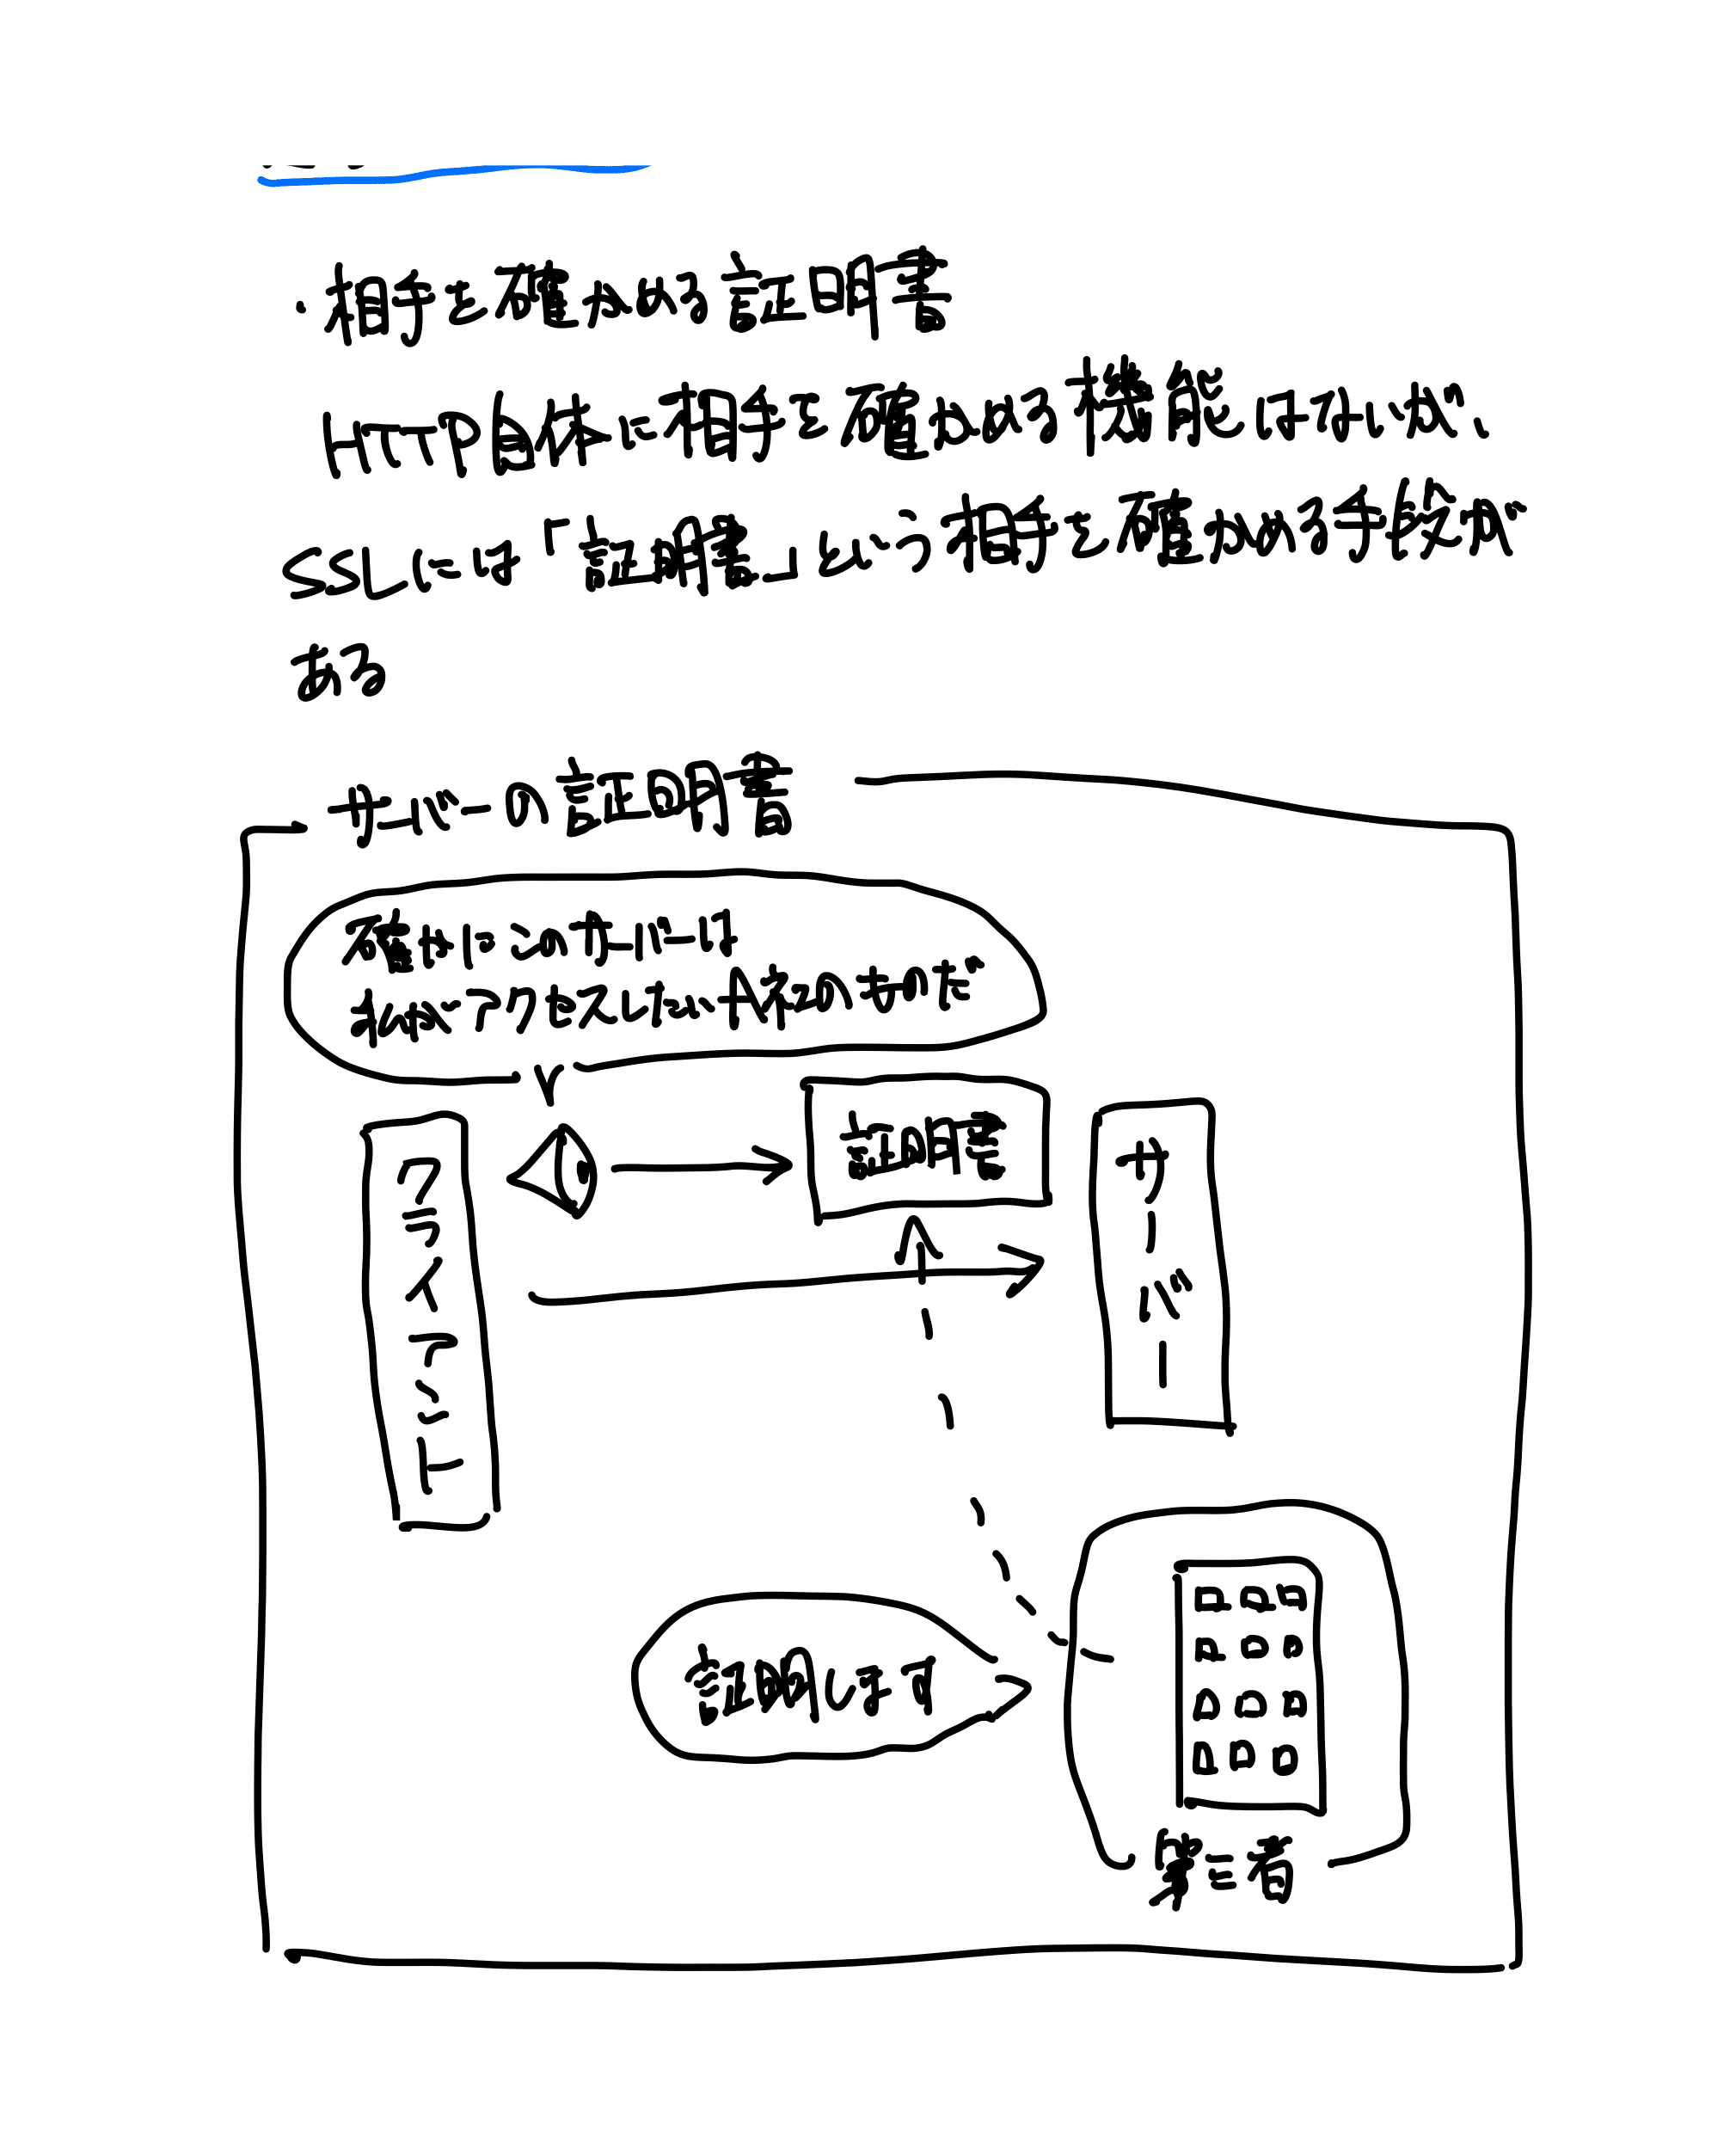
- 相手を確かめる証明書:HTTP自体に機能はないが、SSLには「証明書」という手段がある。
- サーバーの証明書 → 第三者が「確かにこのサーバーはアクセスしたいA社のもの」と証明する。
- クライアント側で証明書を持ち、レスポンスの送信先として正しいことを確認することもできる。
改ざん
- HTTPは完全性(情報の正確さ)を証明できないため、改ざんが可能。req/res の間で外から書きかえられるかも(中間者攻撃)。
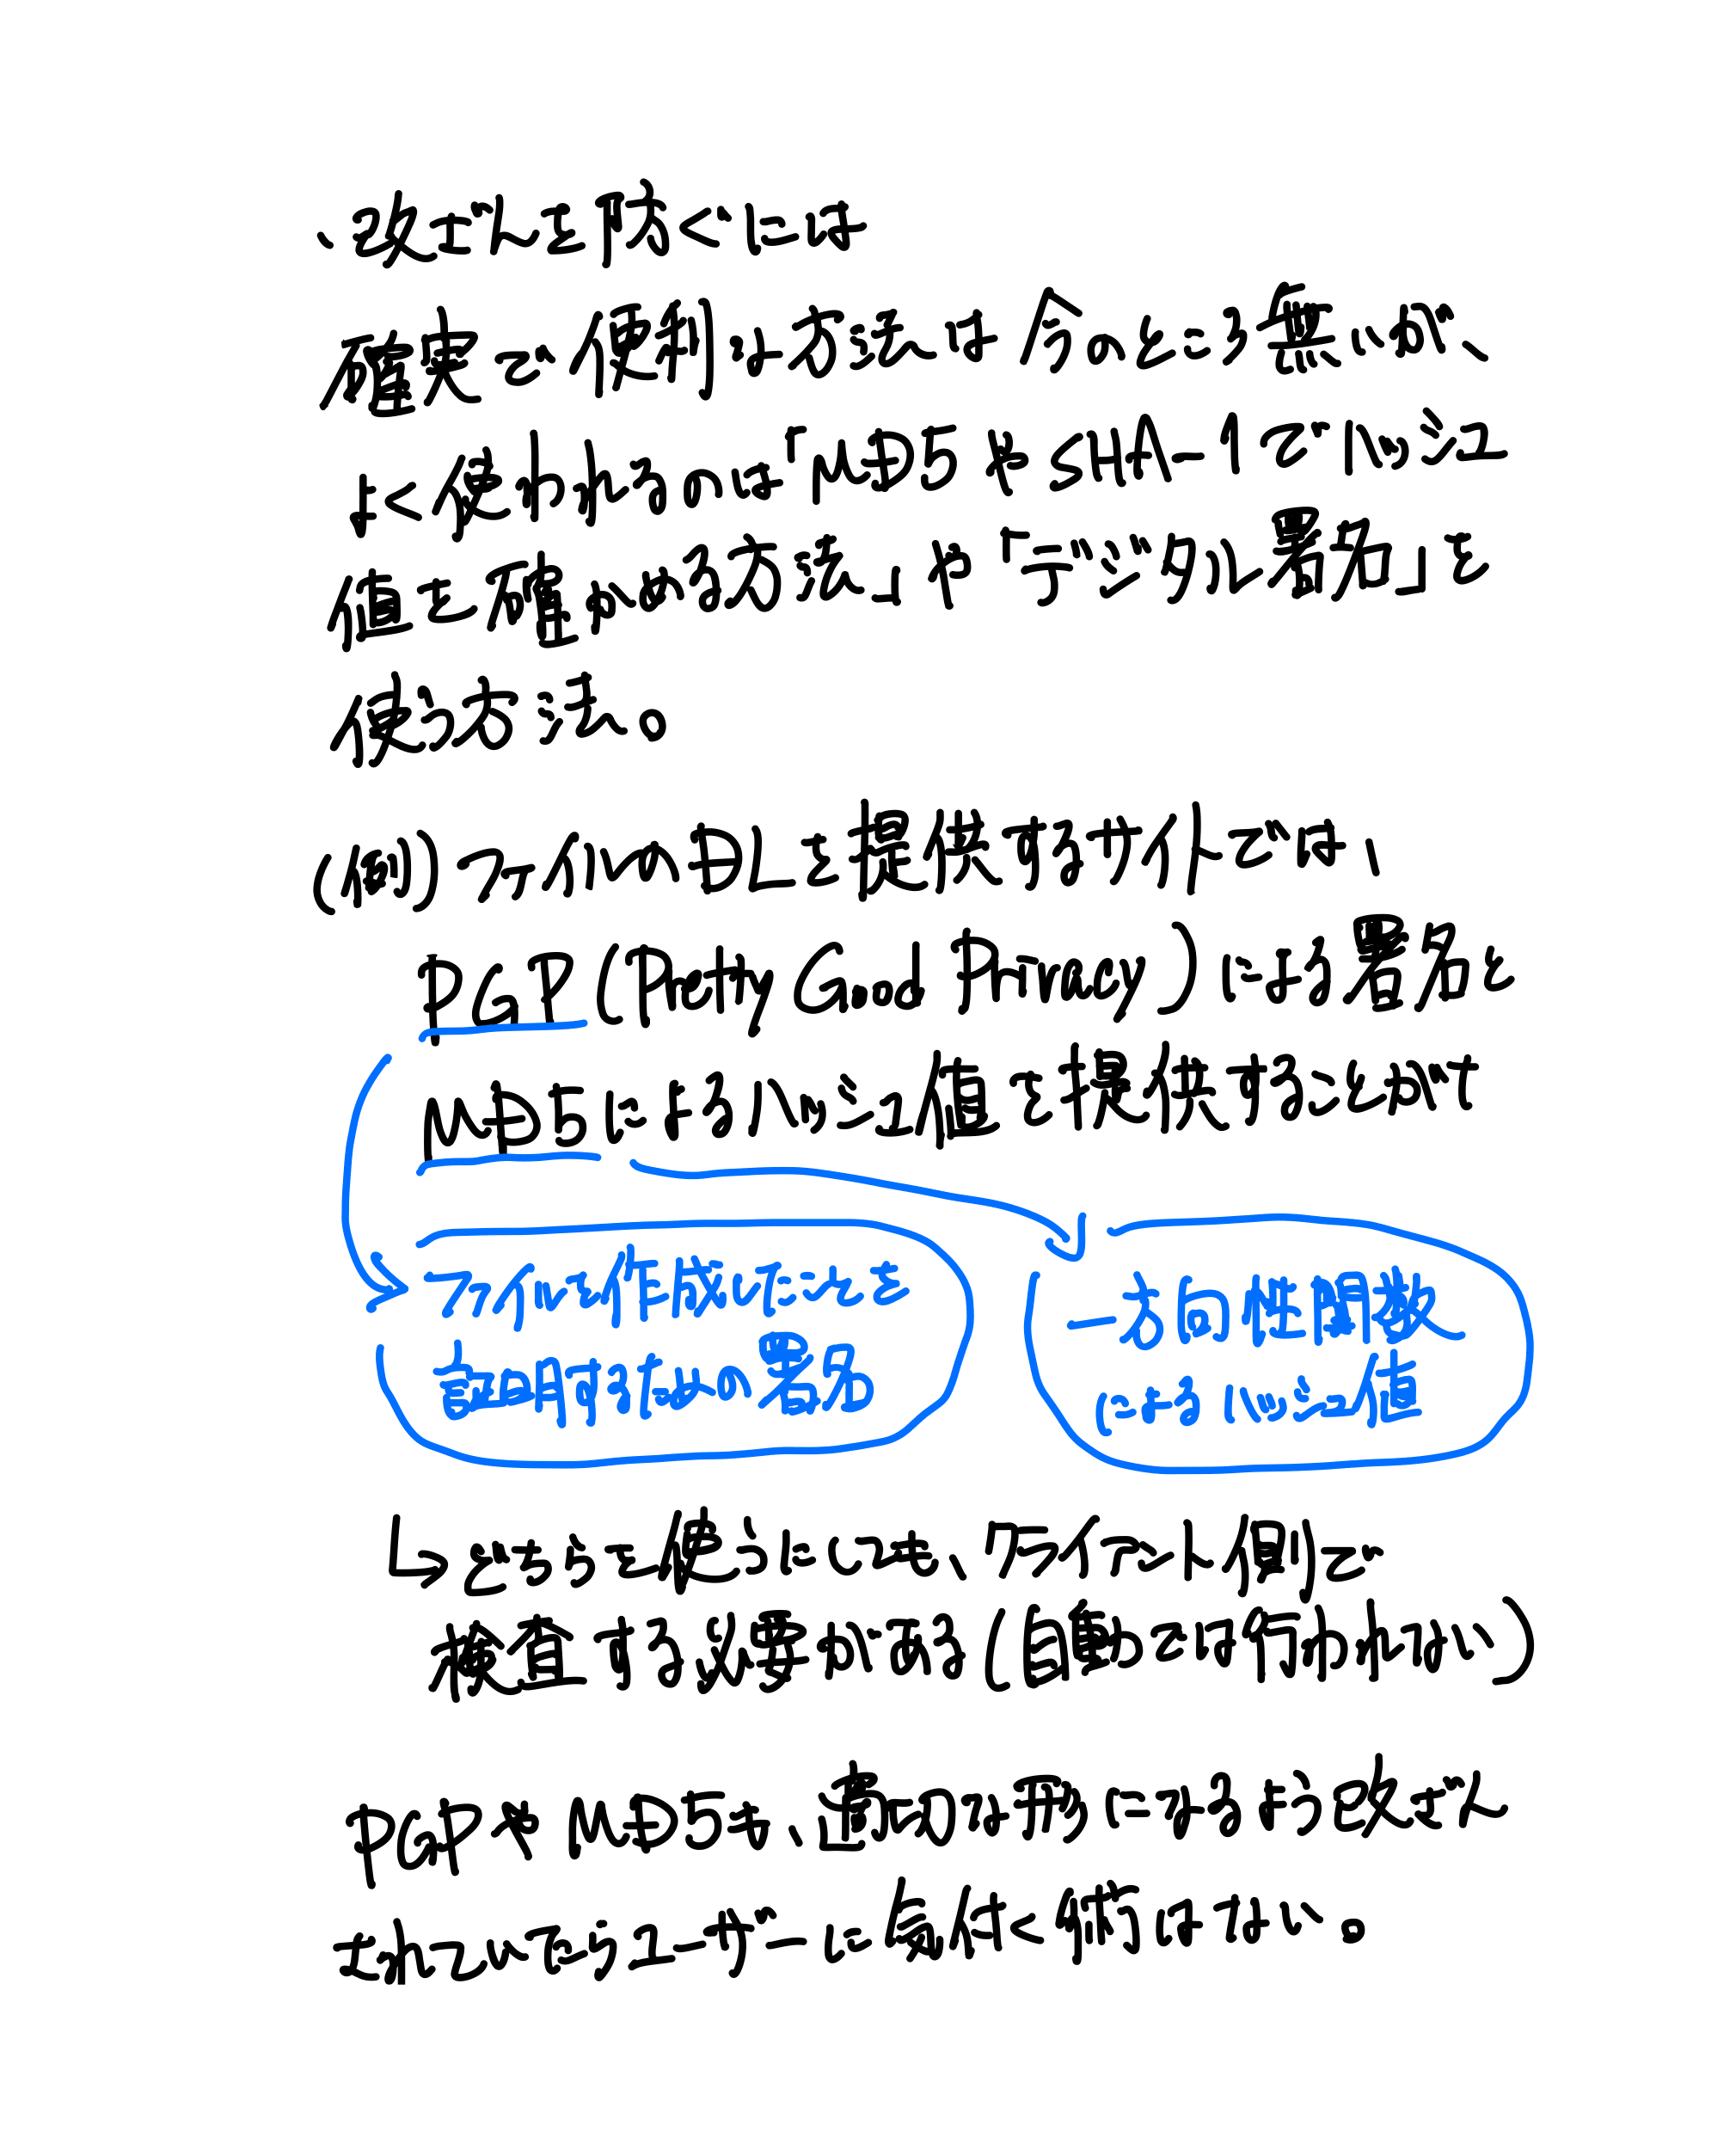
- 防ぐには:MD5やSHA-1でハッシュ値を確かめる/デジタル署名を使う。
- 例)ファイルDLサイトでは PGP(Pretty Good Privacy)署名と MD5 ハッシュ値を提供することがある。
- PGP → ファイルを作成したことを証明する署名
- MD5 → 一方向性関数によるハッシュ値
- どちらもクライアント側で検査する必要がある(自動では行われない)。適切な形に改ざんされていたら気付く術はない。
- 例)ファイルDLサイトでは PGP(Pretty Good Privacy)署名と MD5 ハッシュ値を提供することがある。
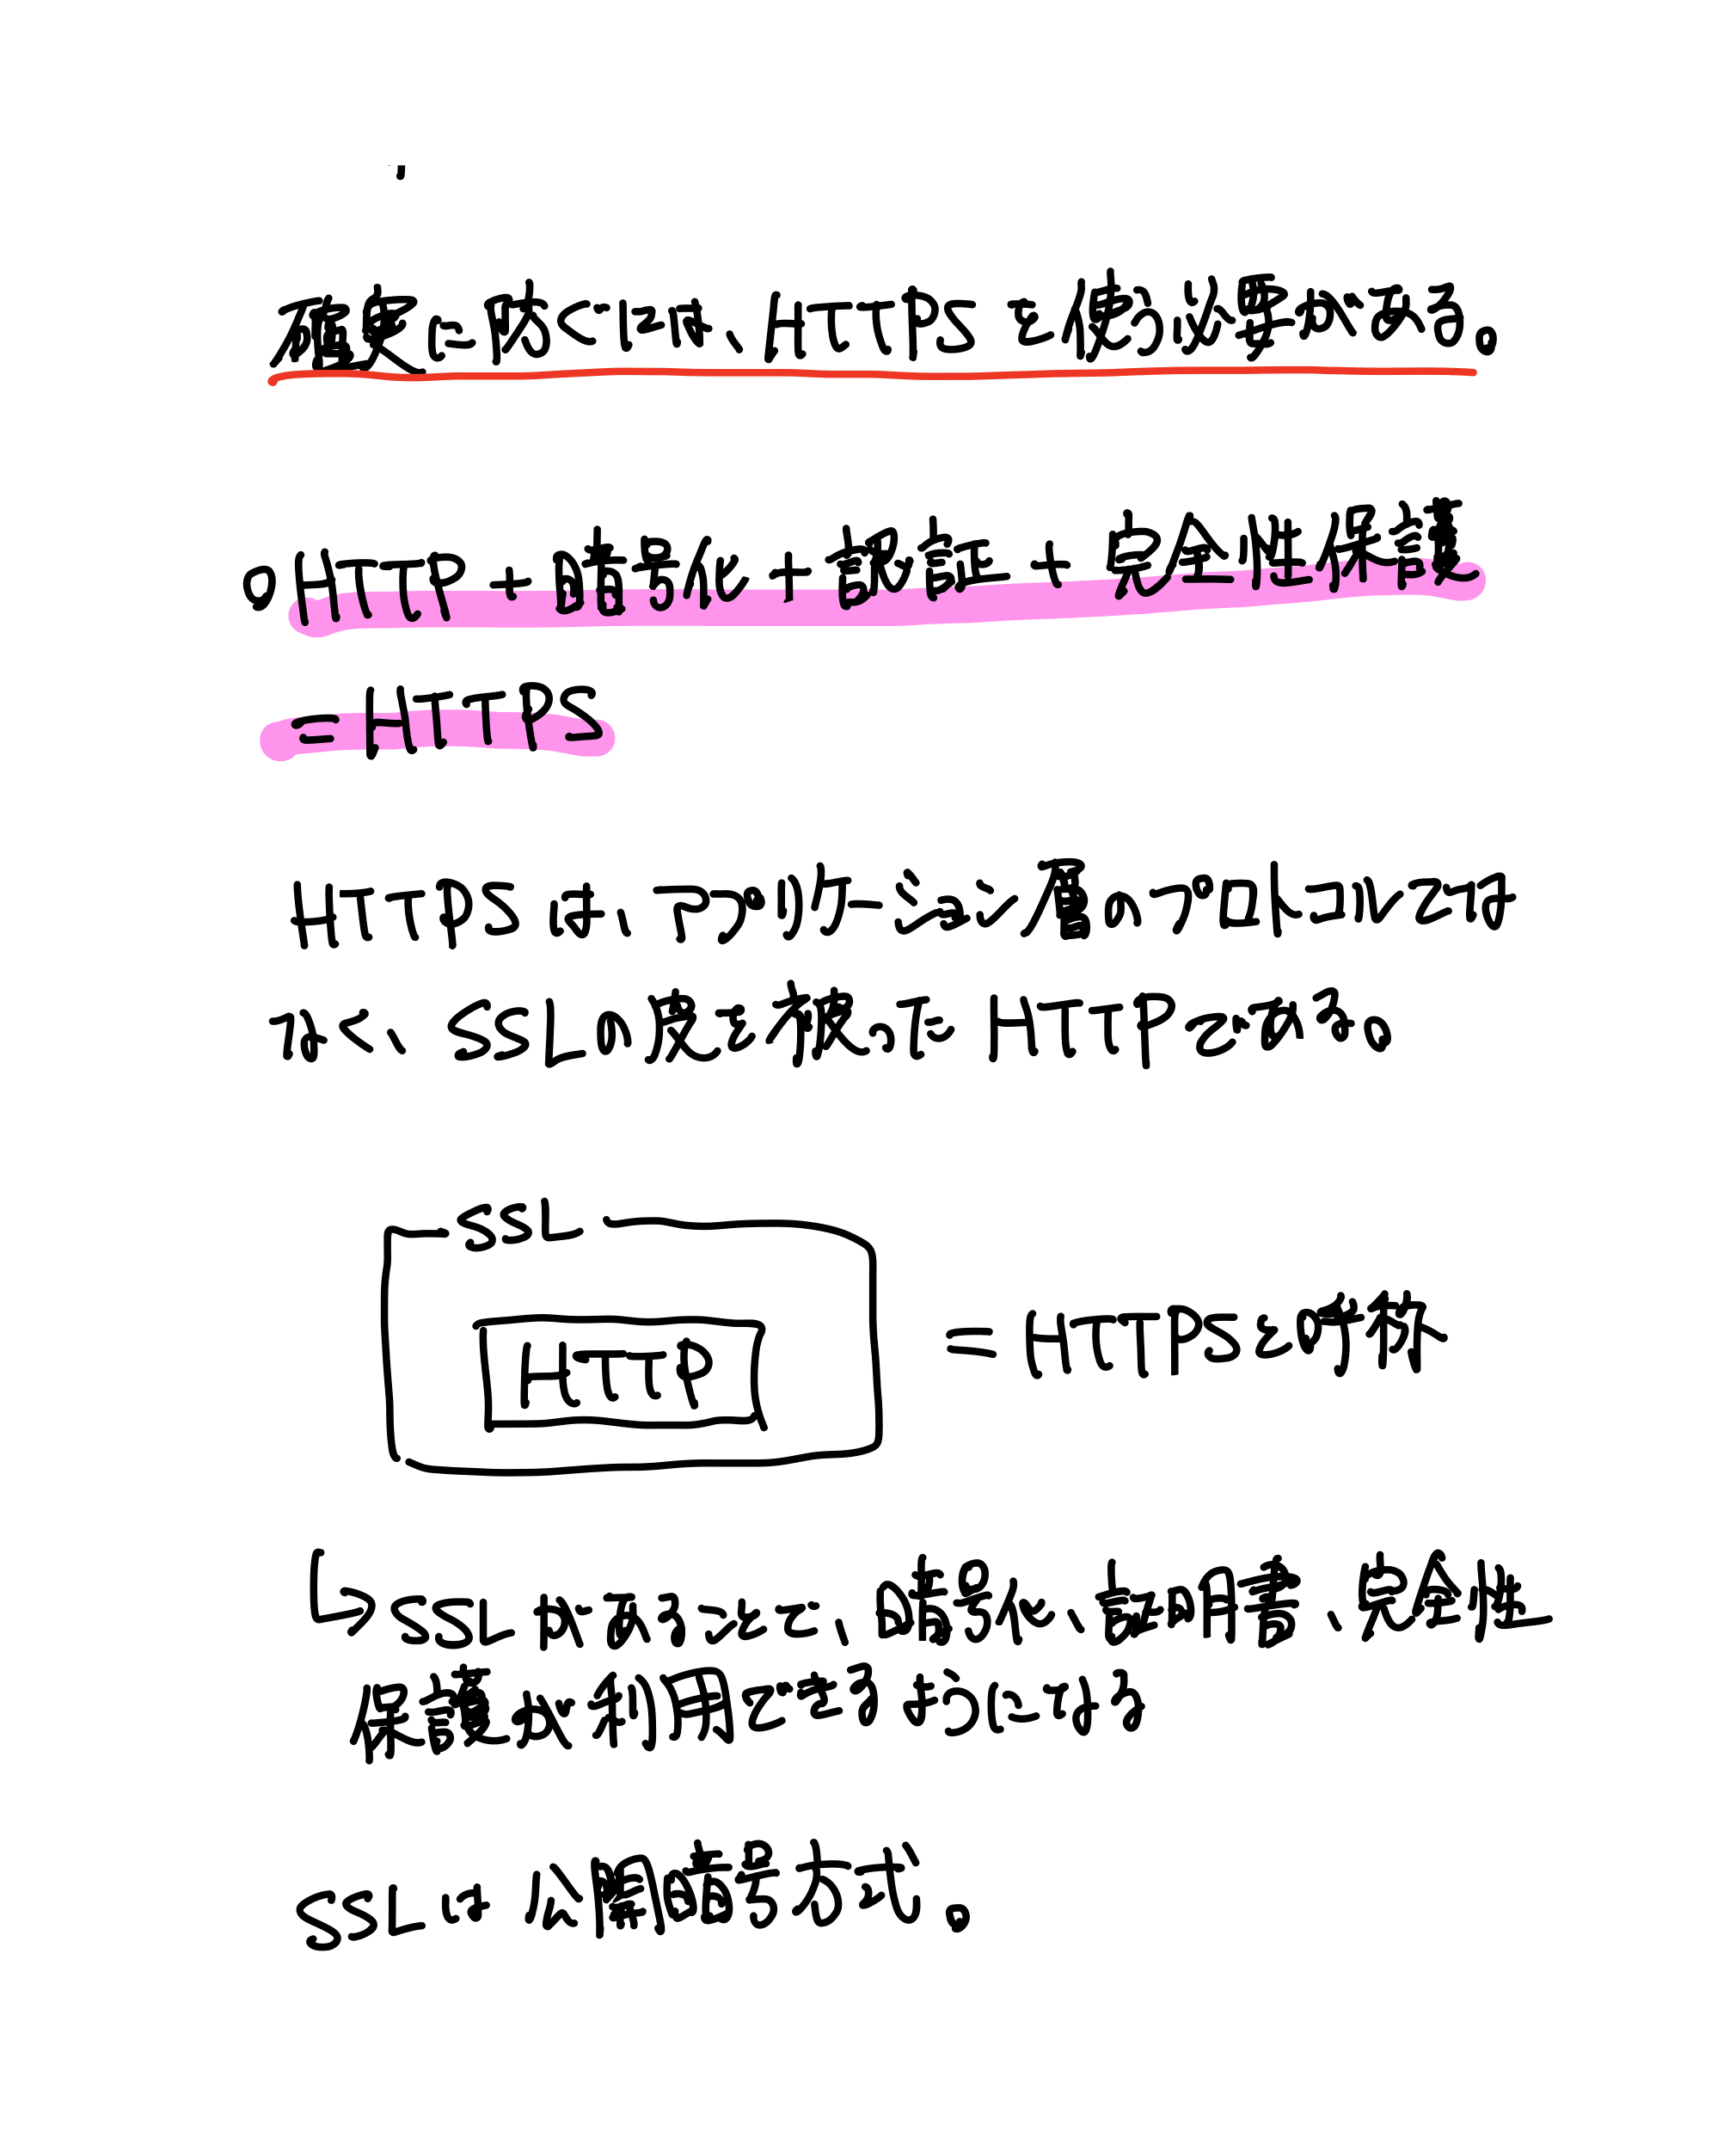
- 確実に防ぐには HTTPS を使う必要がある。
HTTP + 暗号化 + 認証 + 完全性保護 = HTTPS
- HTTPSはアプリケーション層のプロトコルではなく、SSLの皮を被ったHTTP。SSLがあることで暗号化・証明書・完全性保護が使える。
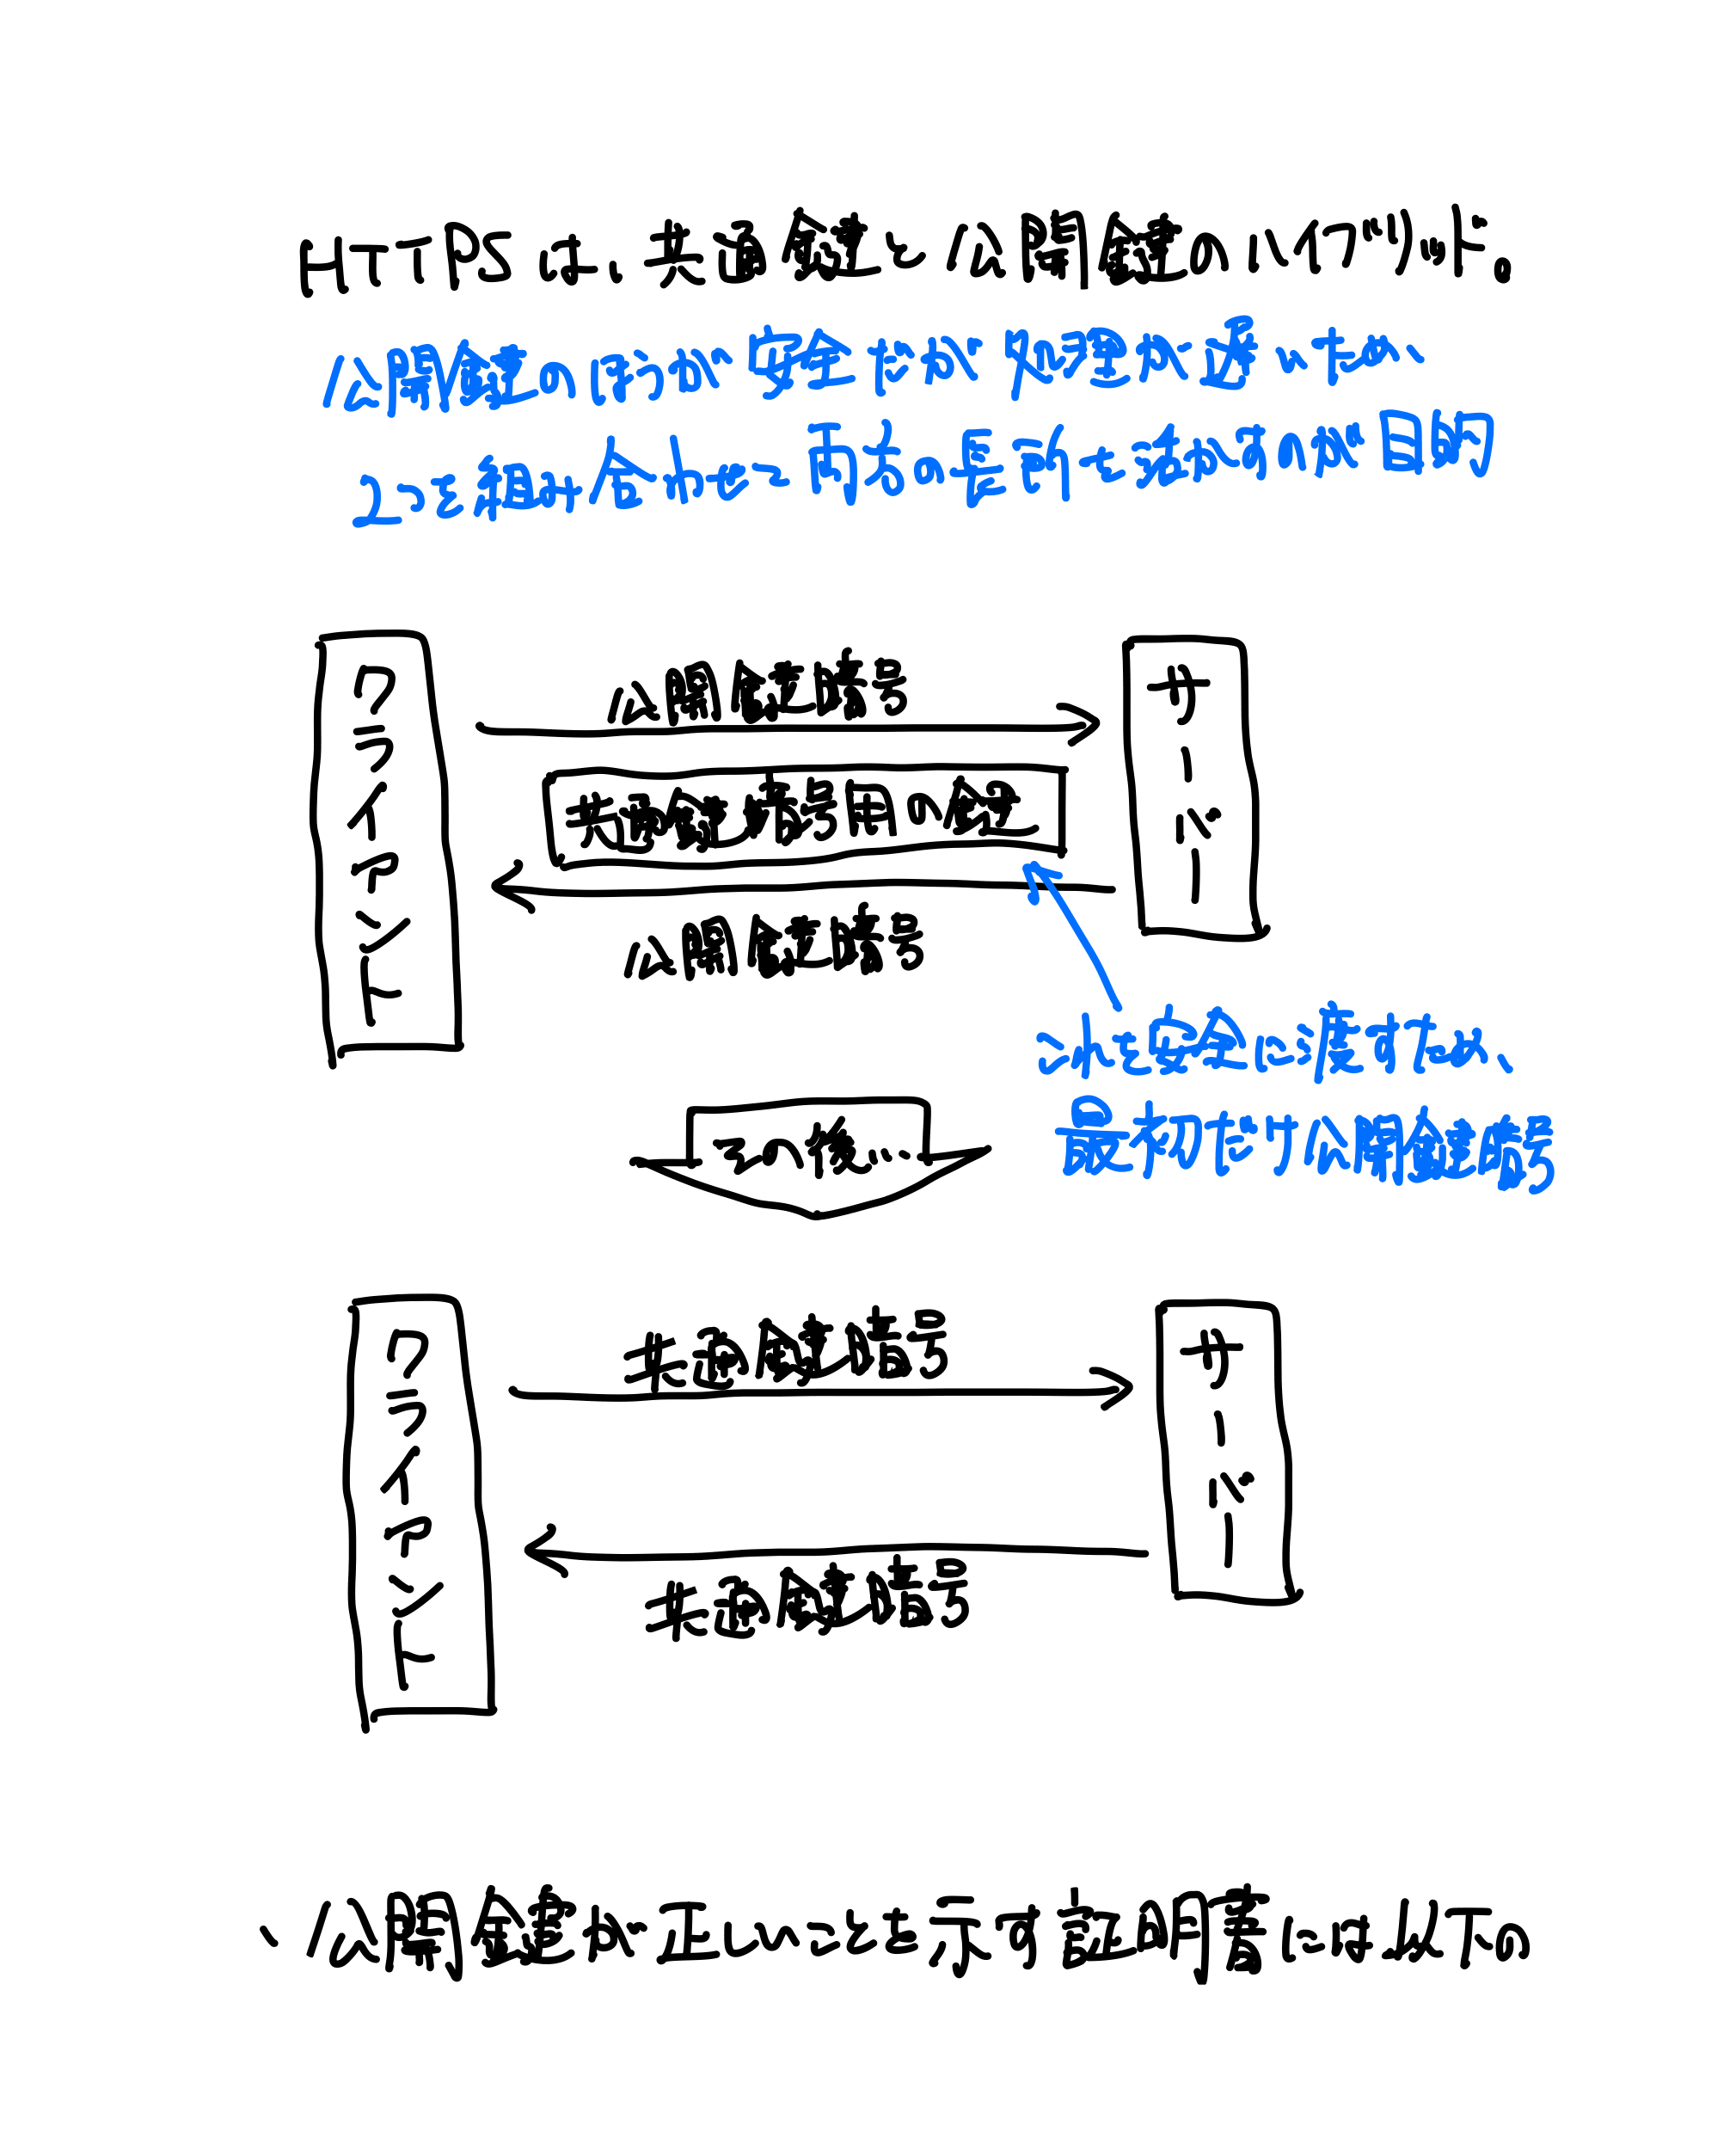
- SSLは公開鍵暗号方式。HTTPSは共通鍵と公開鍵のハイブリッド(公開鍵は安全だが処理が遅いため、両方の長所を活かす)。
- 最初だけ公開鍵暗号で共通鍵を安全に渡し、その後は共通鍵暗号でやりとりする。
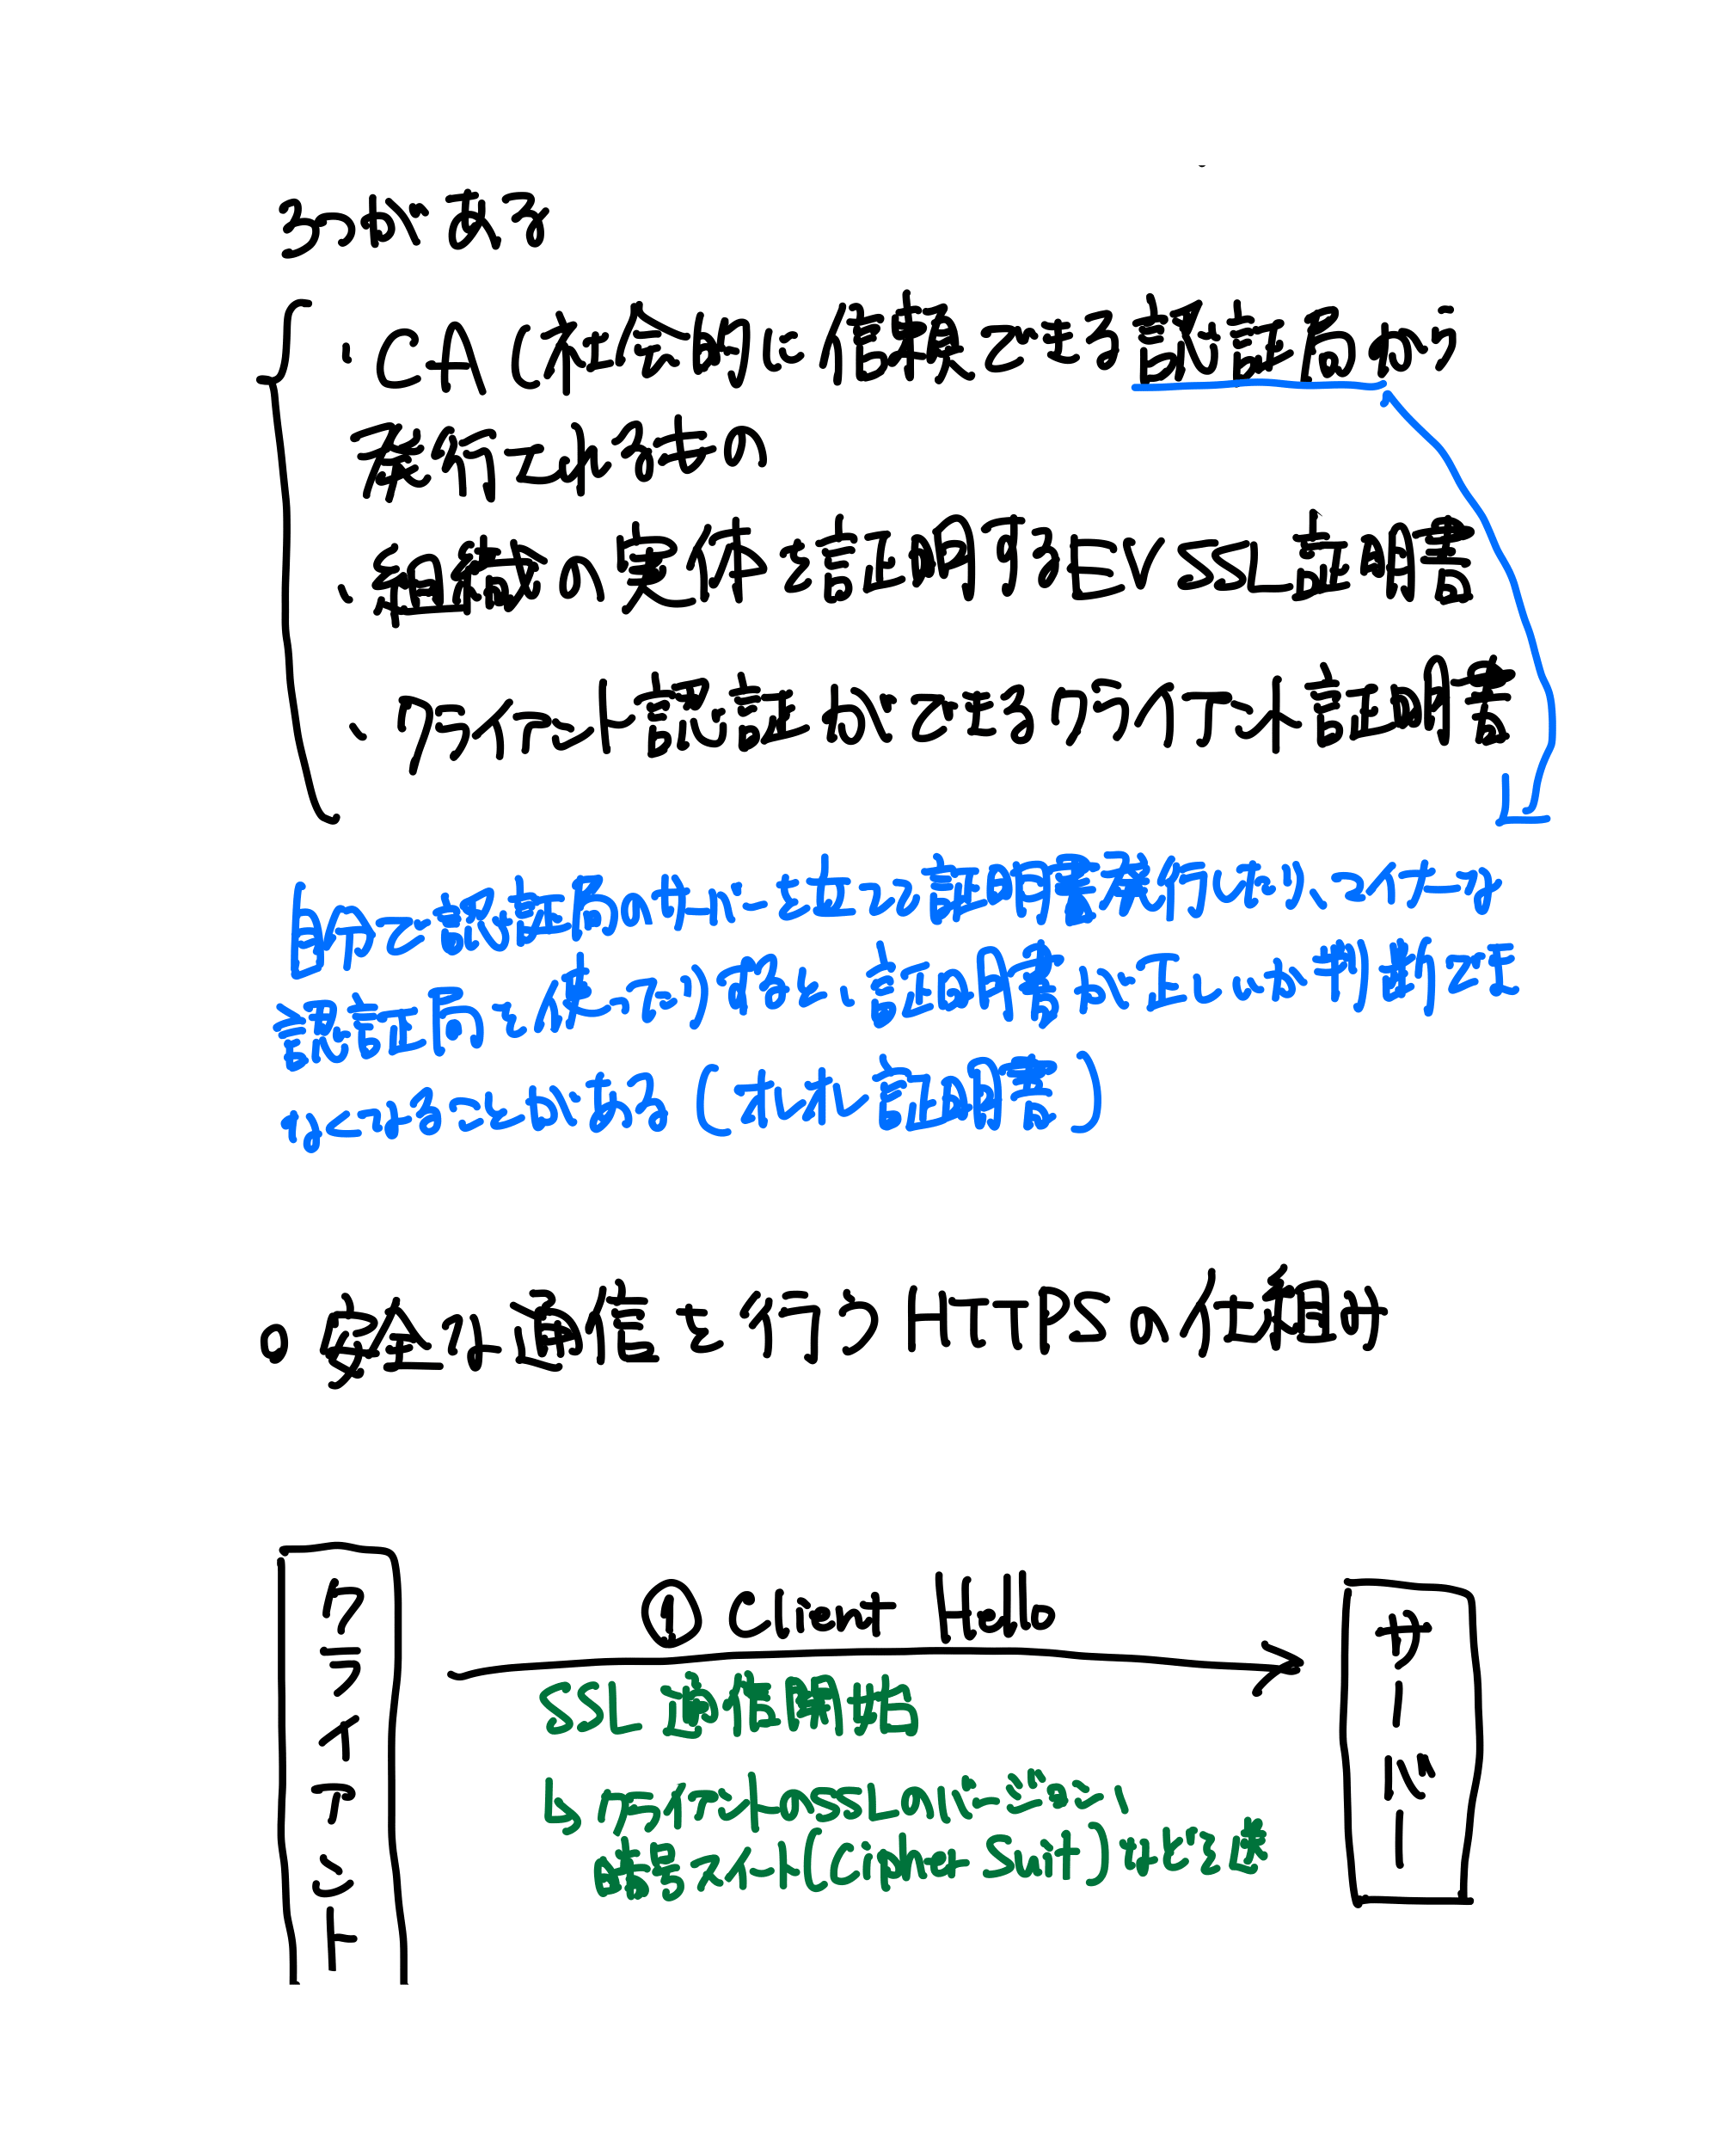
- 公開鍵が正しいことを示す証明書は3つ:
- CA(社会的に信頼できる認証局から発行)
- 組織の実体を証明する EV SSL 証明書
- クライアント認証ができるクライアント証明書
- ※自分で認証局を立てたりマイナーな認証局を使うと、正しいか判断できないことがある(オレオレ証明書)。
安全な通信を行うHTTPSの仕組み(ハンドシェイク)
- Client Hello(→):SSL通信開始。クライアントのSSLバージョンと暗号スイート(Cipher Suite)などを送る
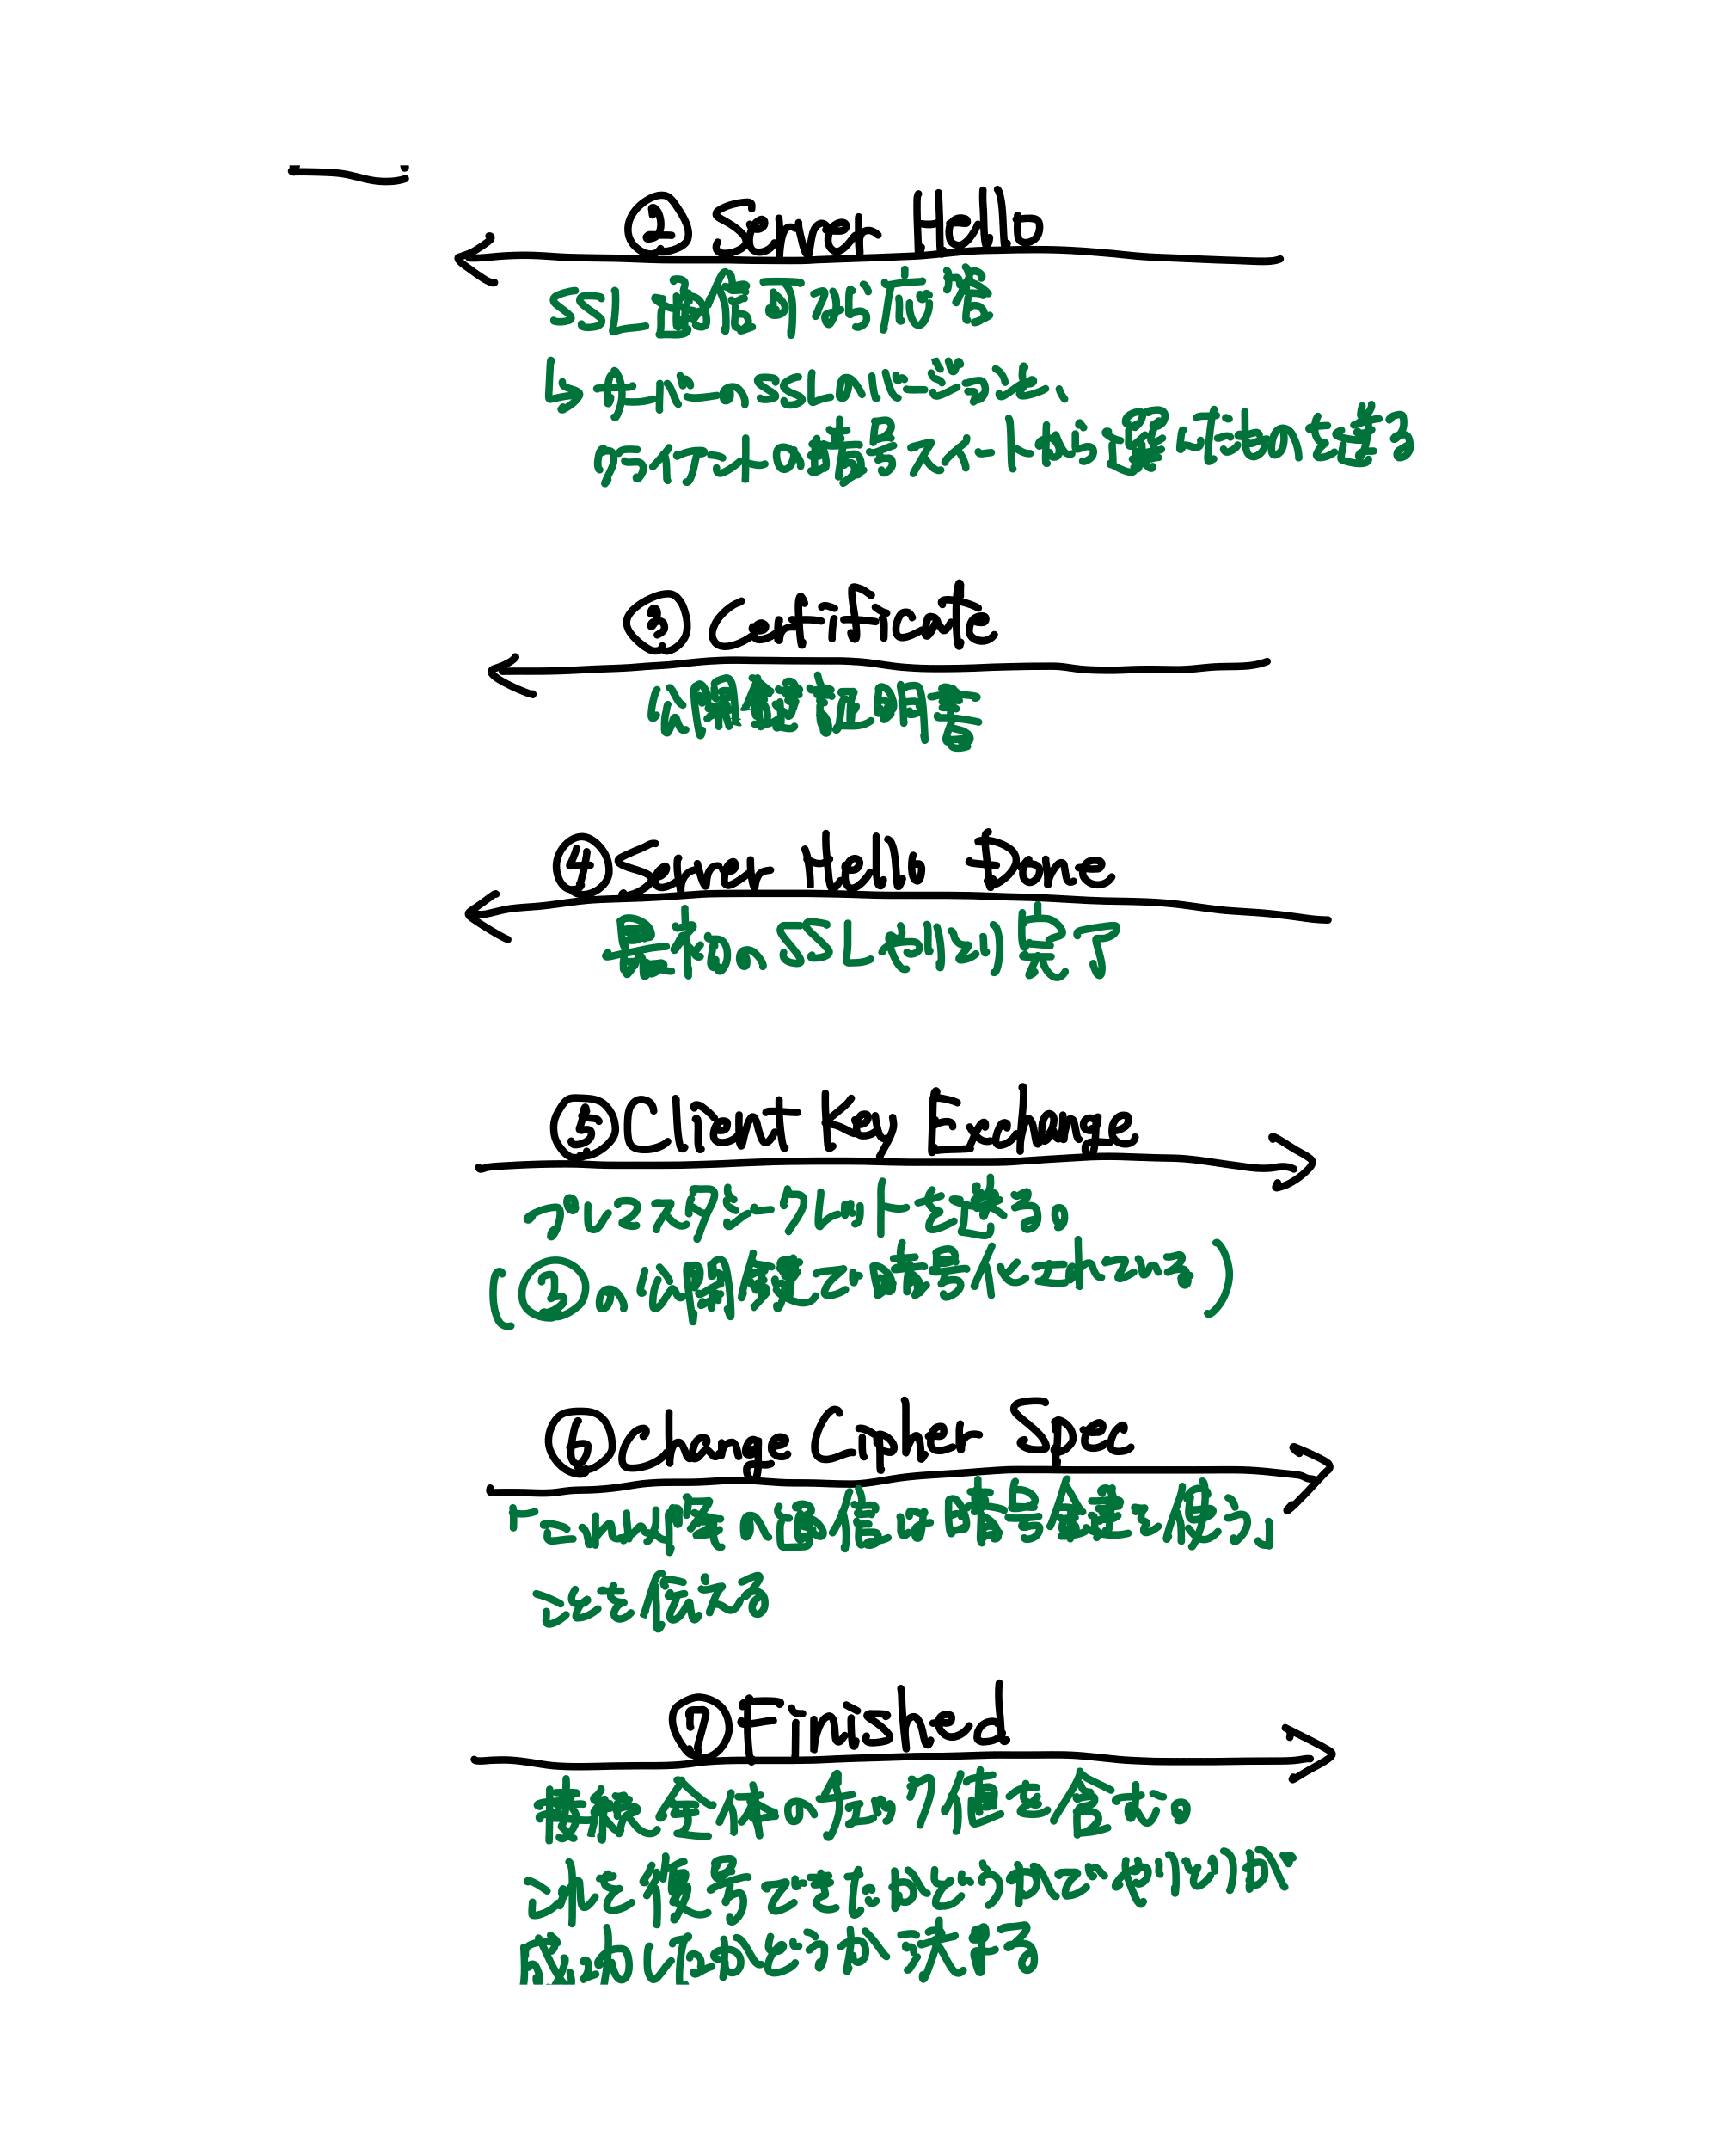
- Server Hello(←):応答。サーバーのSSLバージョンと、選んだ暗号スイートを送る
- Certificate(←):公開鍵証明書
- Server Hello Done(←):最初のSSLやりとり完了
- Client Key Exchange(→):プレマスターシークレットを送る(②の公開鍵で暗号化)
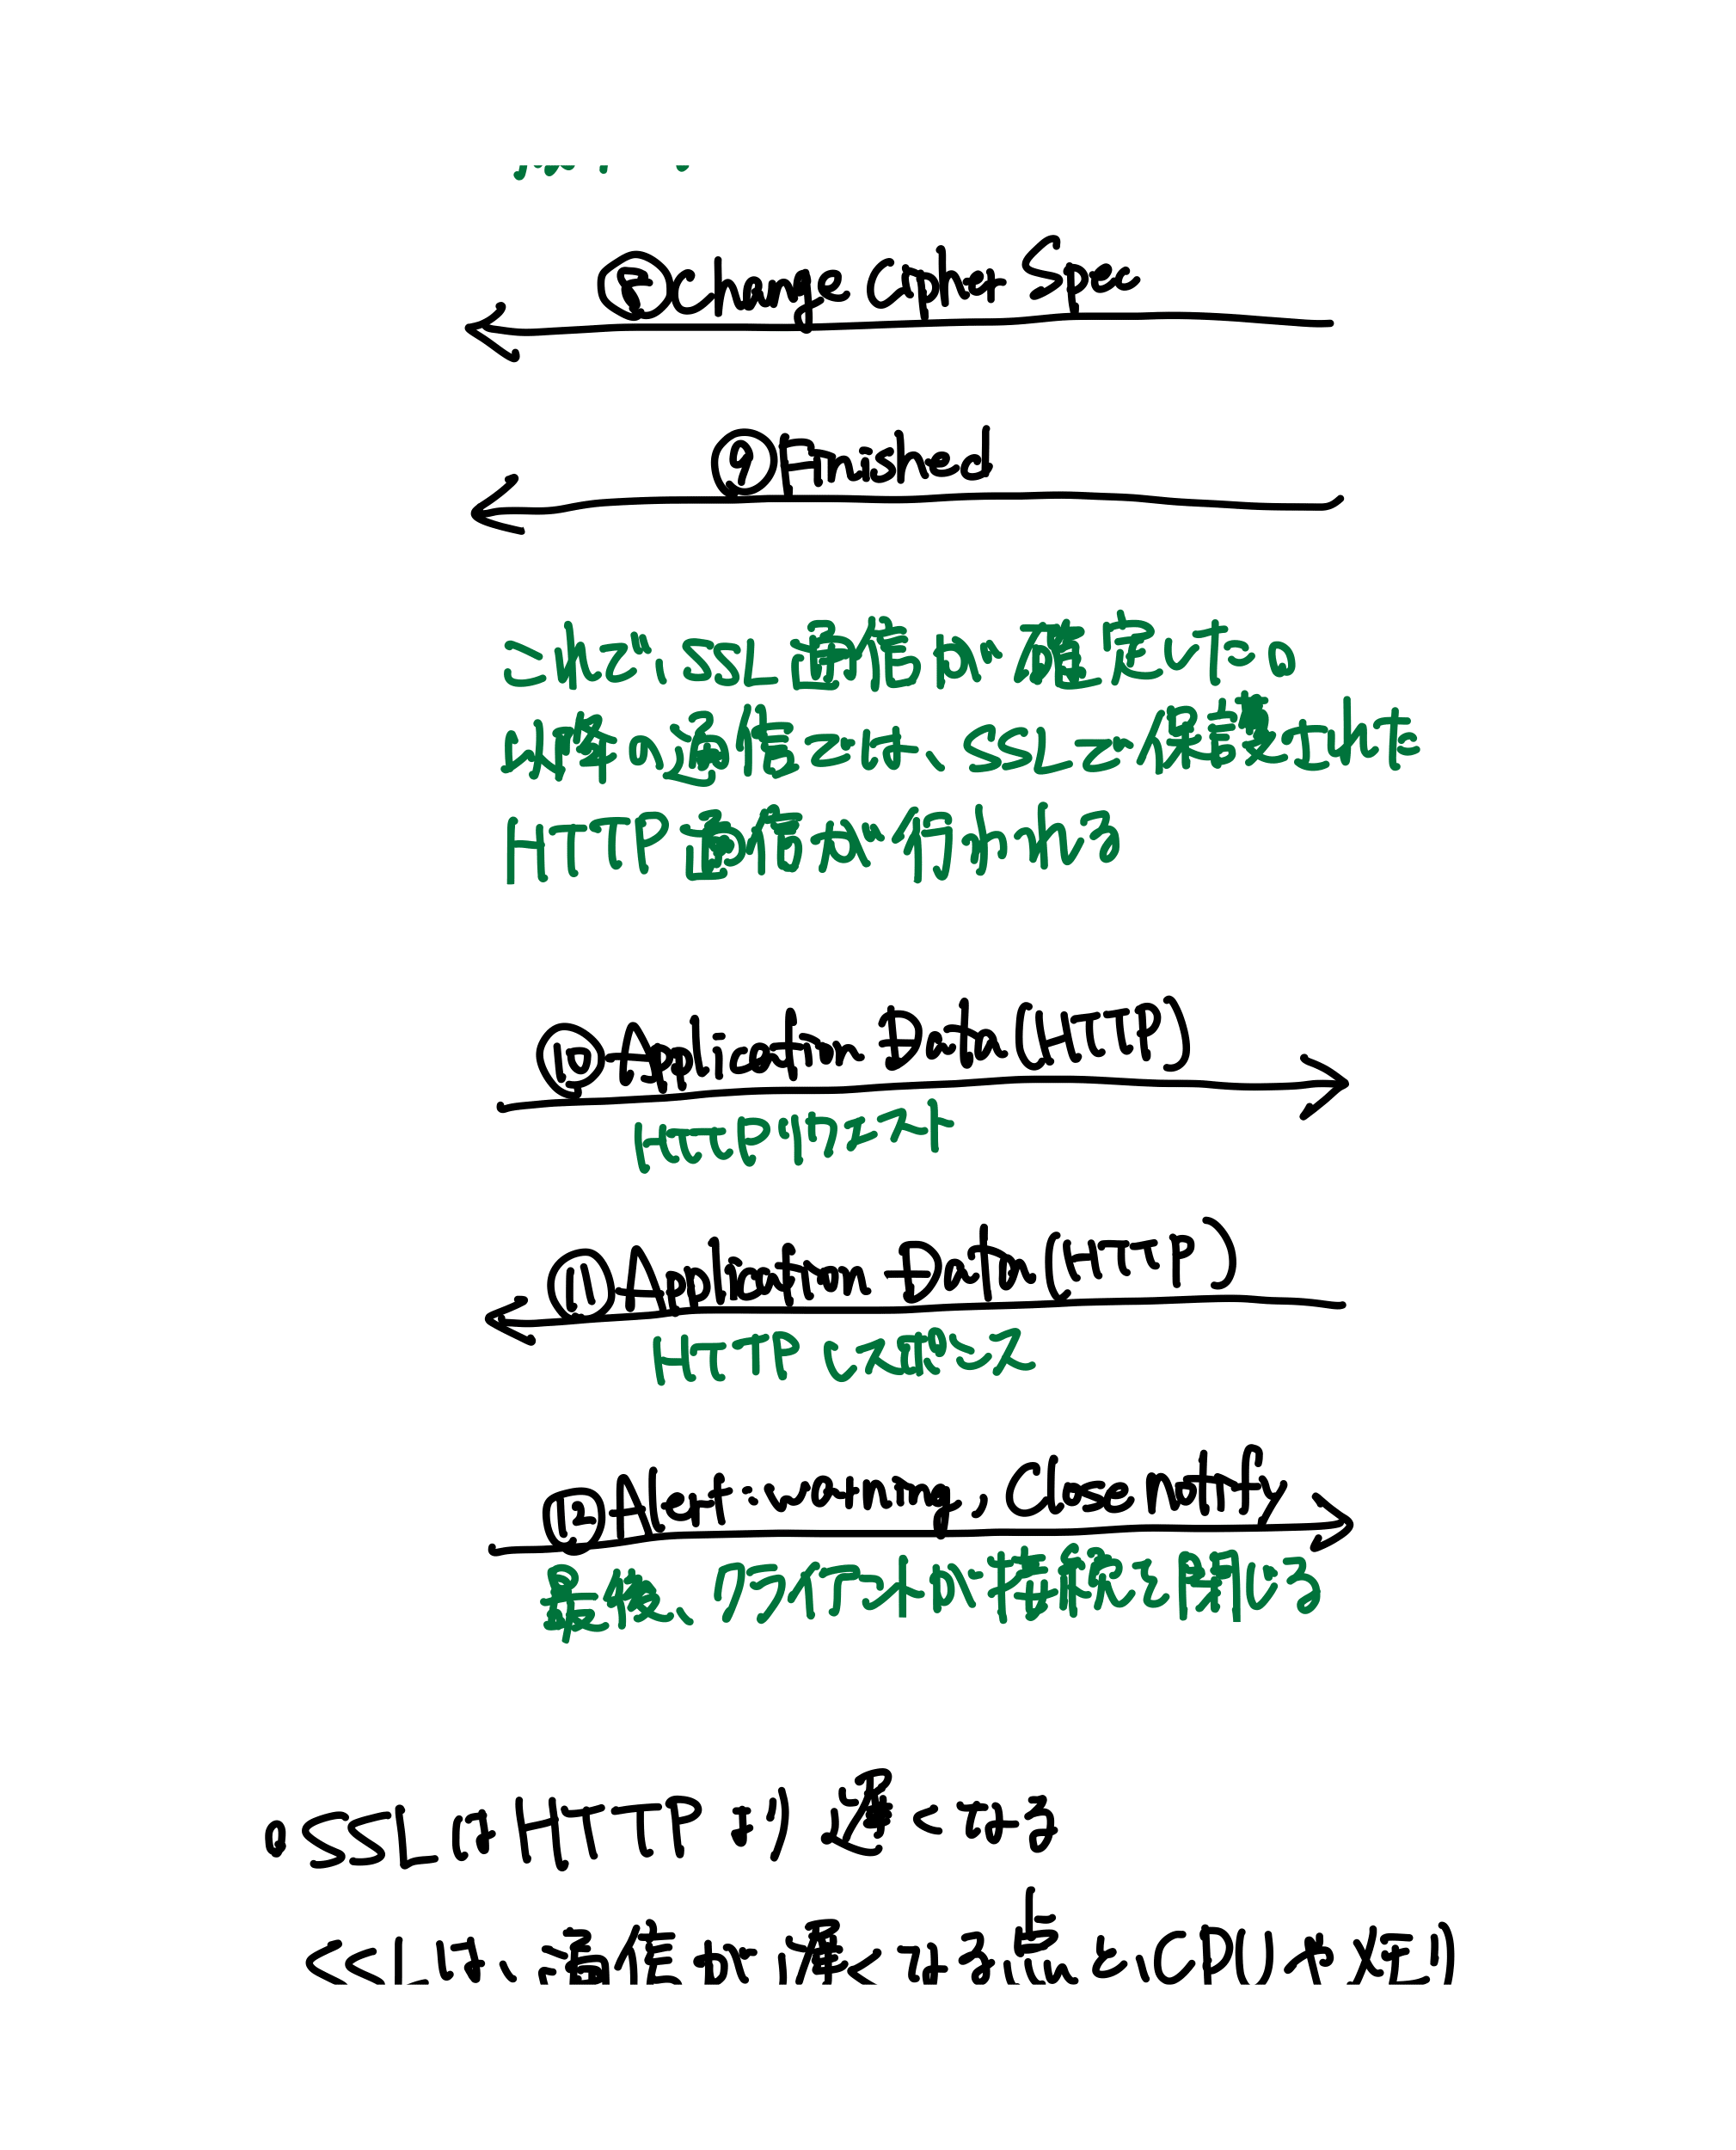
- Change Cipher Spec(→):「これ以降は暗号鍵を使う」ことを伝える
- Finished(→):接続全体のチェック値を含む。復号できたか=やりとり成功か
- Change Cipher Spec(←)
- Finished(←)
- これでSSL通信が確定。以降はSSLで保護されたHTTP通信を行う。
- Application Data(HTTP)→ / ← :HTTPリクエスト/レスポンス
- Alert: warning, Close notify(→):最後にクライアントが接続を閉じる
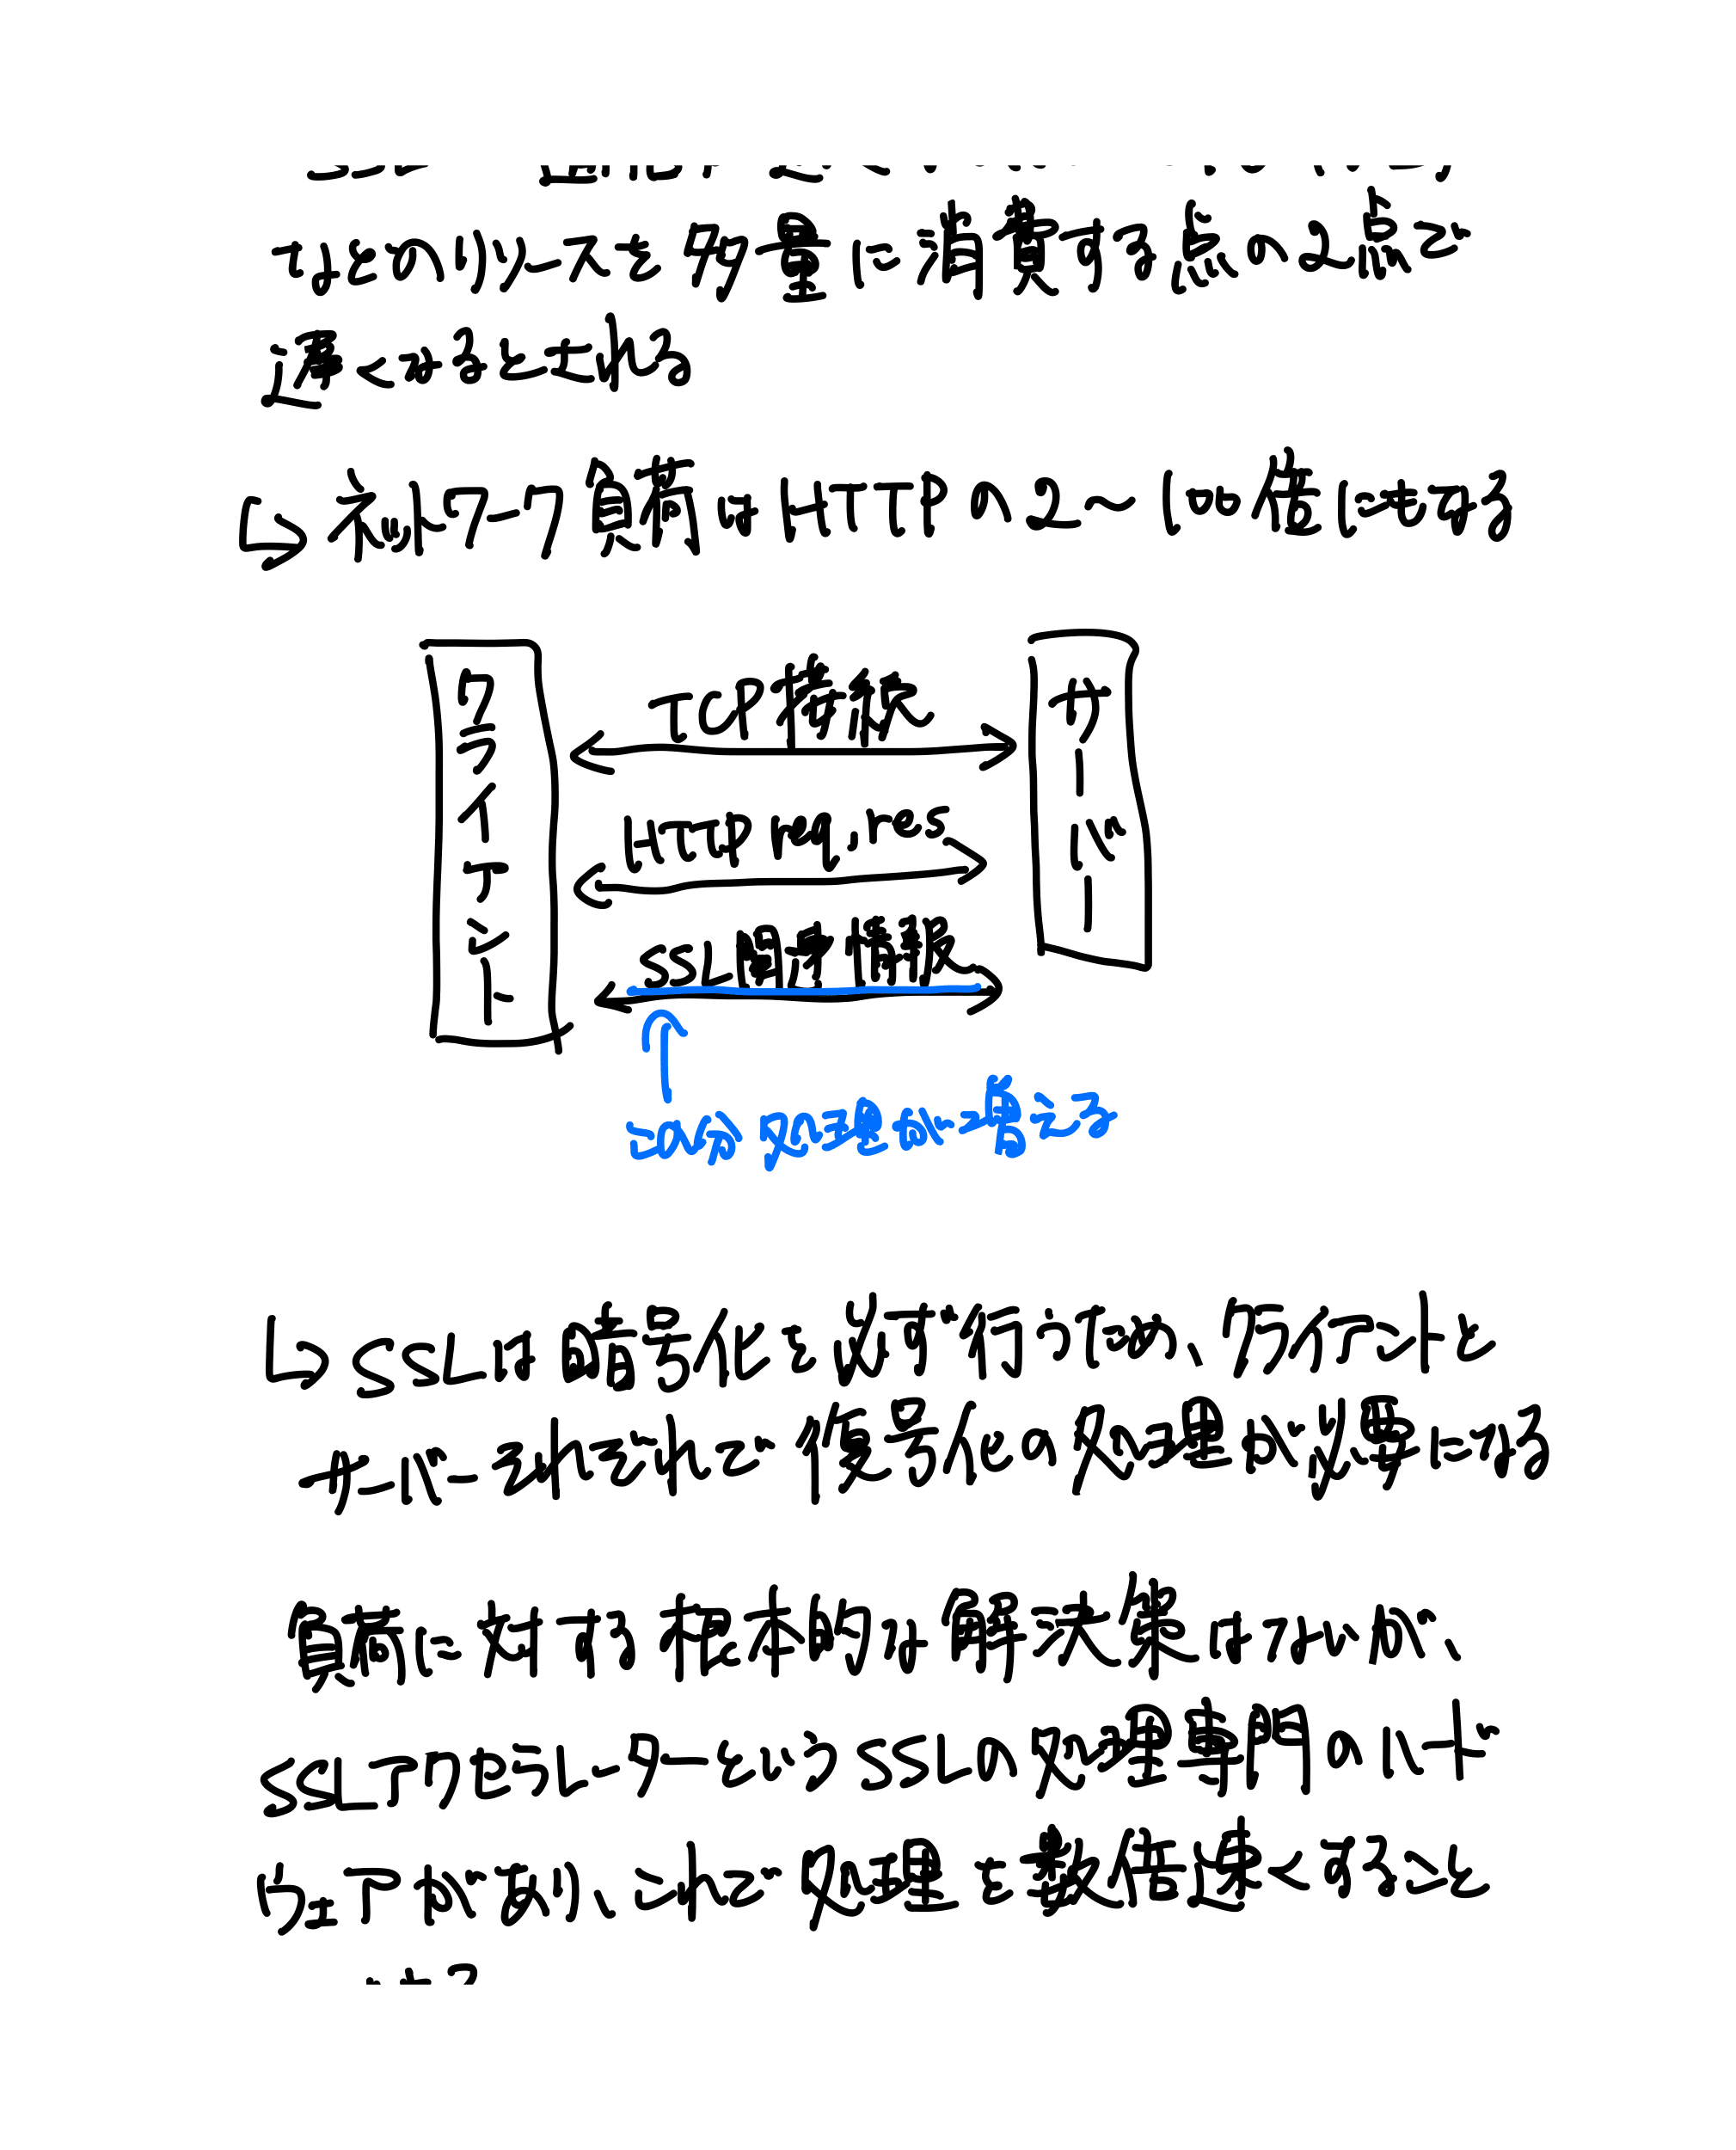
- SSLはHTTPより遅い(通信が遅くなる点と、CPU処理や暗号化などのリソースを多量に消費する点)。ネットワーク負荷はHTTPの2〜100倍にもなる。
- 根本解決はないが、SSLアクセラレーター(SSL処理専門のハードウェア)で処理を数倍速くすることもできる。
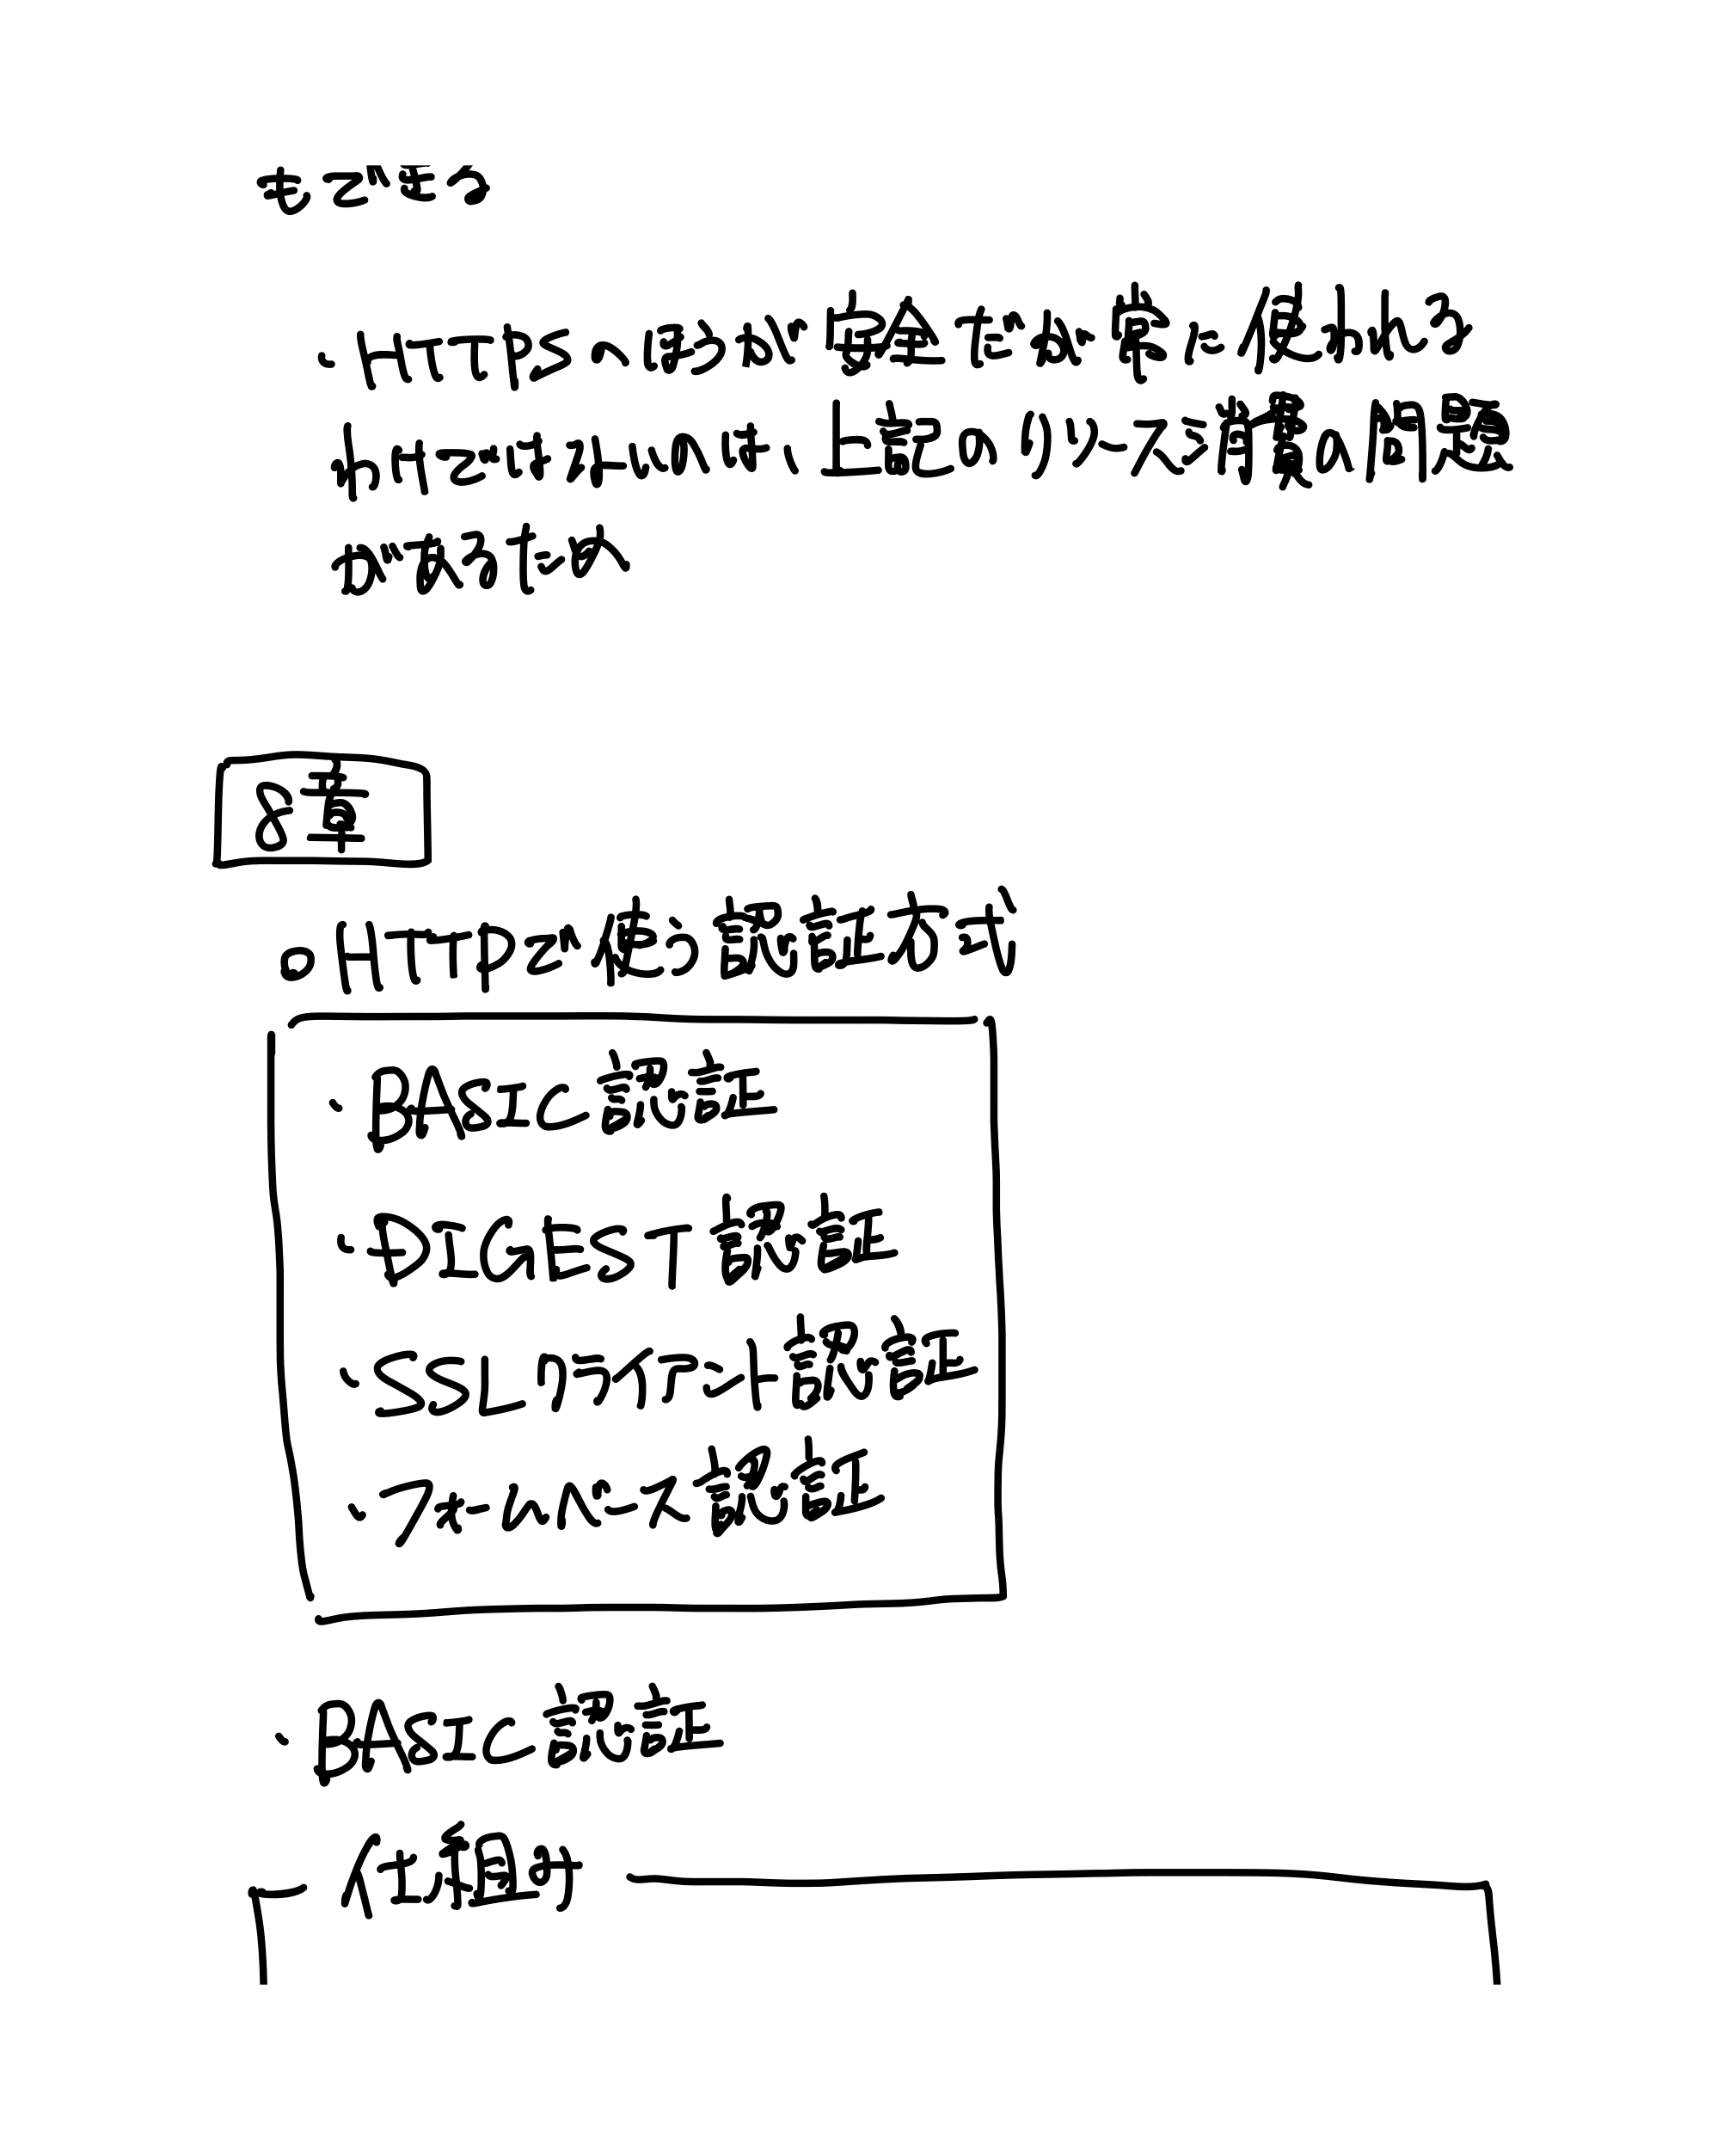
- HTTPSが常に使われるわけではないのは、このリソース消費の問題があるため。
8章 認証
HTTPで使う認証方式:BASIC認証 / DIGEST認証 / SSLクライアント認証 / フォームベース認証。
- BASIC認証
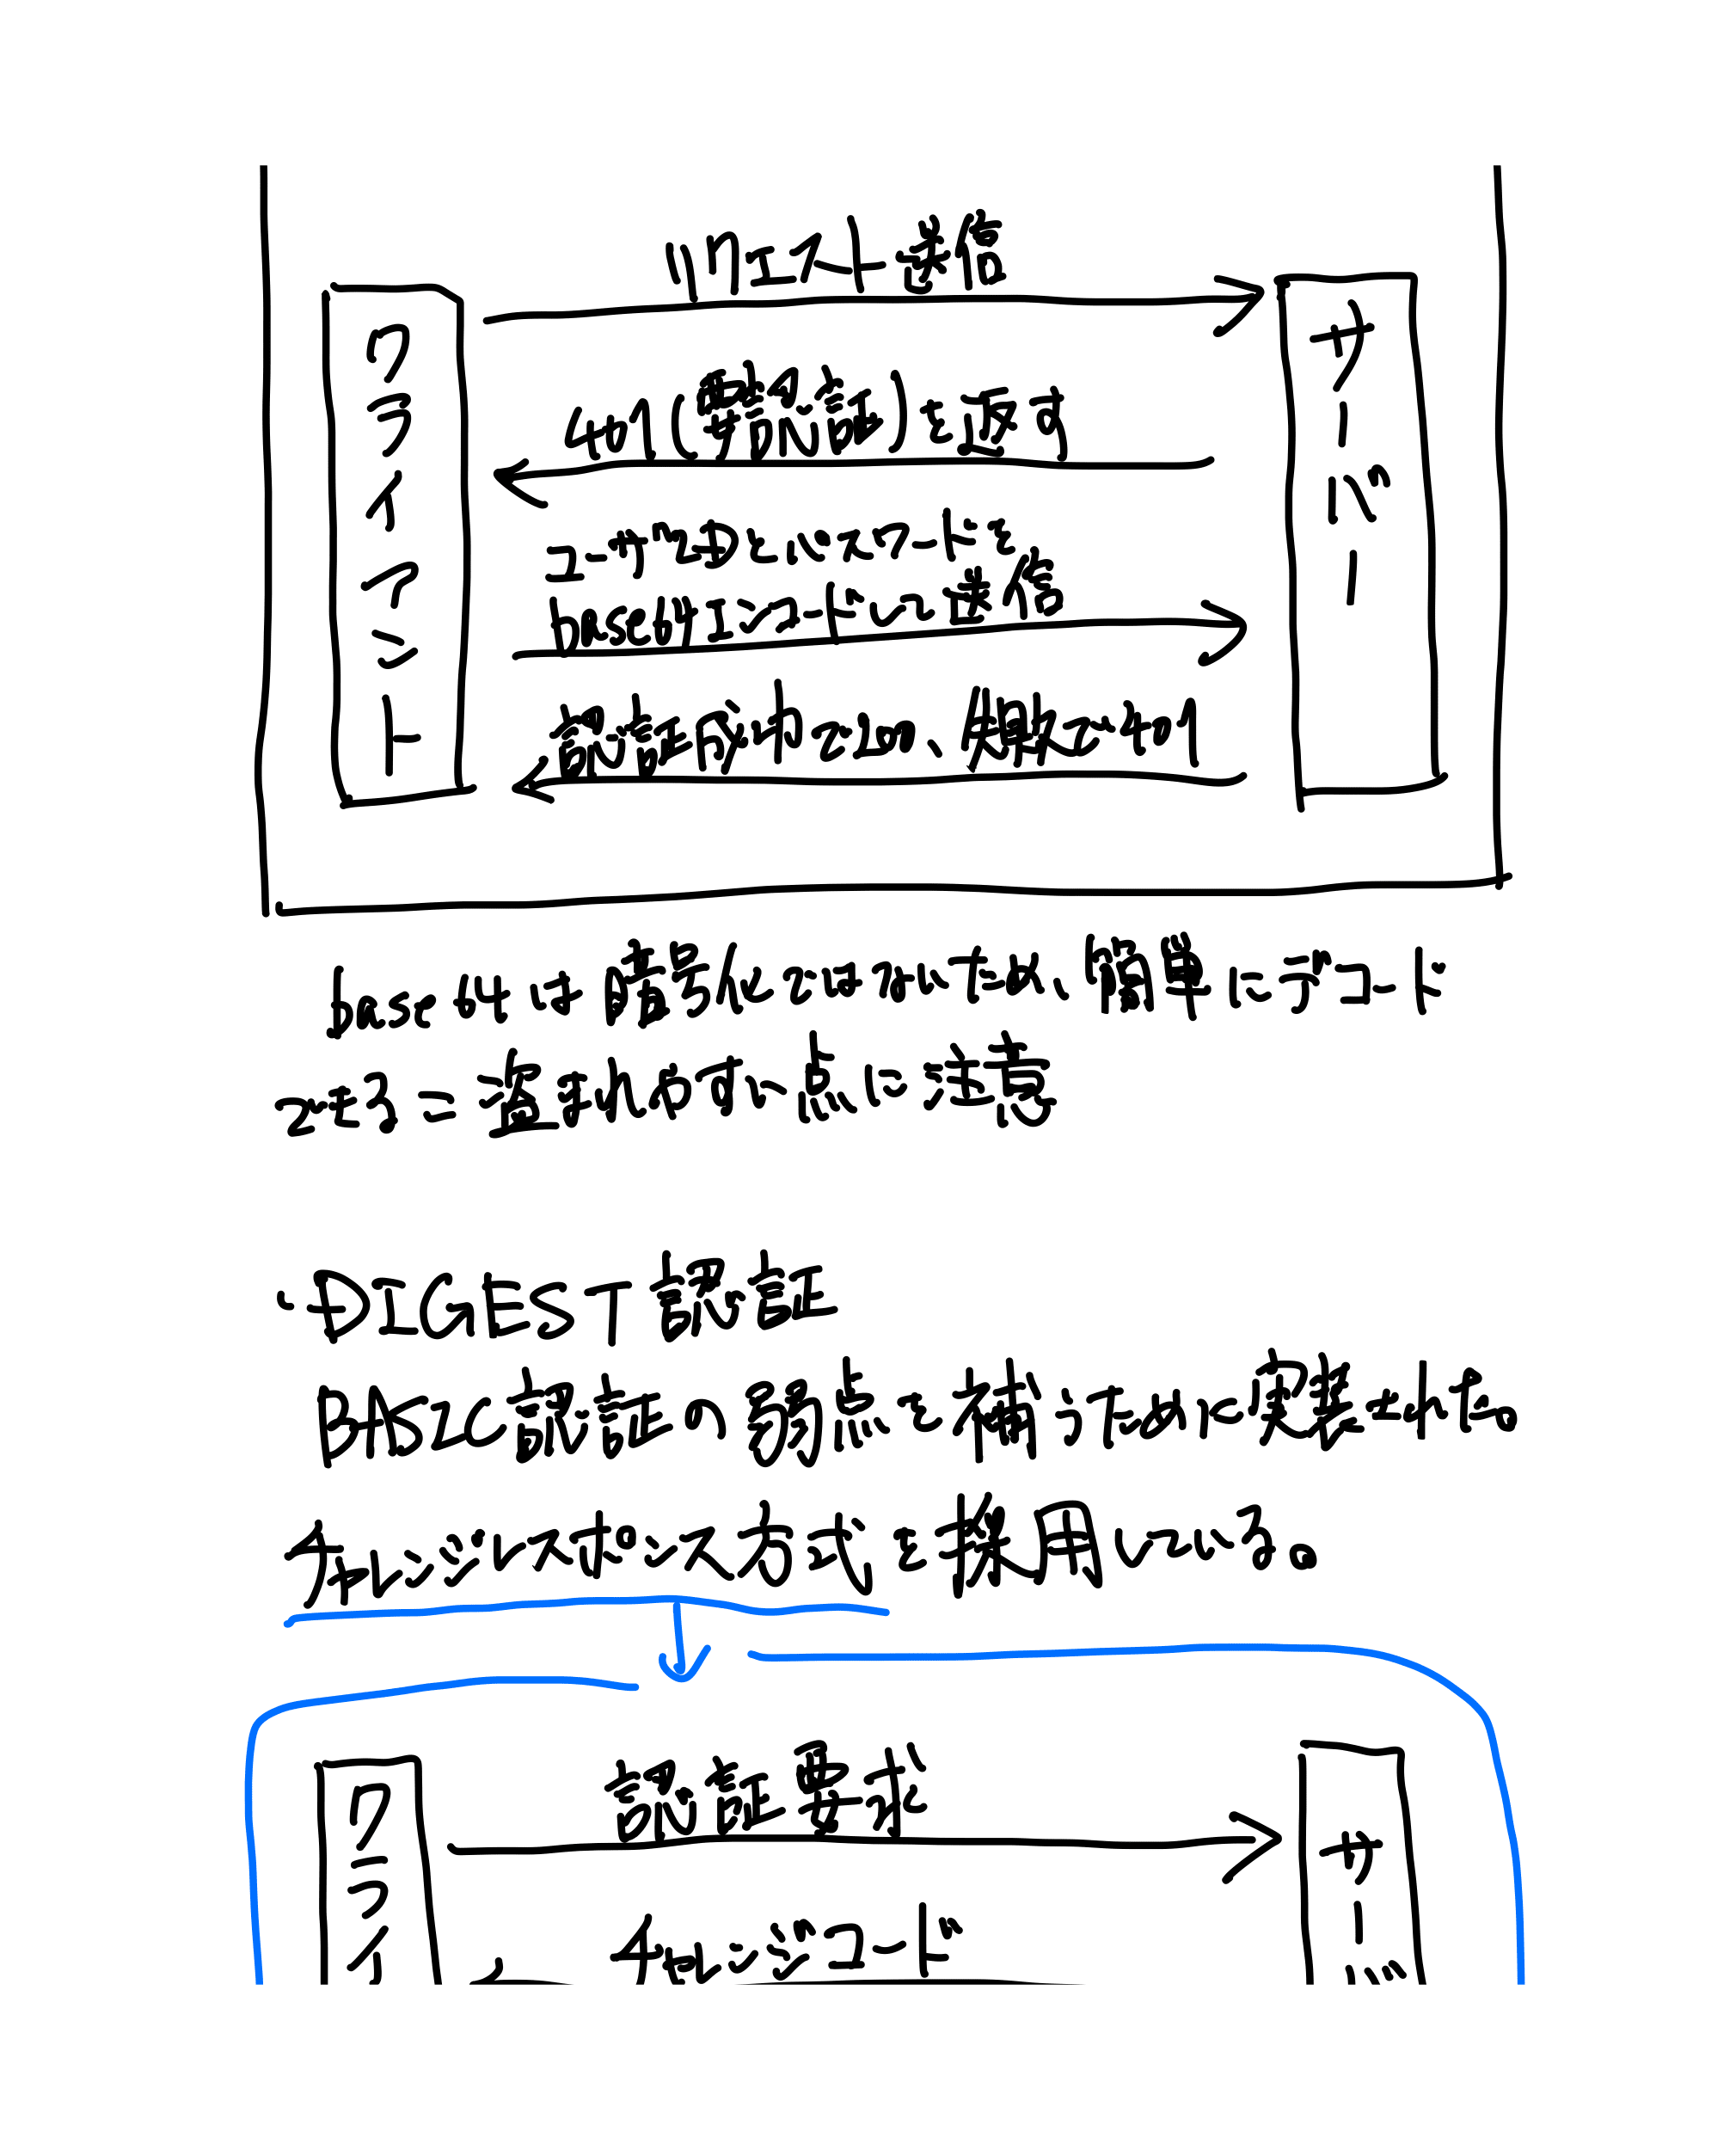
- 仕組み:リクエスト → 401(要認証)→ ユーザー名とパスワードを base64 エンコードして送信 → 成功で200、失敗で401。
- base64 は暗号化ではないため簡単にデコードでき、盗まれやすい点に注意。
- DIGEST認証
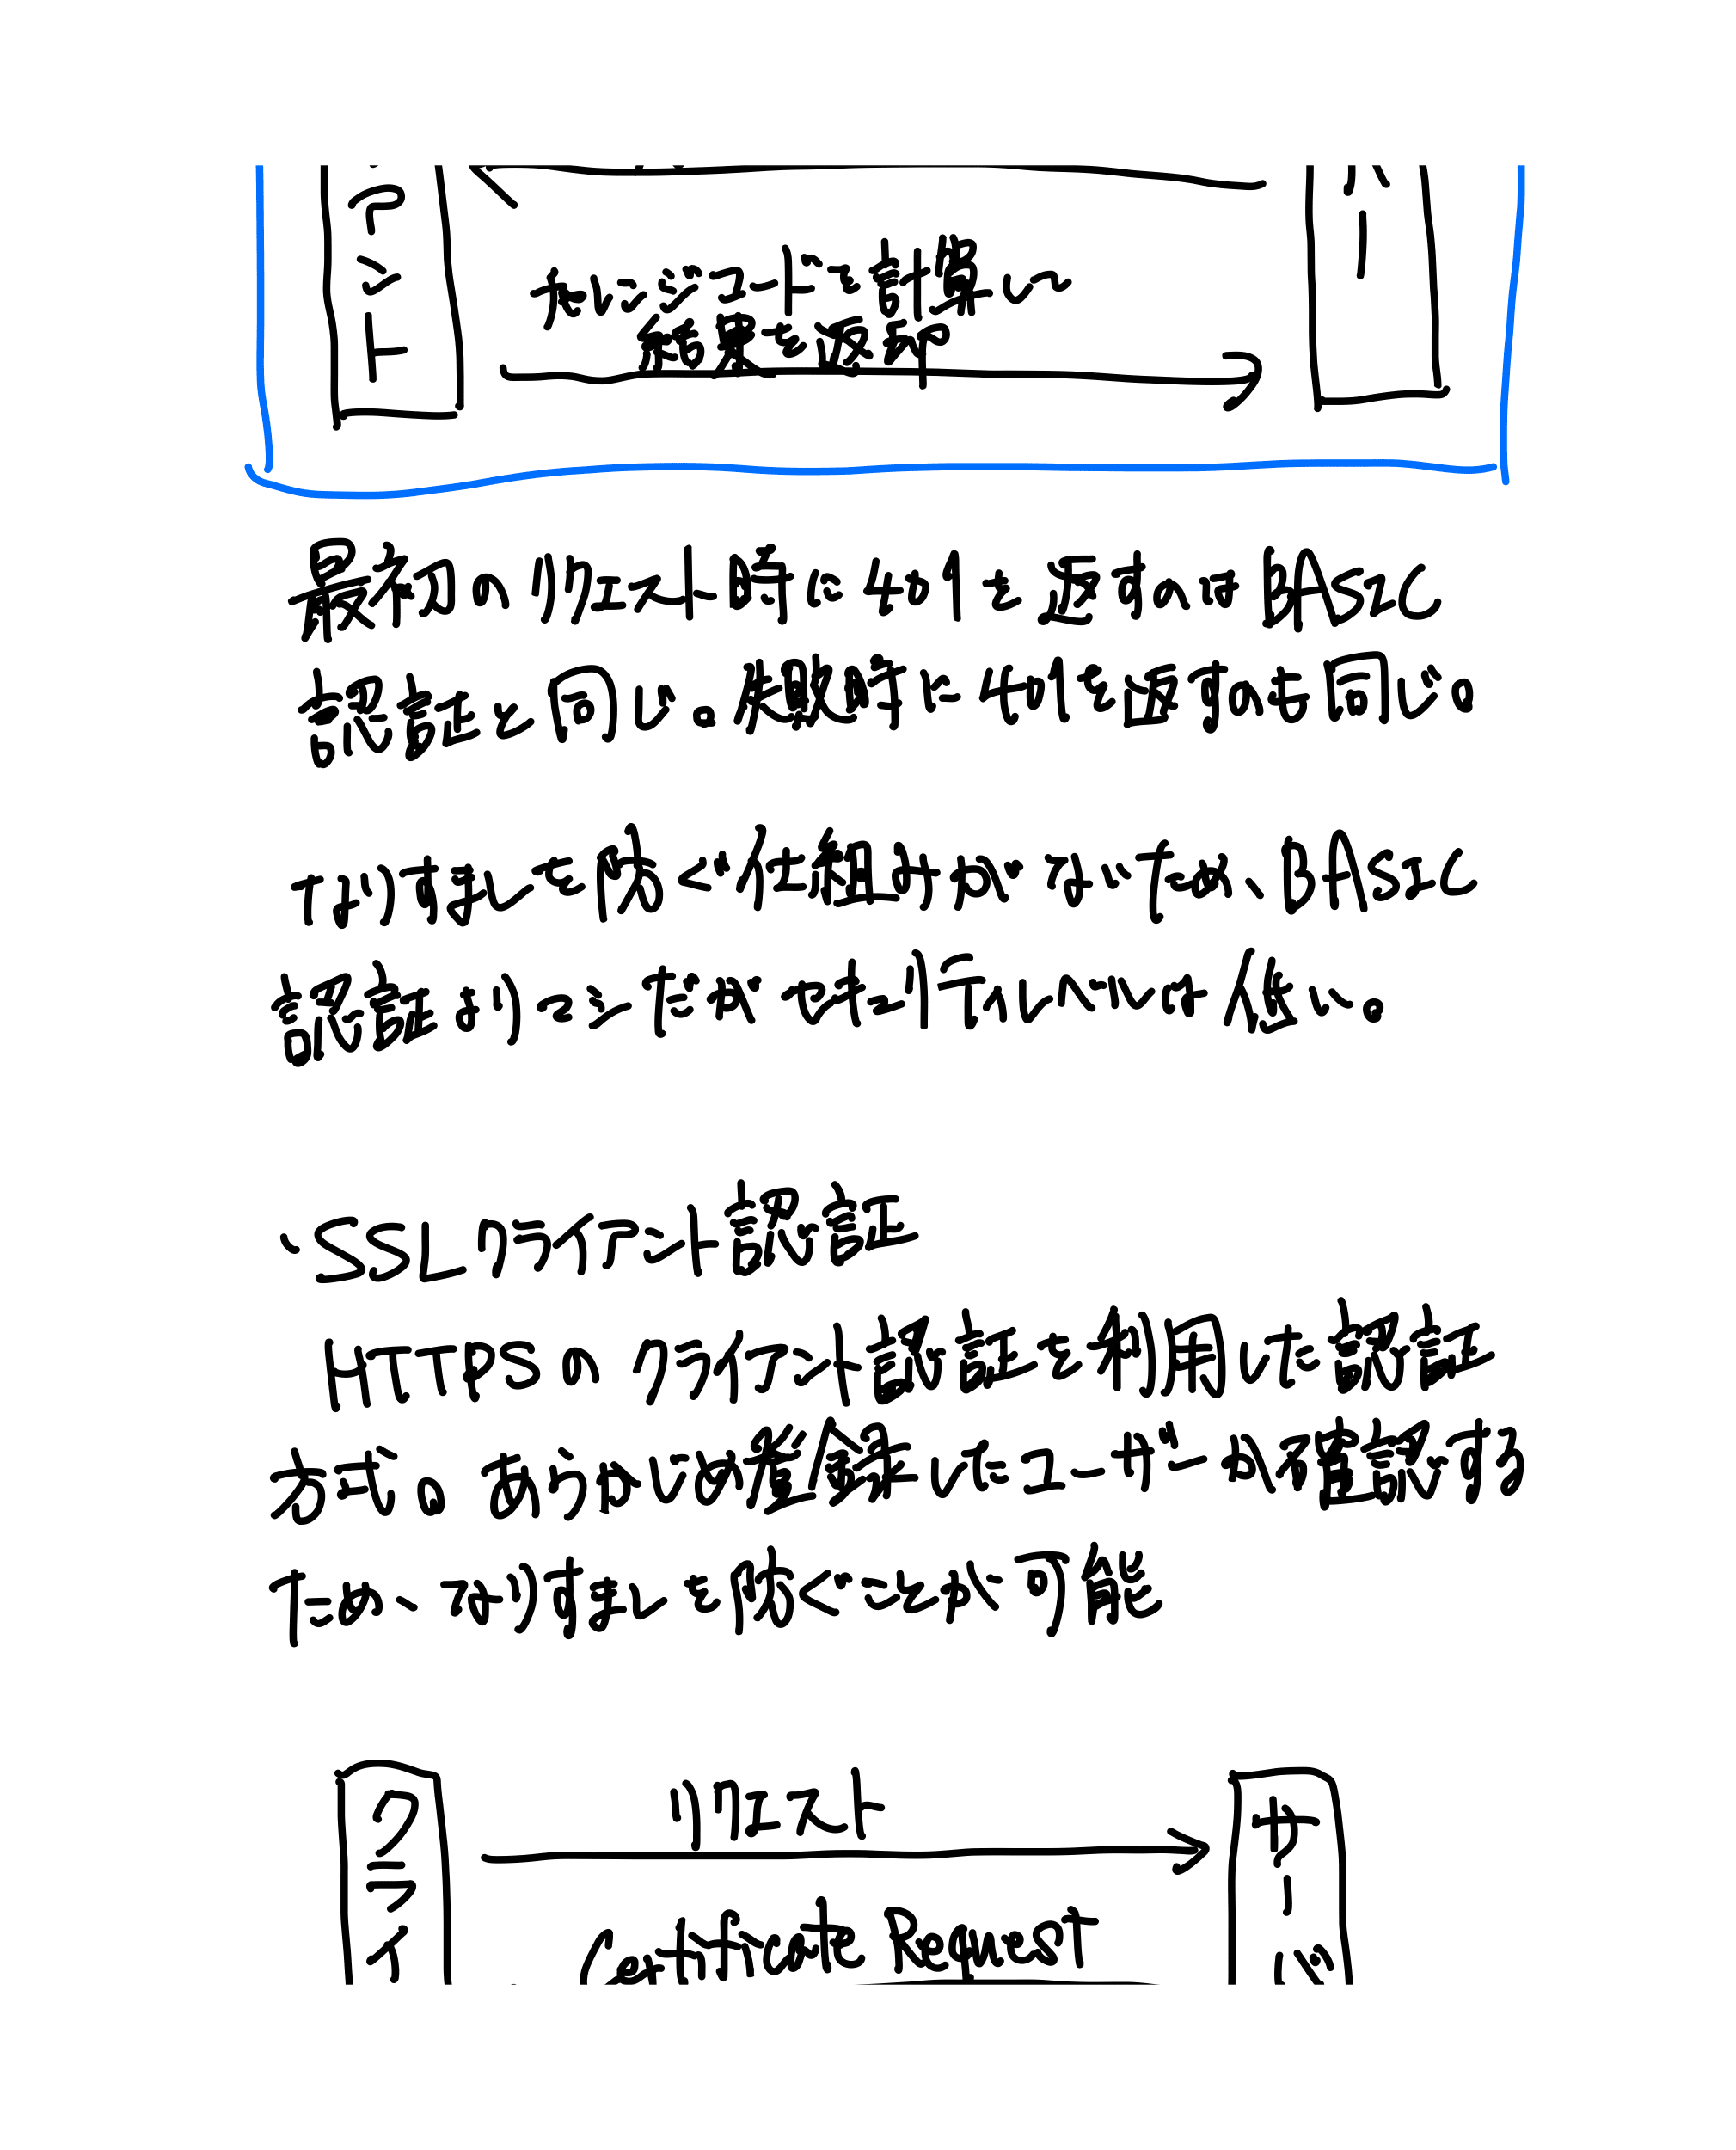
- BASIC認証の欠点を補う。チャレンジレスポンス方式(認証要求 → チャレンジコード → 計算して結果を返却)。
- 最初のリクエスト時/失敗時に401を返すのはBASICと同じ。なりすましを防ぐ仕組みがないため、BASICよりマシだがセキュリティレベルは低い。
- SSLクライアント認証
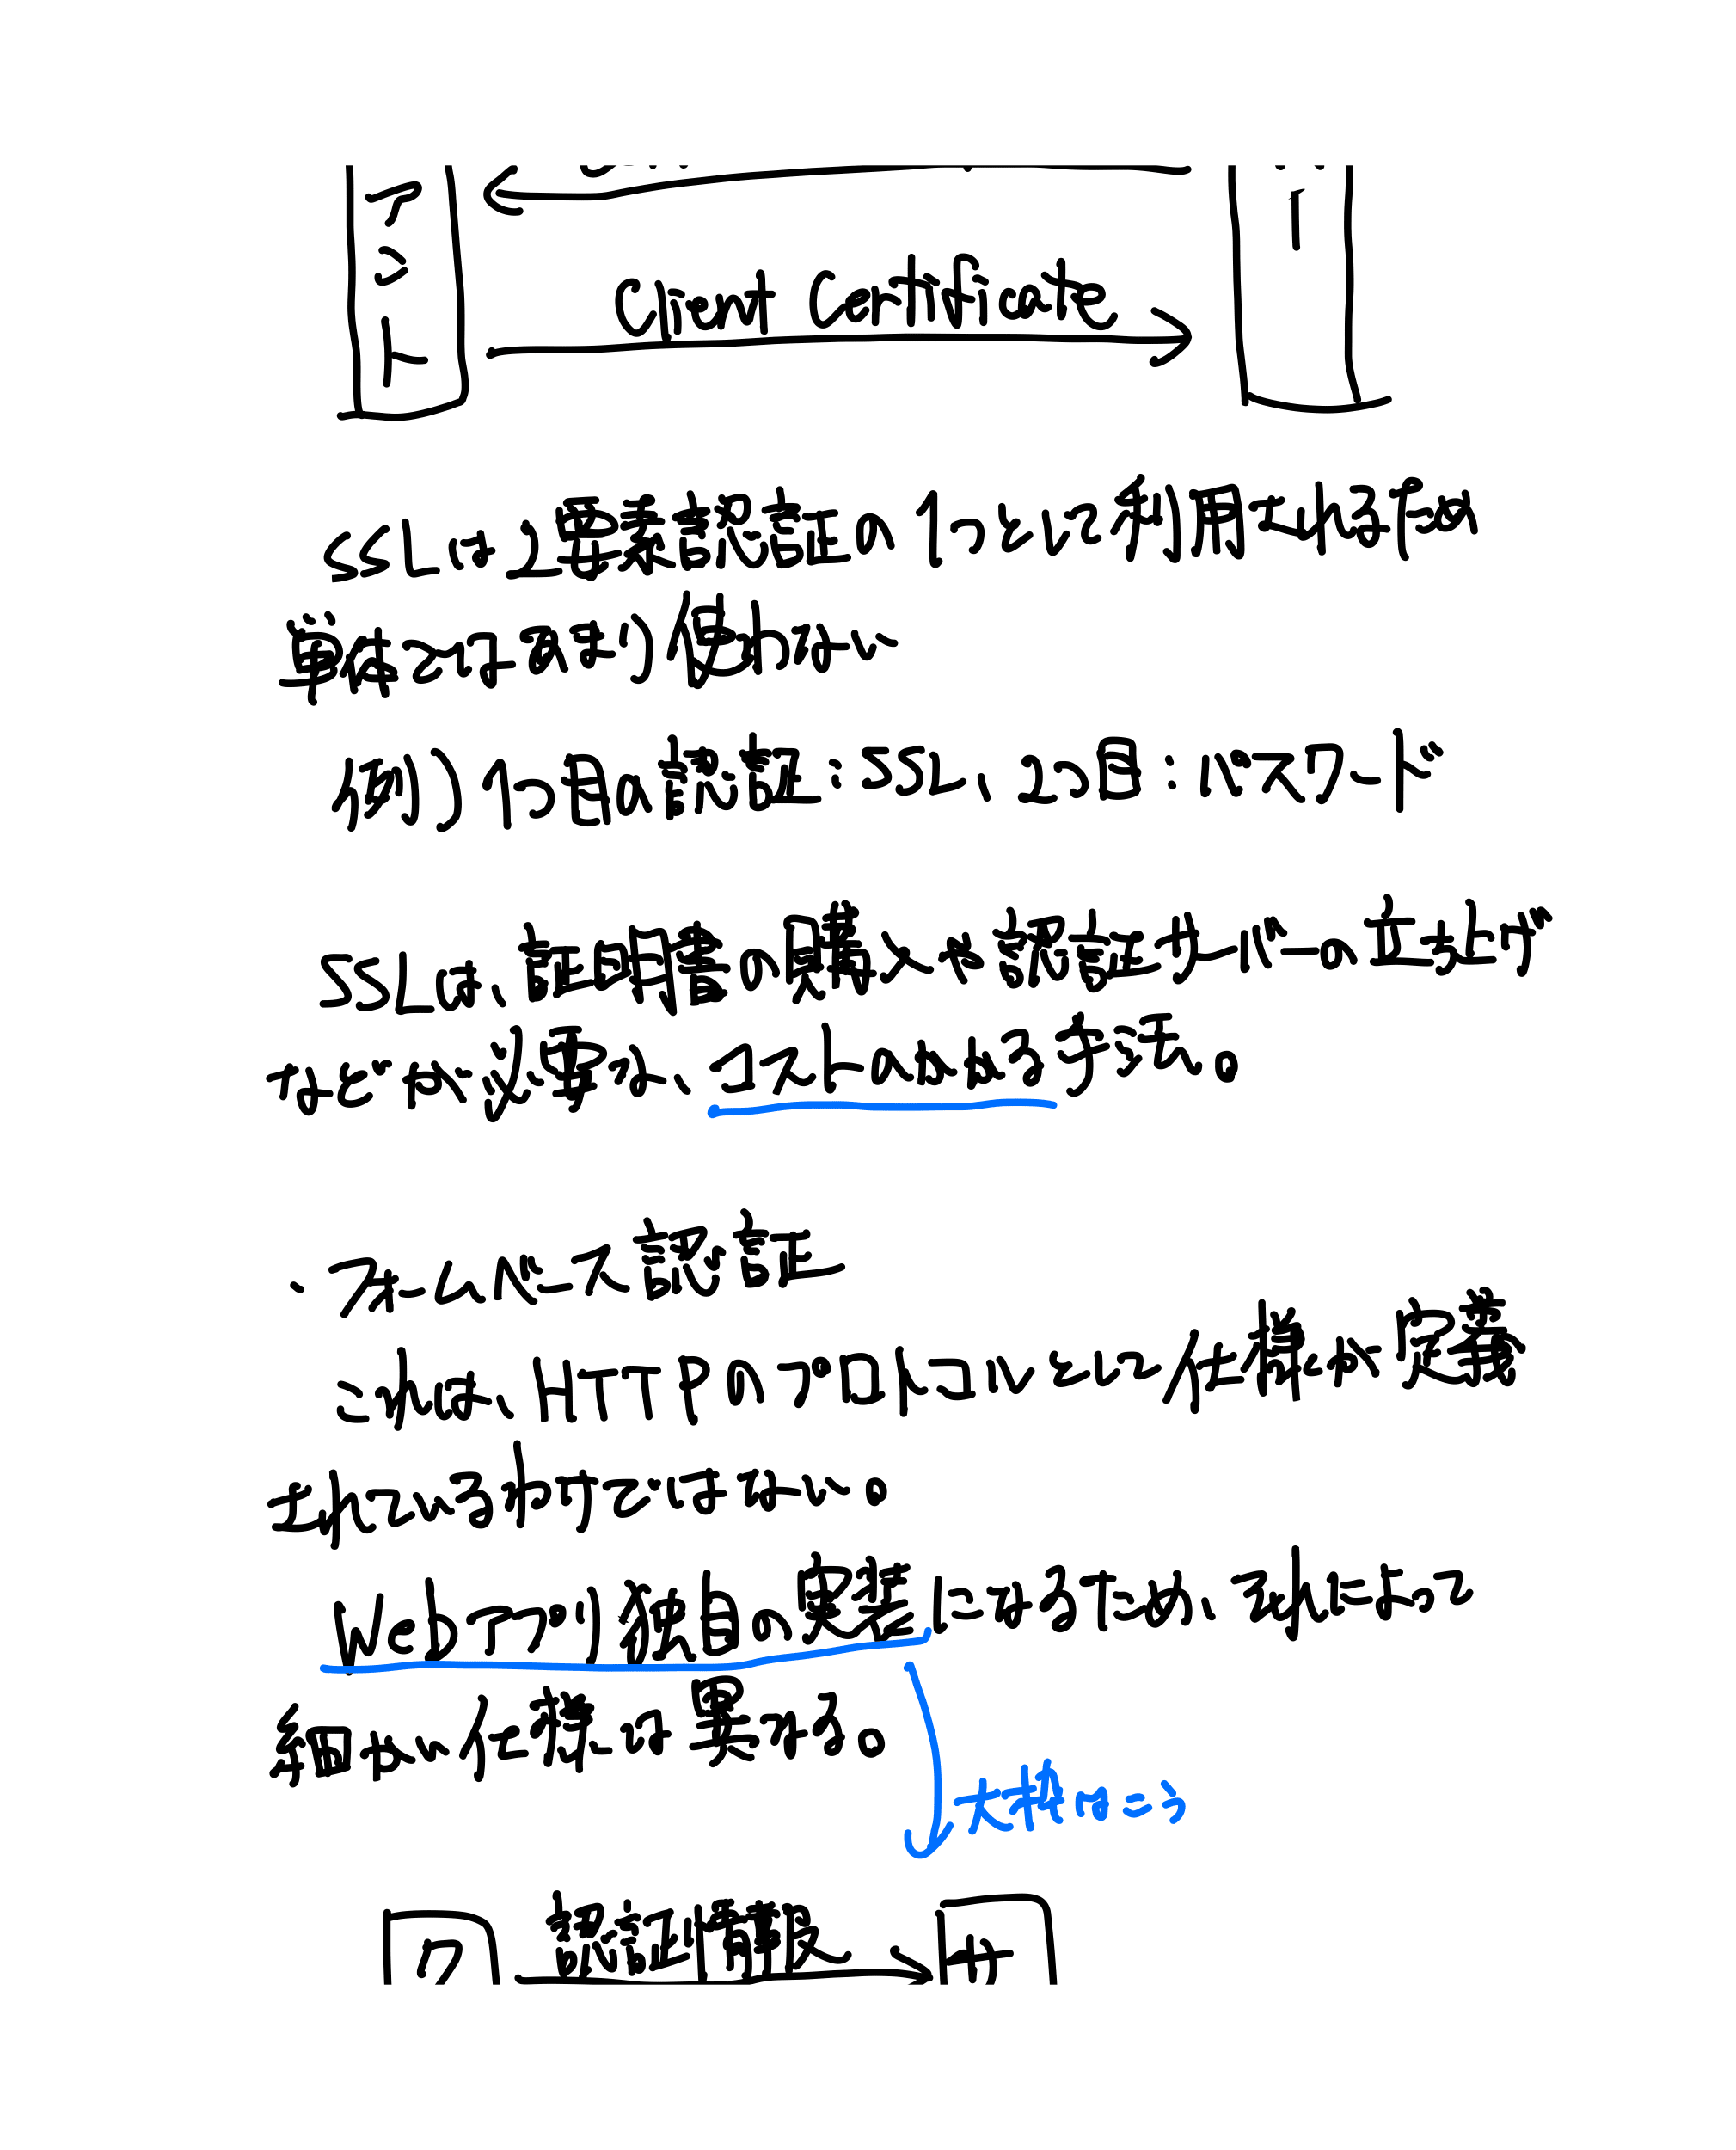
- HTTPSのクライアント認証を利用。あらかじめ登録したユーザーを確認するため、なりすましを防げる。
- 2要素認証の1つとして利用されることが多く(例:1つ目SSL+2つ目パスワード)、単体ではあまり使わない。
- 証明書の購入や認証サーバーの立ち上げが必要で、コストのかかる手法。
- フォームベース認証
- HTTPのプロトコル仕様として定義されているわけではなく、Webアプリ独自の実装(細かい仕様は様々)。
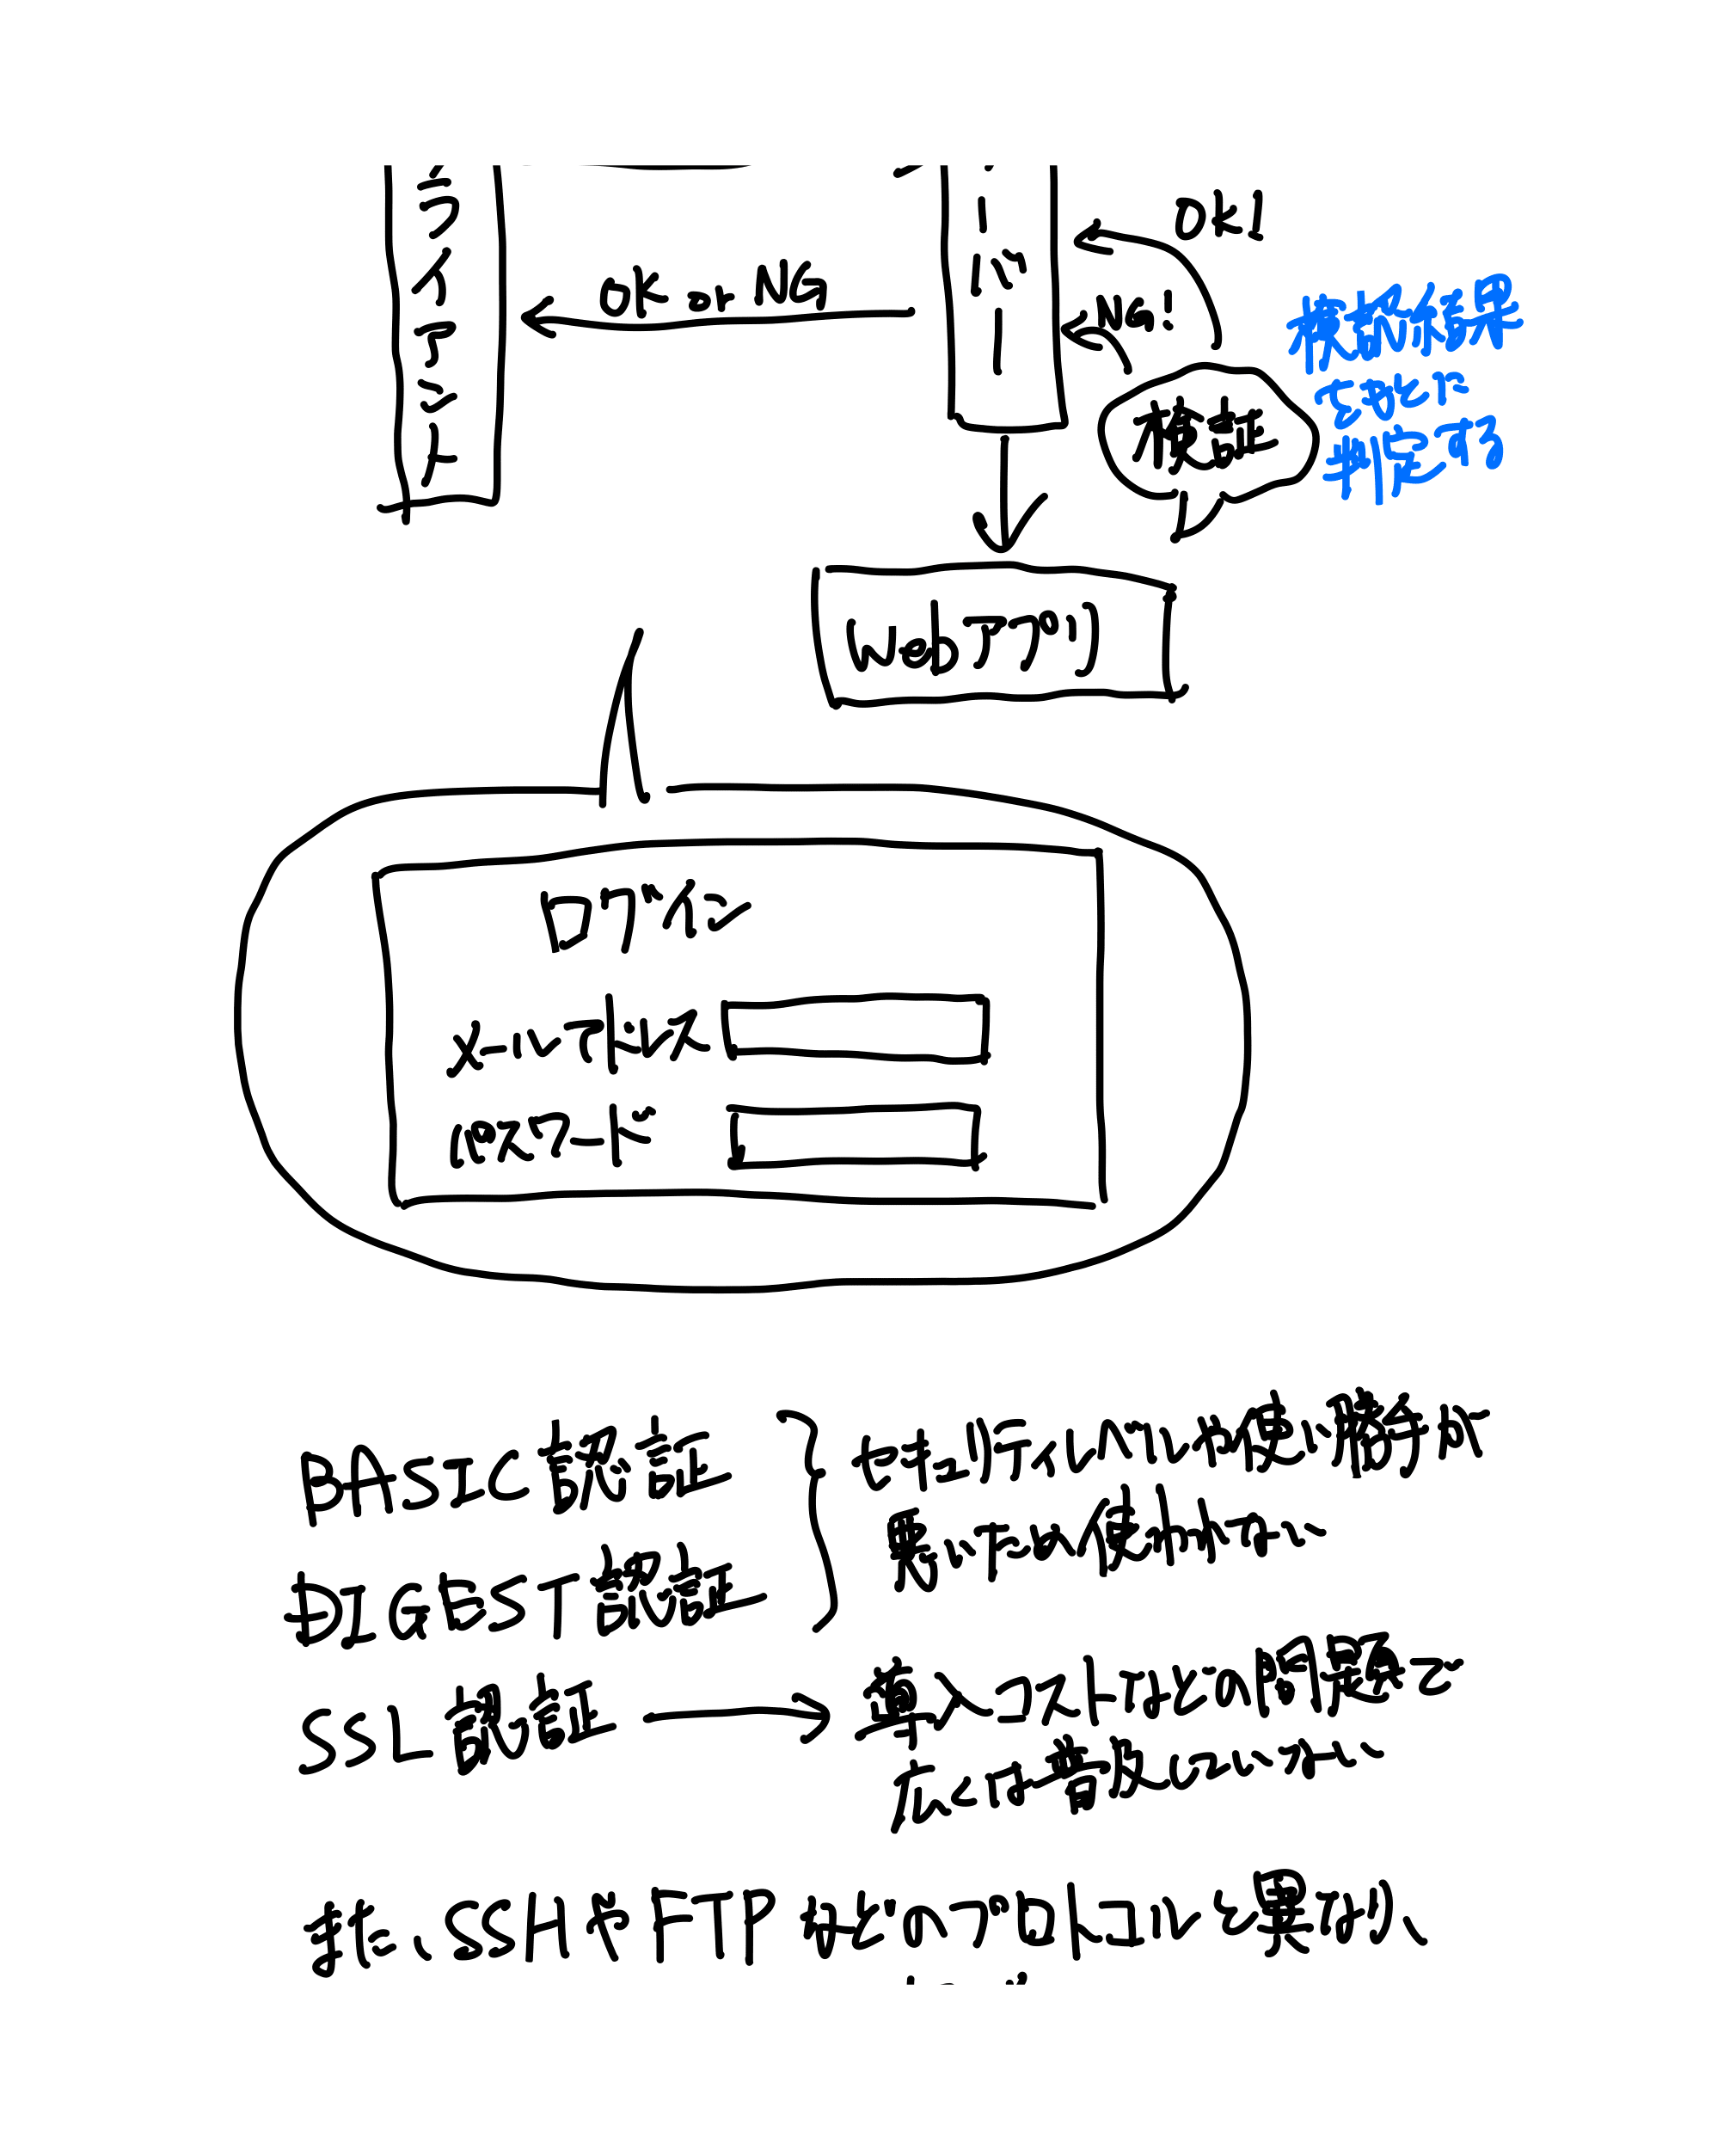
- 認証情報 → サーバー側で検証 → OK/NG を判定。ログイン画面(メールアドレス・パスワード)が典型。
補足:
- BASIC/DIGESTは使い勝手・セキュリティが悪く、SSL認証は導入コストの問題であまり普及していない。
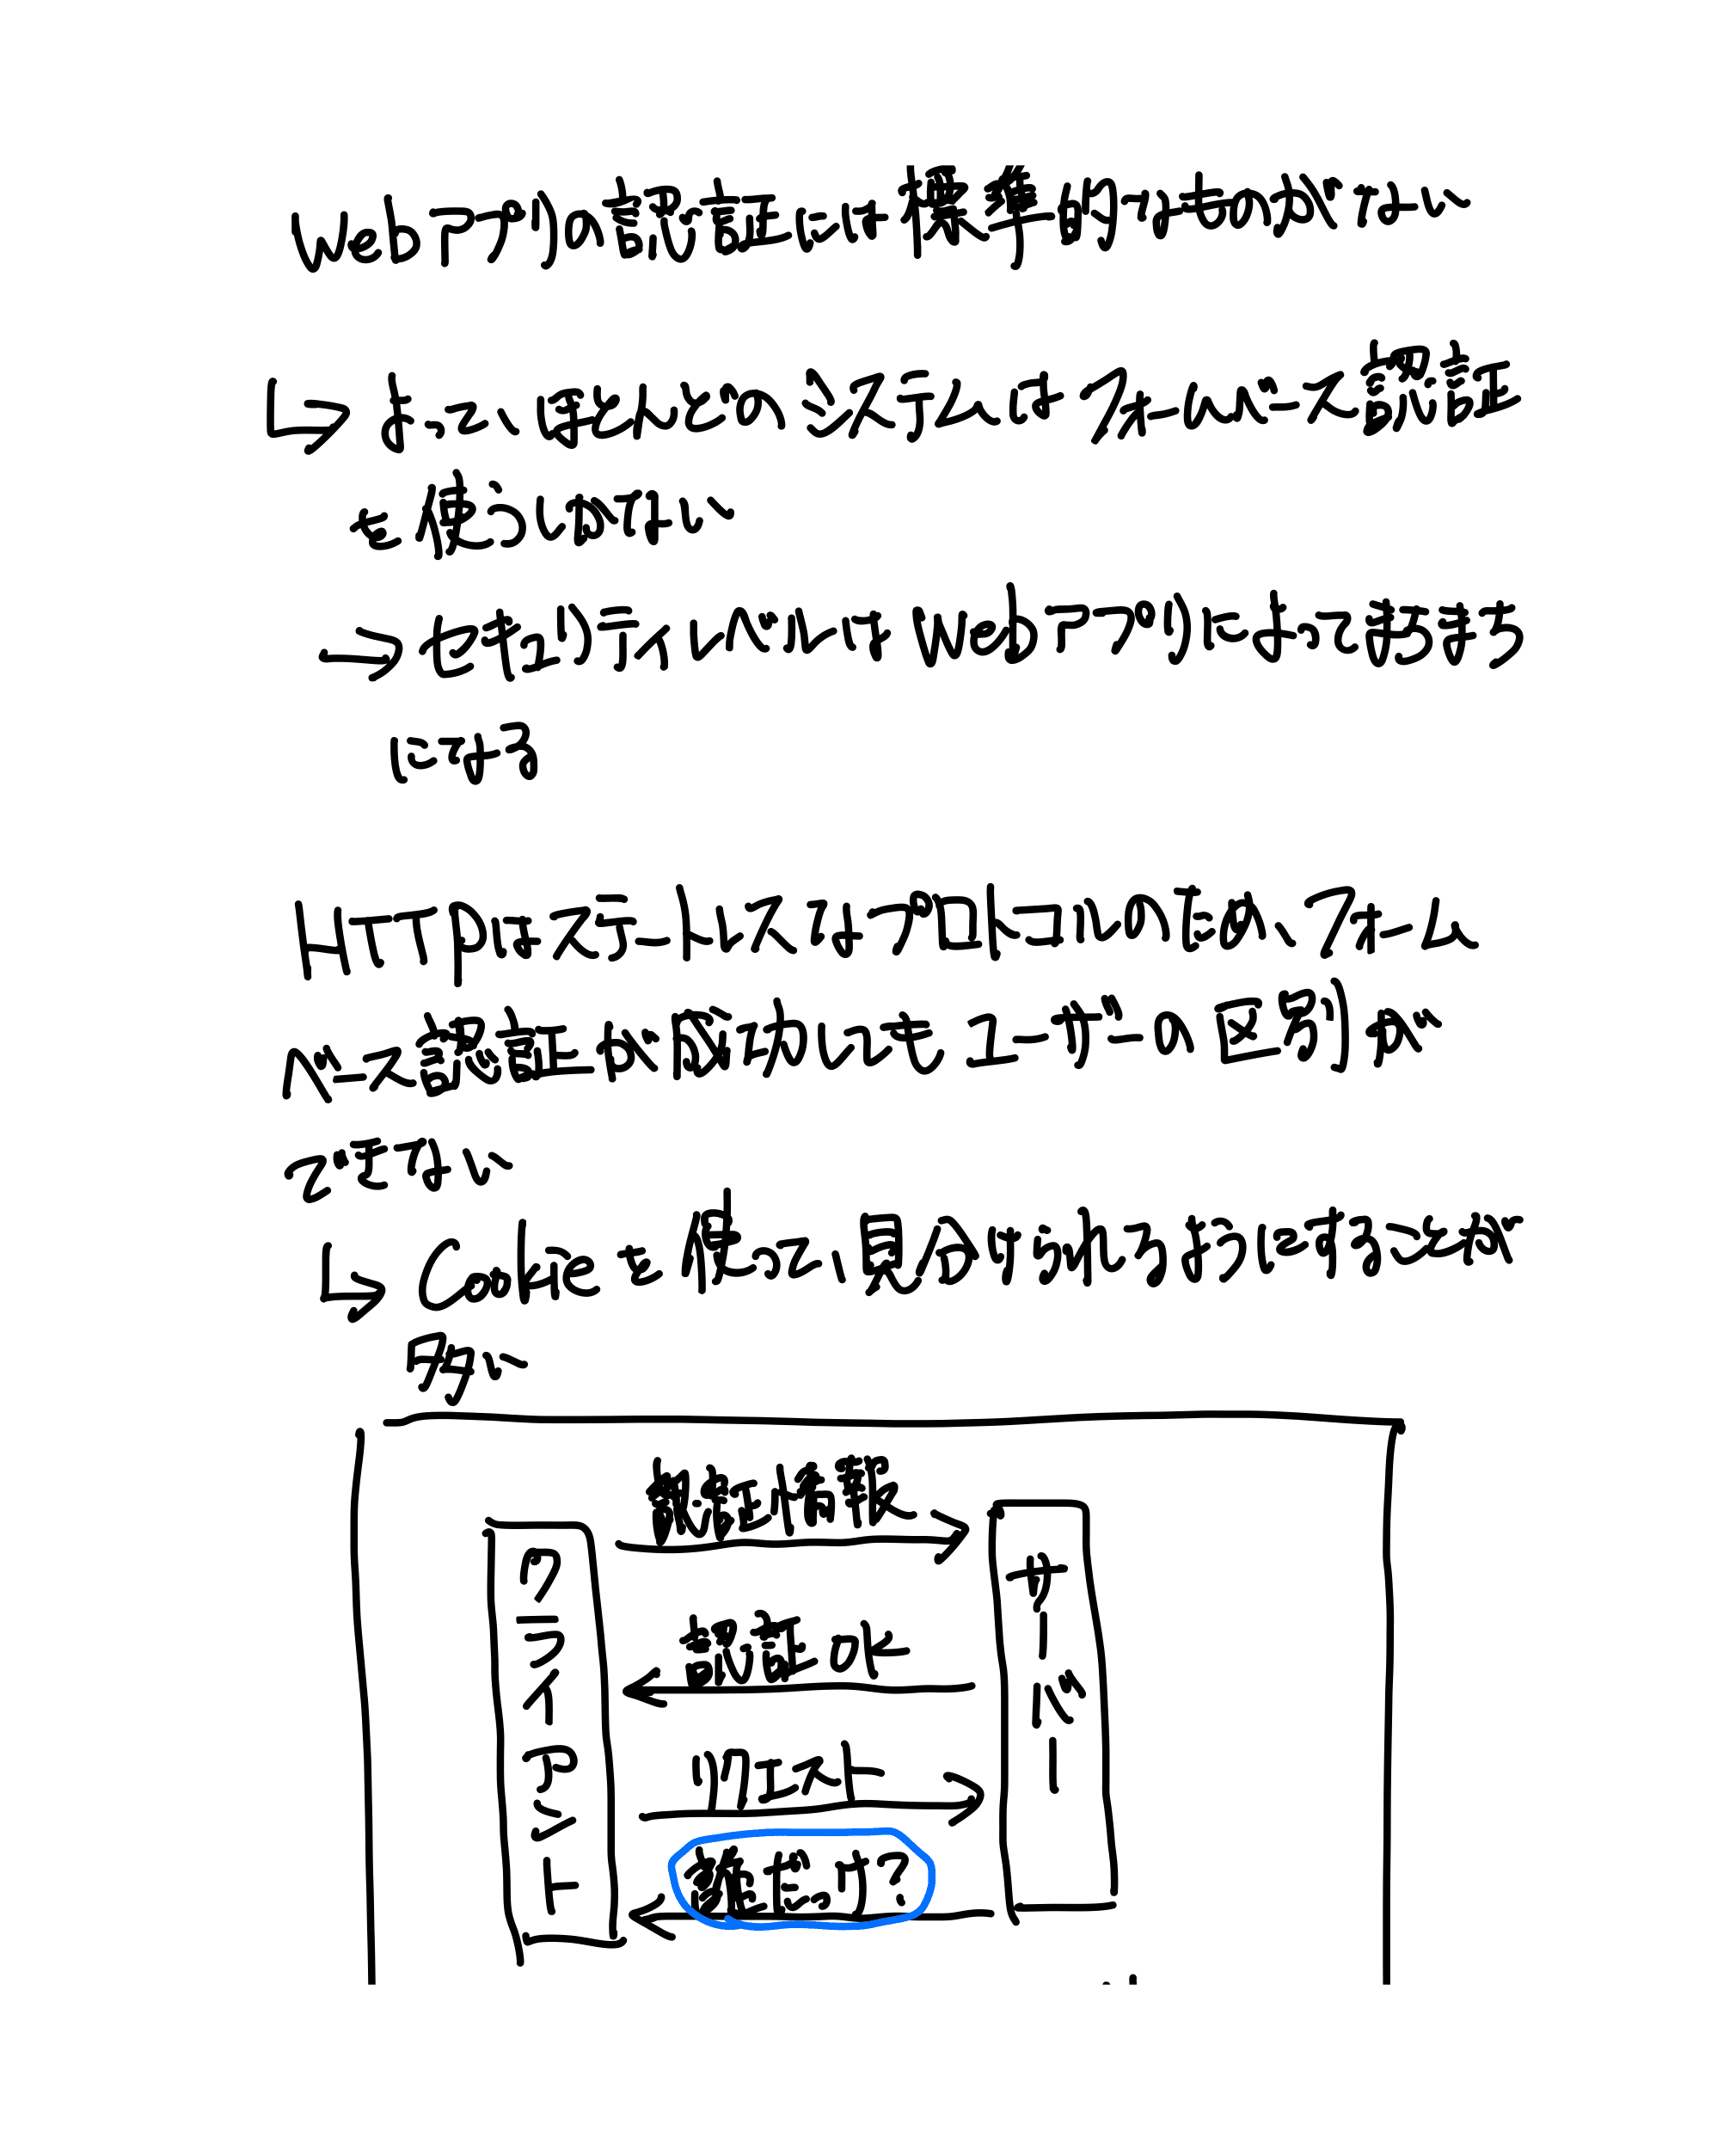
- SSHやFTPと違い、Webアプリの認証には標準がない → ほとんどのシステムはフォームベース認証を使うしかない → セキュリティレベルはWebアプリによってまちまち。
- HTTPはステートレスなので、フォームベース認証が成功してもユーザーの区別ができない → Cookie を使って見分けられるようにすることが多い。
9章 HTTPを補完するプロトコル
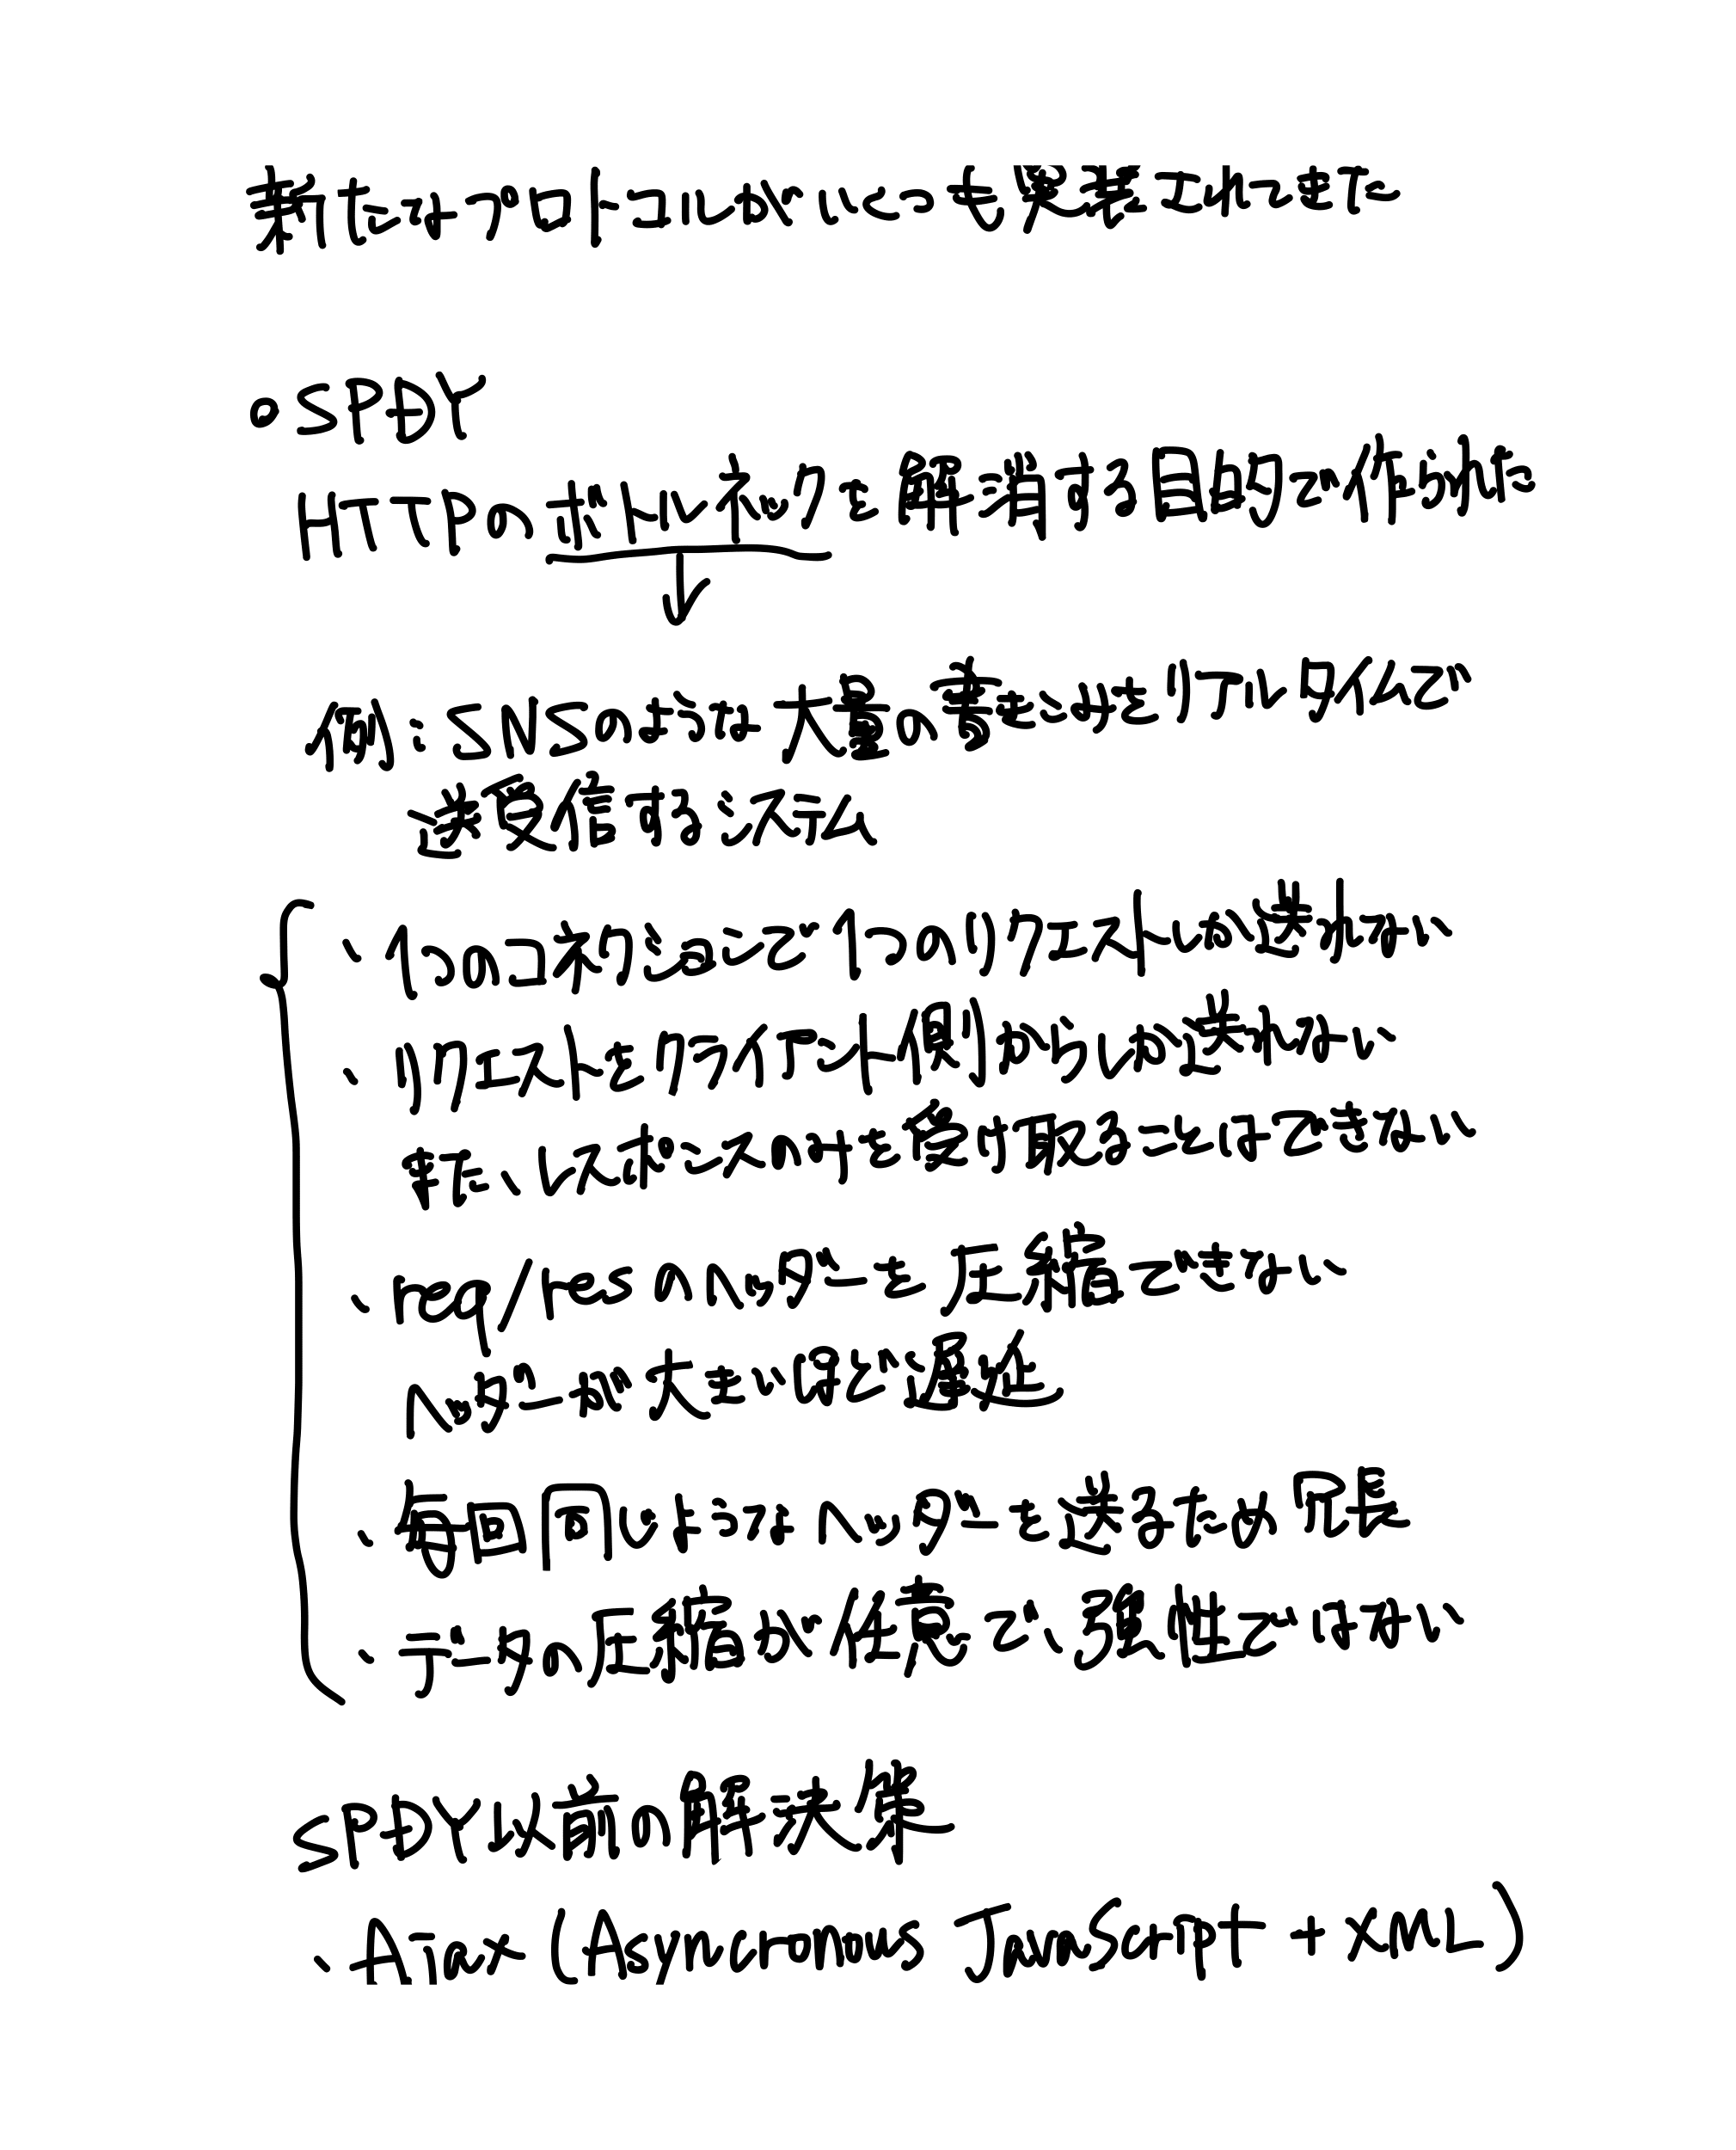
- HTTPは実装当初はHTMLの転送が目的。現在は用途が増えHTTPだけでは不十分だが、急に別プロトコルには乗り換えられない → HTTPをベースに追加する形で新プロトコルが実装されてきた。
SPDY
- HTTPのボトルネックを解消する目的で作られた(例:SNSのような大量書き込みをリアルタイムで送受信するシステム)。
- HTTPのボトルネック:
- 1つのコネクションで1リクエストしか送れない
- リクエストをクライアント側からしか送れない(レスポンスのみ受け取ることはできない)
- req/res のヘッダーを圧縮できない(ヘッダーが大きいほど遅延)
- 毎回同じようなヘッダーを送るため冗長
- データの圧縮が任意で強制ではない
- SPDY以前の解決策:
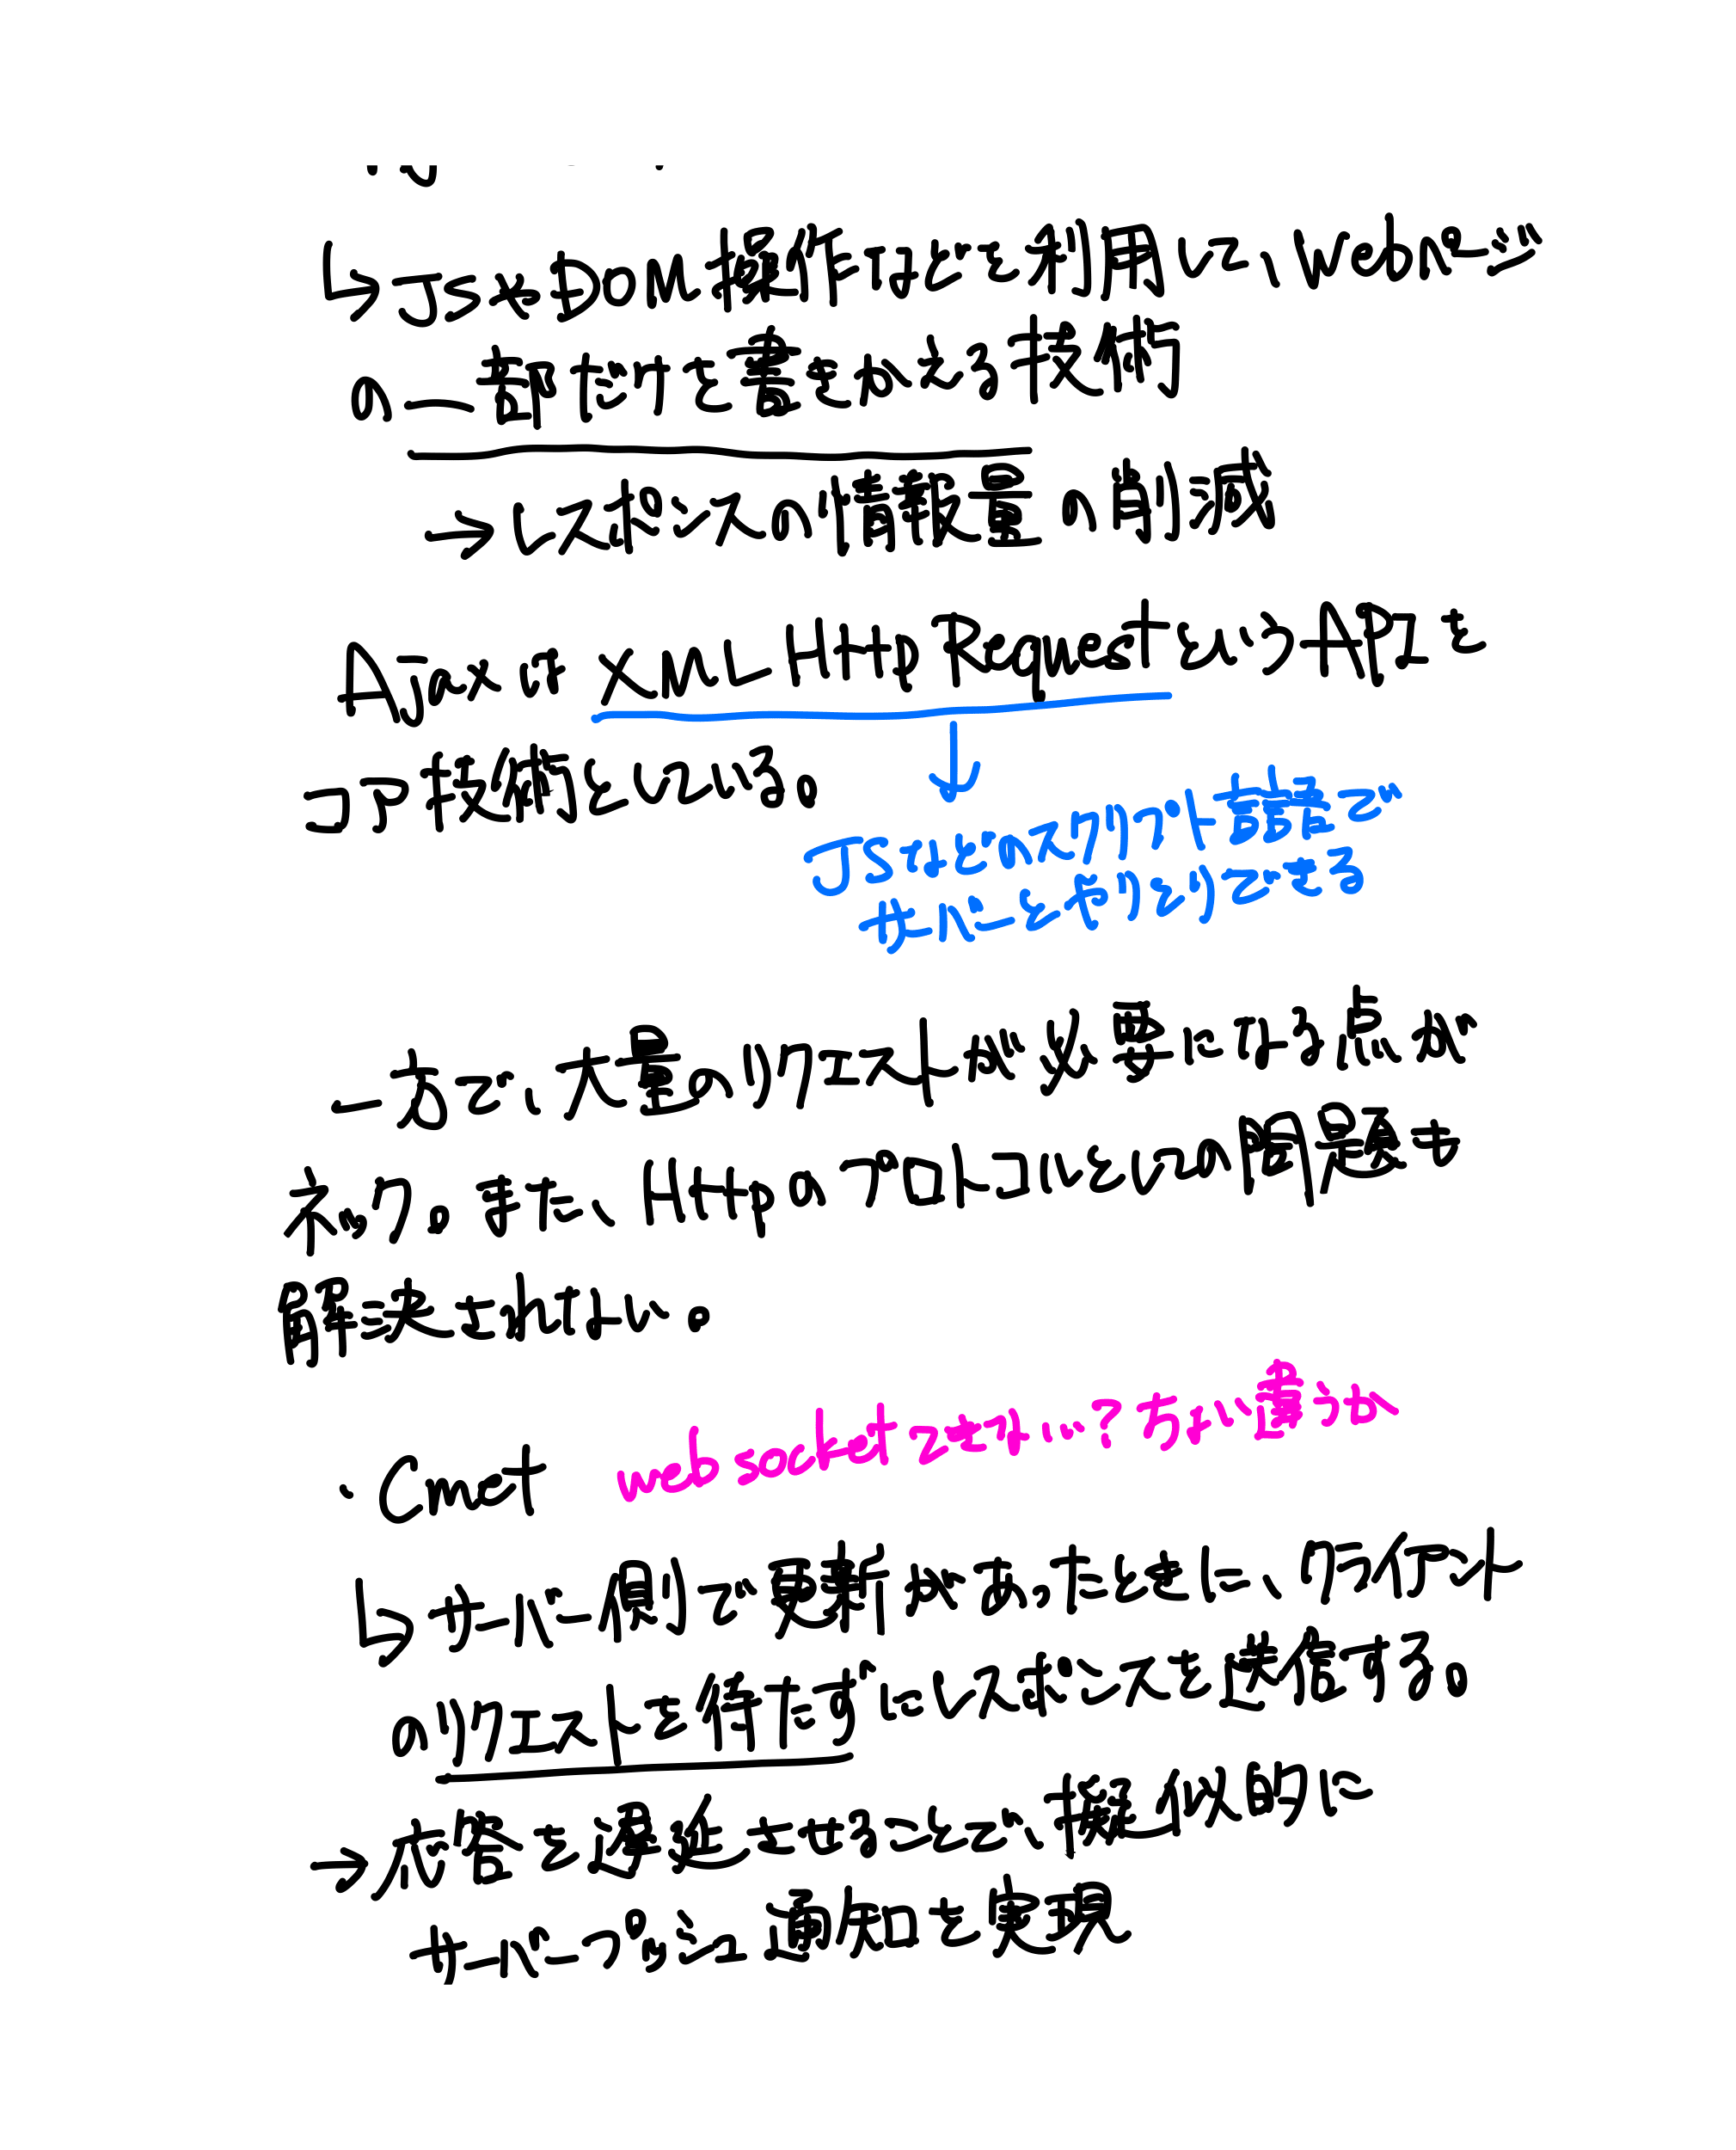
- Ajax(Asynchronous JavaScript + XML)→ JSやDOM操作でWebページの一部だけ書きかえる(レスポンス情報量の削減)。XMLHttpRequest をコア技術とする。大量のリクエストが必要になる点と、HTTP自体の問題が解決されない点がネック。
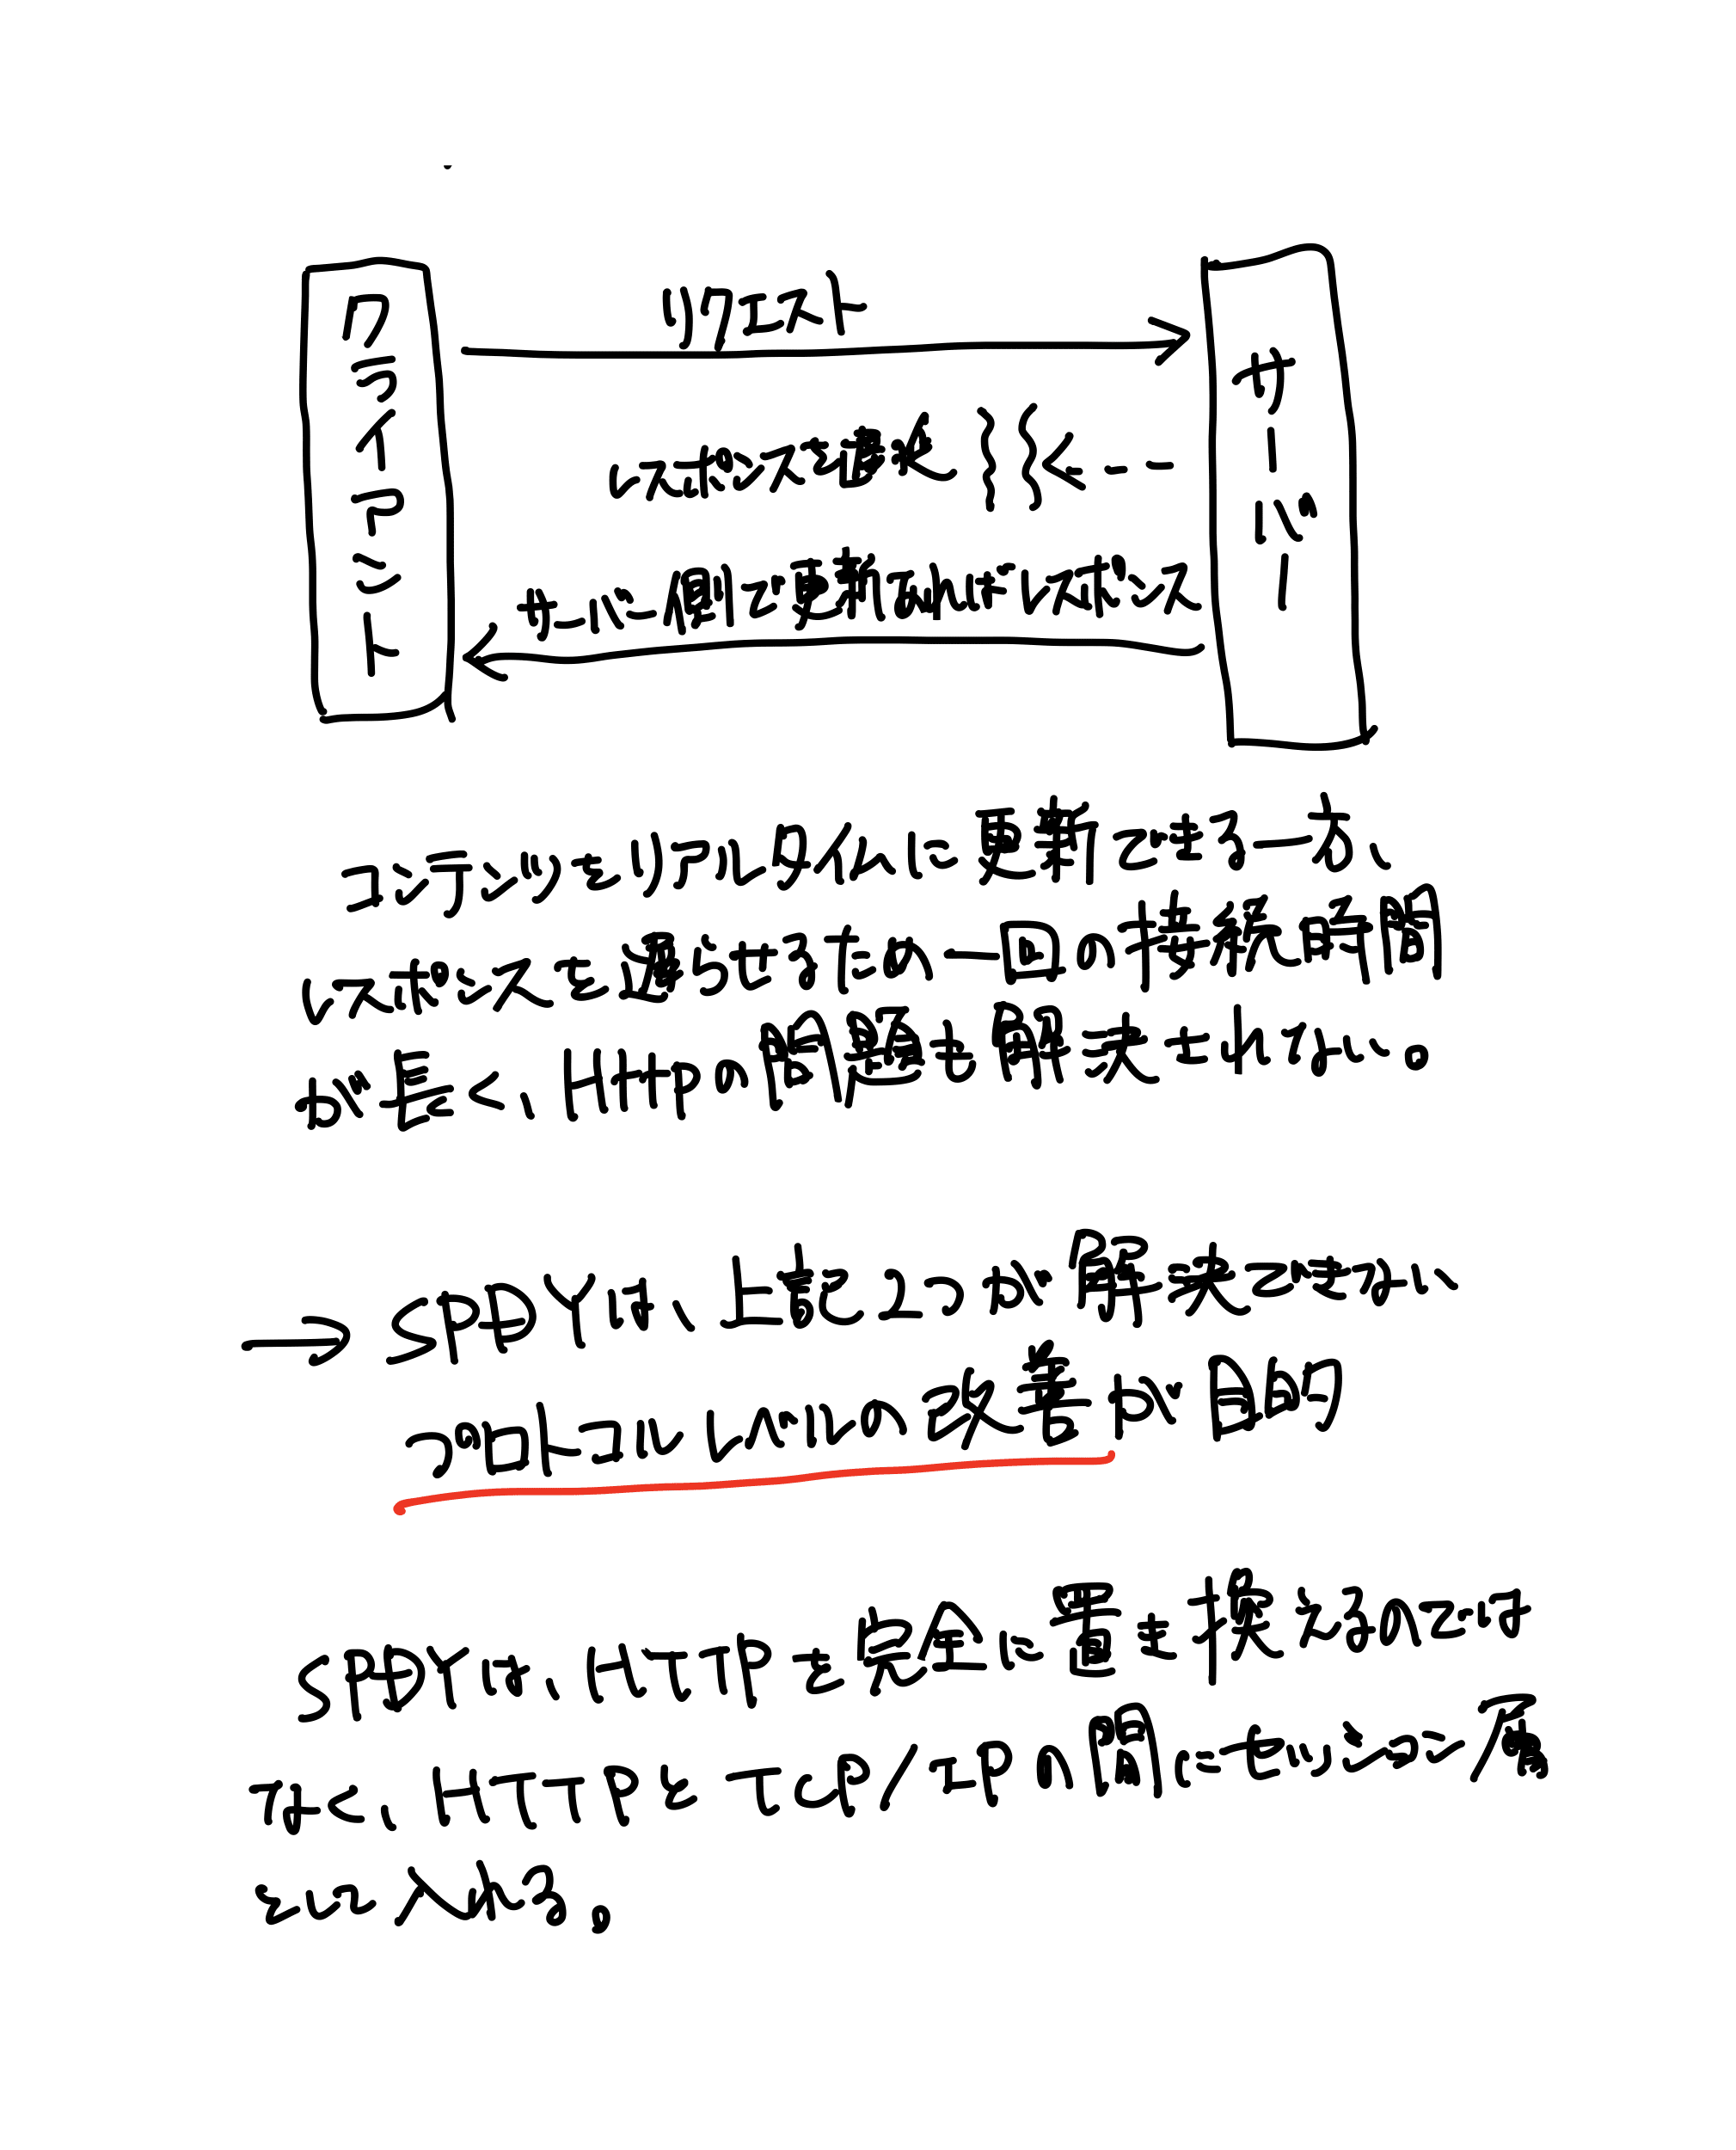
- Comet → サーバー側で更新があったとき、クライアントのリクエストを待たずにレスポンスを送る。応答を遅延させることで擬似的にサーバープッシュを実現。接続時間が長くなり、HTTPの問題も解決されない。
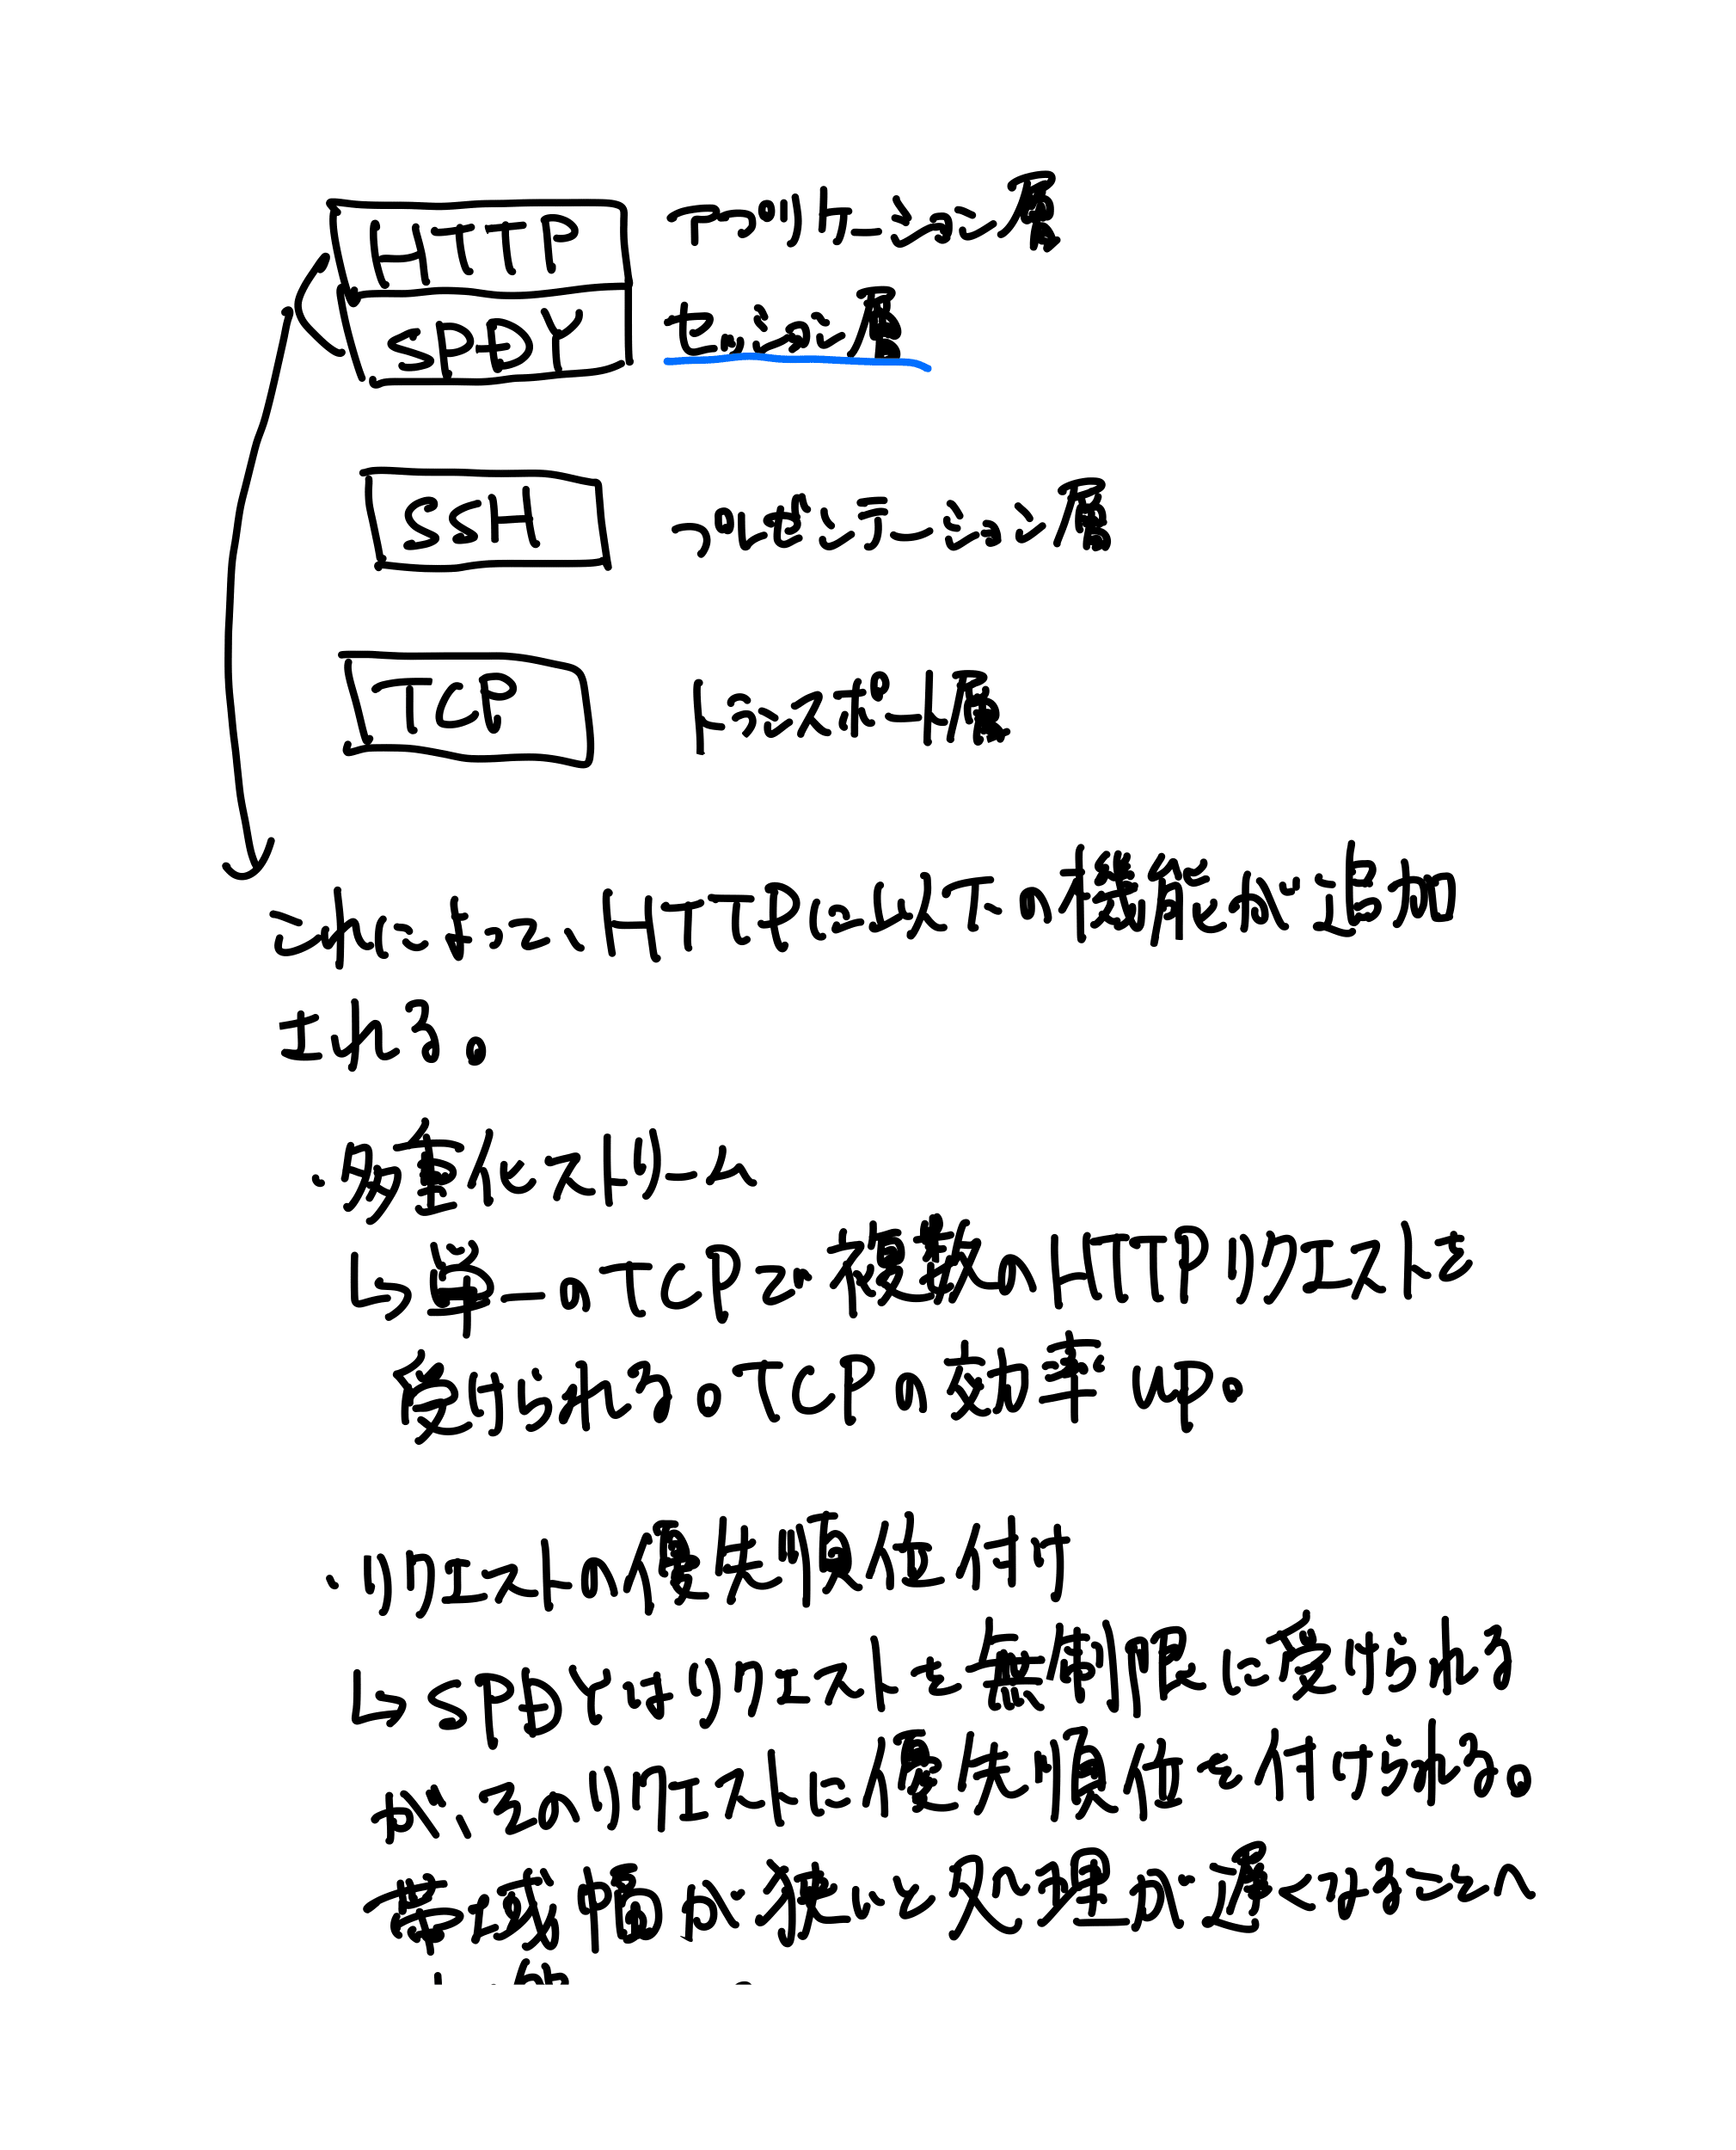
- SPDYは、上記2つが解決できないプロトコルレベルの改善が目的。HTTPを完全に置き換えるのではなく、HTTPとTCP/IPの間に「セッション層」として入れる。
- HTTP / SPDY(アプリケーション層・セッション層)→ SSH(プレゼンテーション層)→ TCP(トランスポート層)
- SPDYで追加される機能:
- 多重化ストリーム → 単一のTCPで複数のHTTPリクエストを受けられる(TCPの効率up)
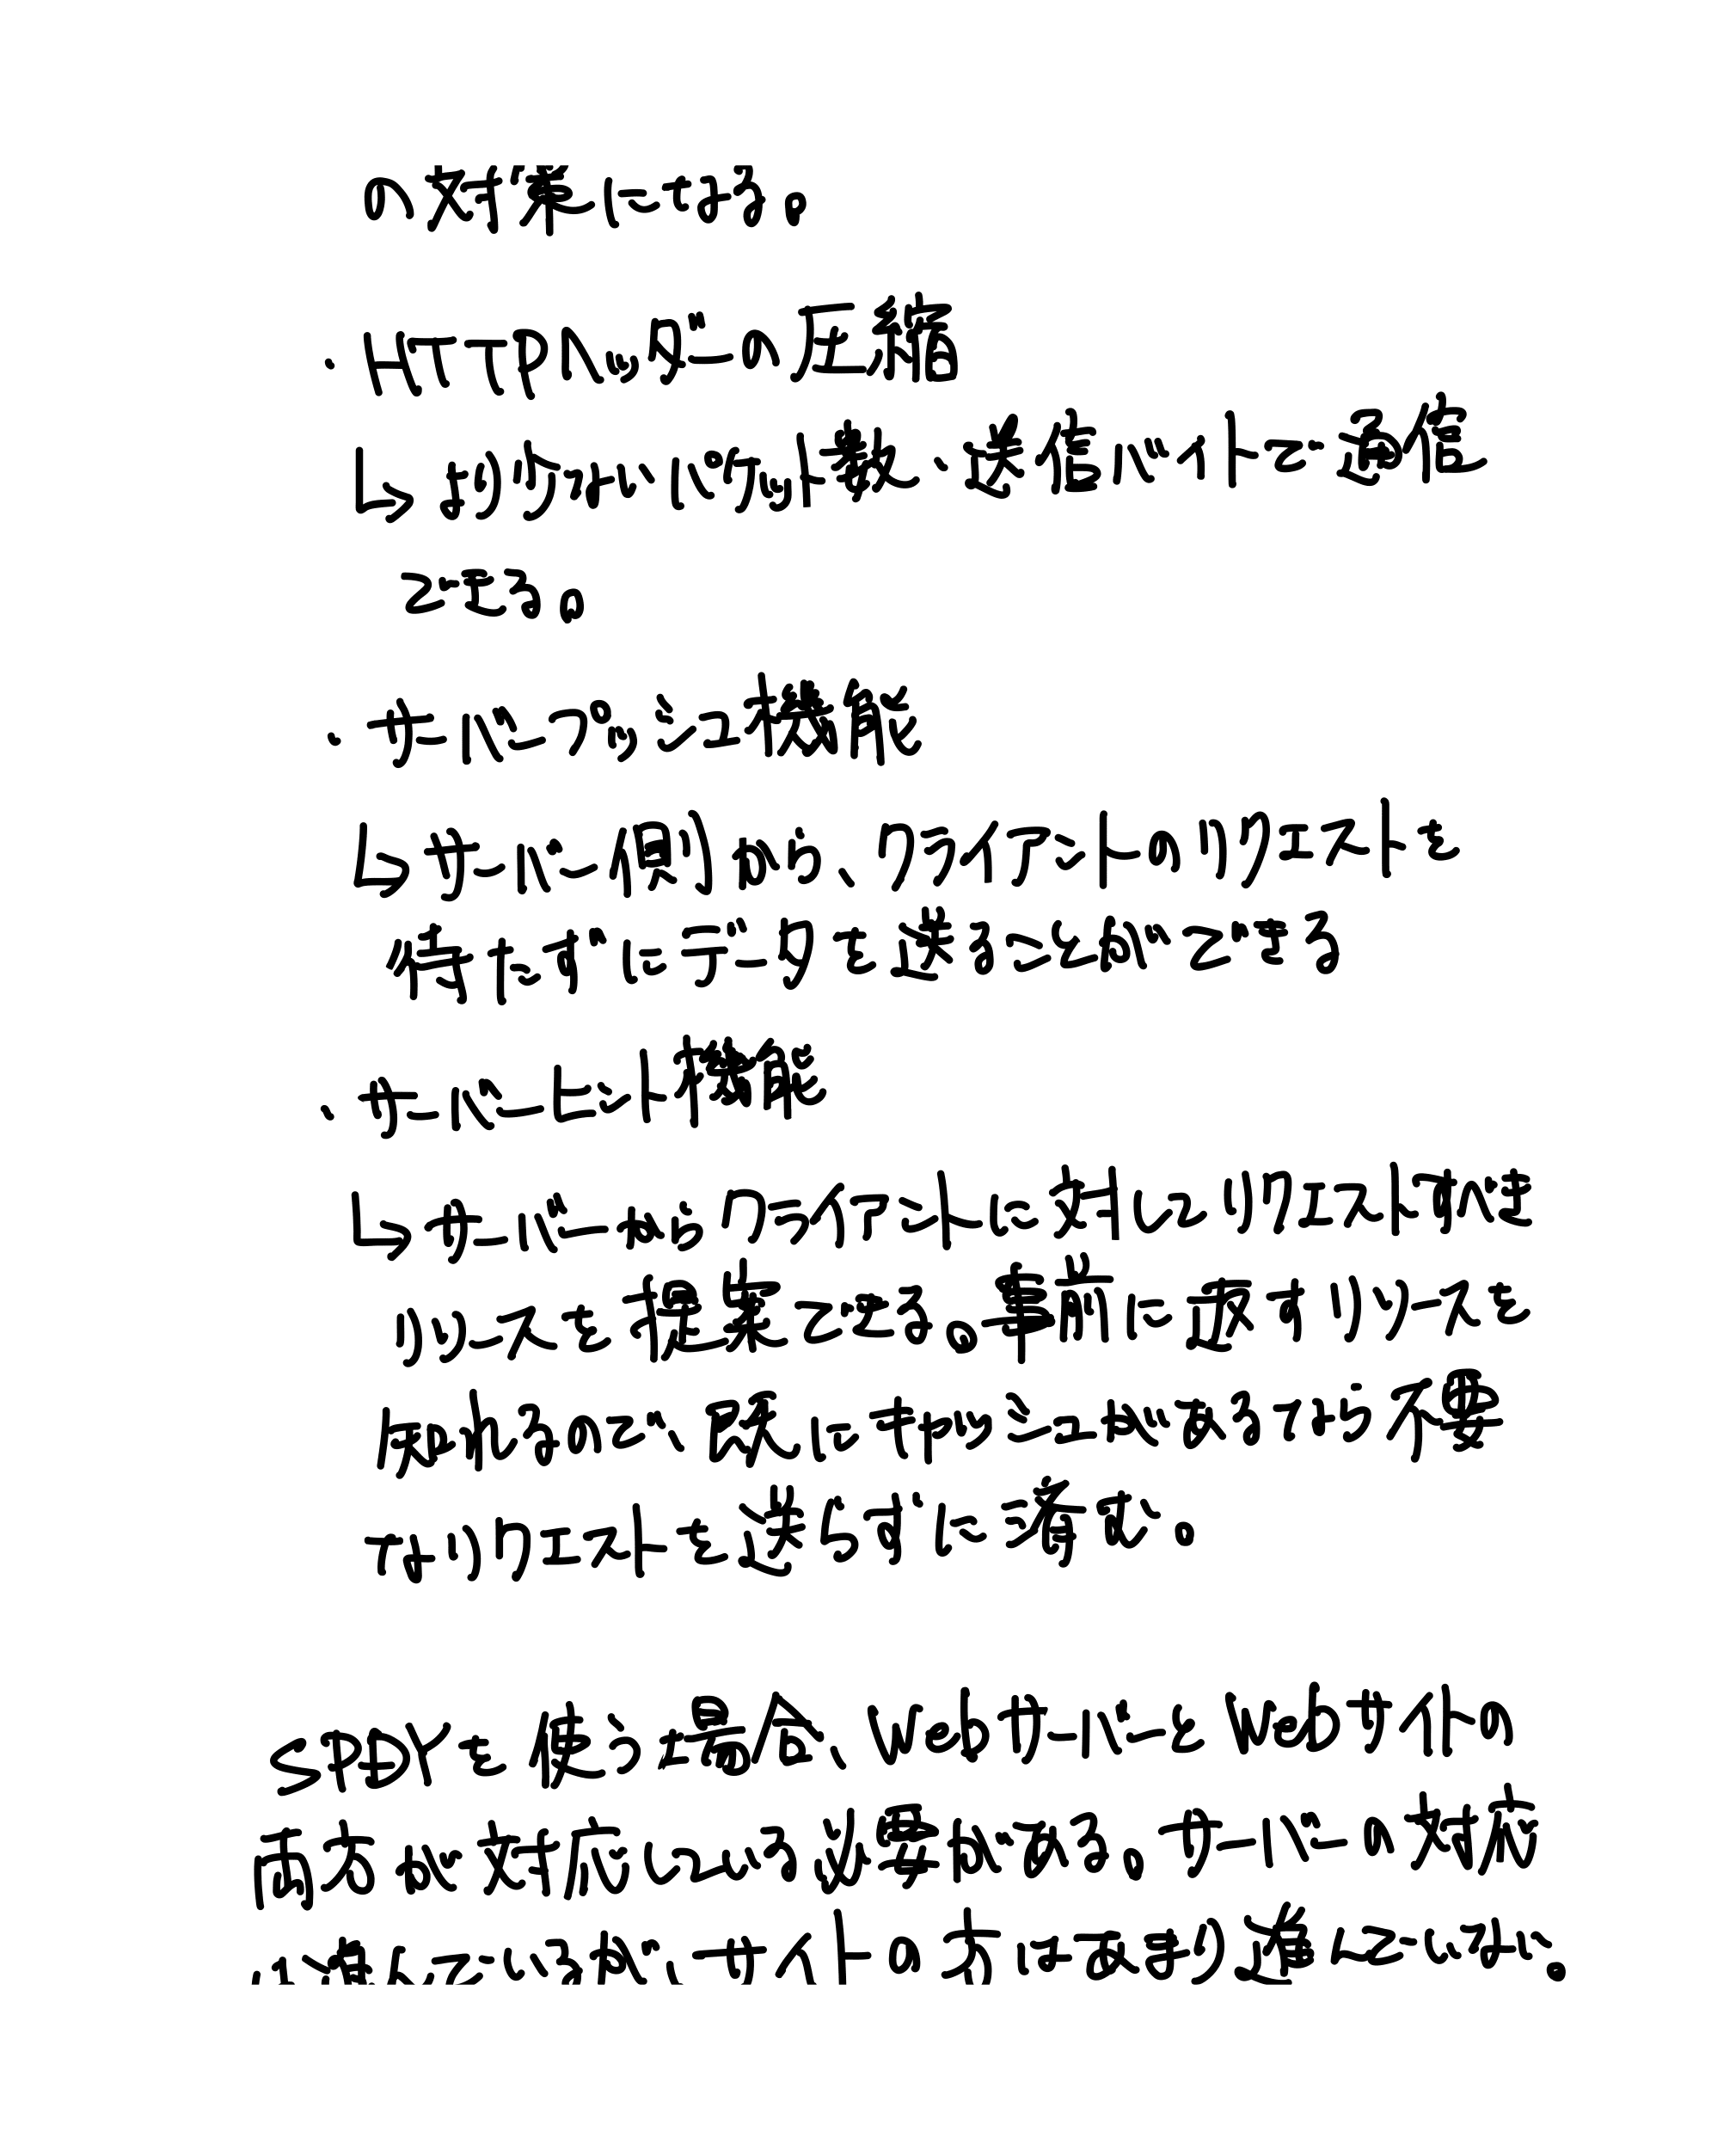
- リクエストの優先順位付け → 帯域幅が狭いと処理が遅くなることへの対策
- HTTPヘッダーの圧縮 → より少ないパケット数・送信バイトで通信できる
- サーバープッシュ機能 → クライアントのリクエストを待たずにデータを送れる
- サーバーヒント機能 → リクエストすべきリソースを提案できる。キャッシュがあれば不要なリクエストを省ける
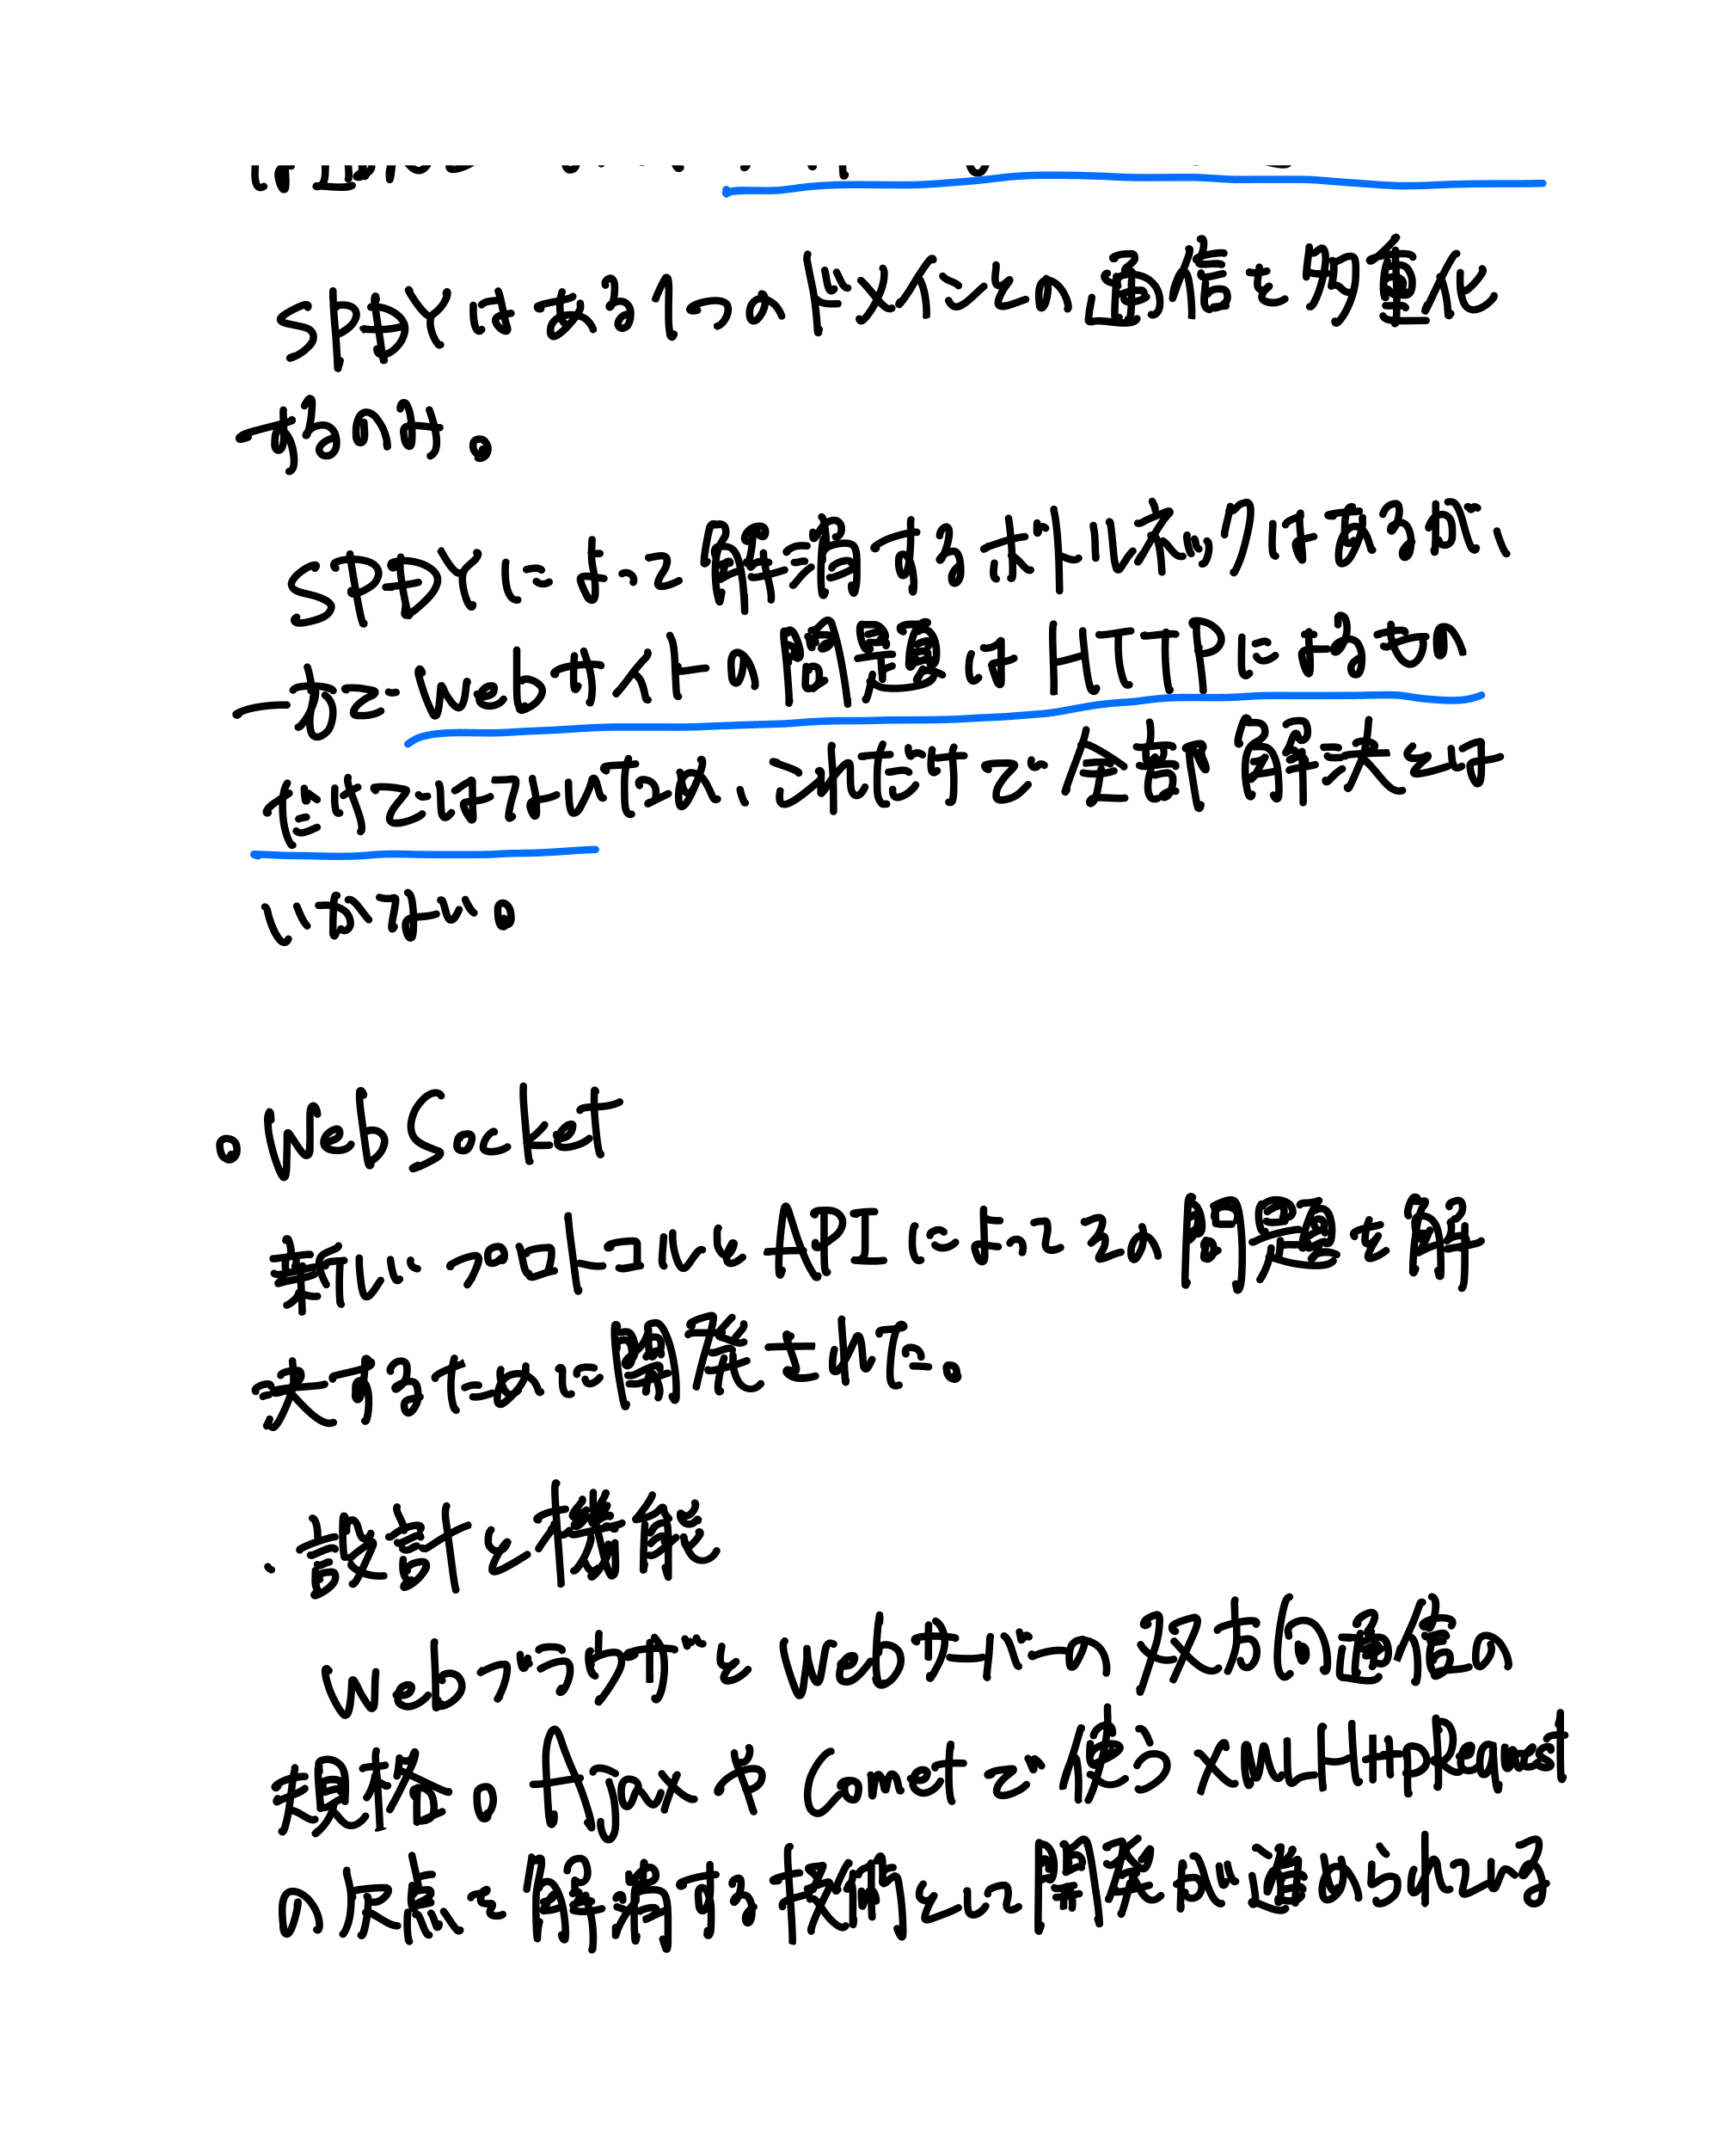
- SPDYはサーバーとサイトの両方が対応している必要がある(サーバーは進んでいるがサイトは遅れ気味)。ある1つのドメインとの通信を多重化するのみで、Webサイトの問題はHTTPだけによるものではないため、これだけで全部解決とはいかない。
WebSocket
- 新しいプロトコルとAPIで上記問題を解決するために開発。WebブラウザとWebサーバーの双方向通信の規格。Ajax や Comet の XMLHttpRequest の欠点を解消する技術。
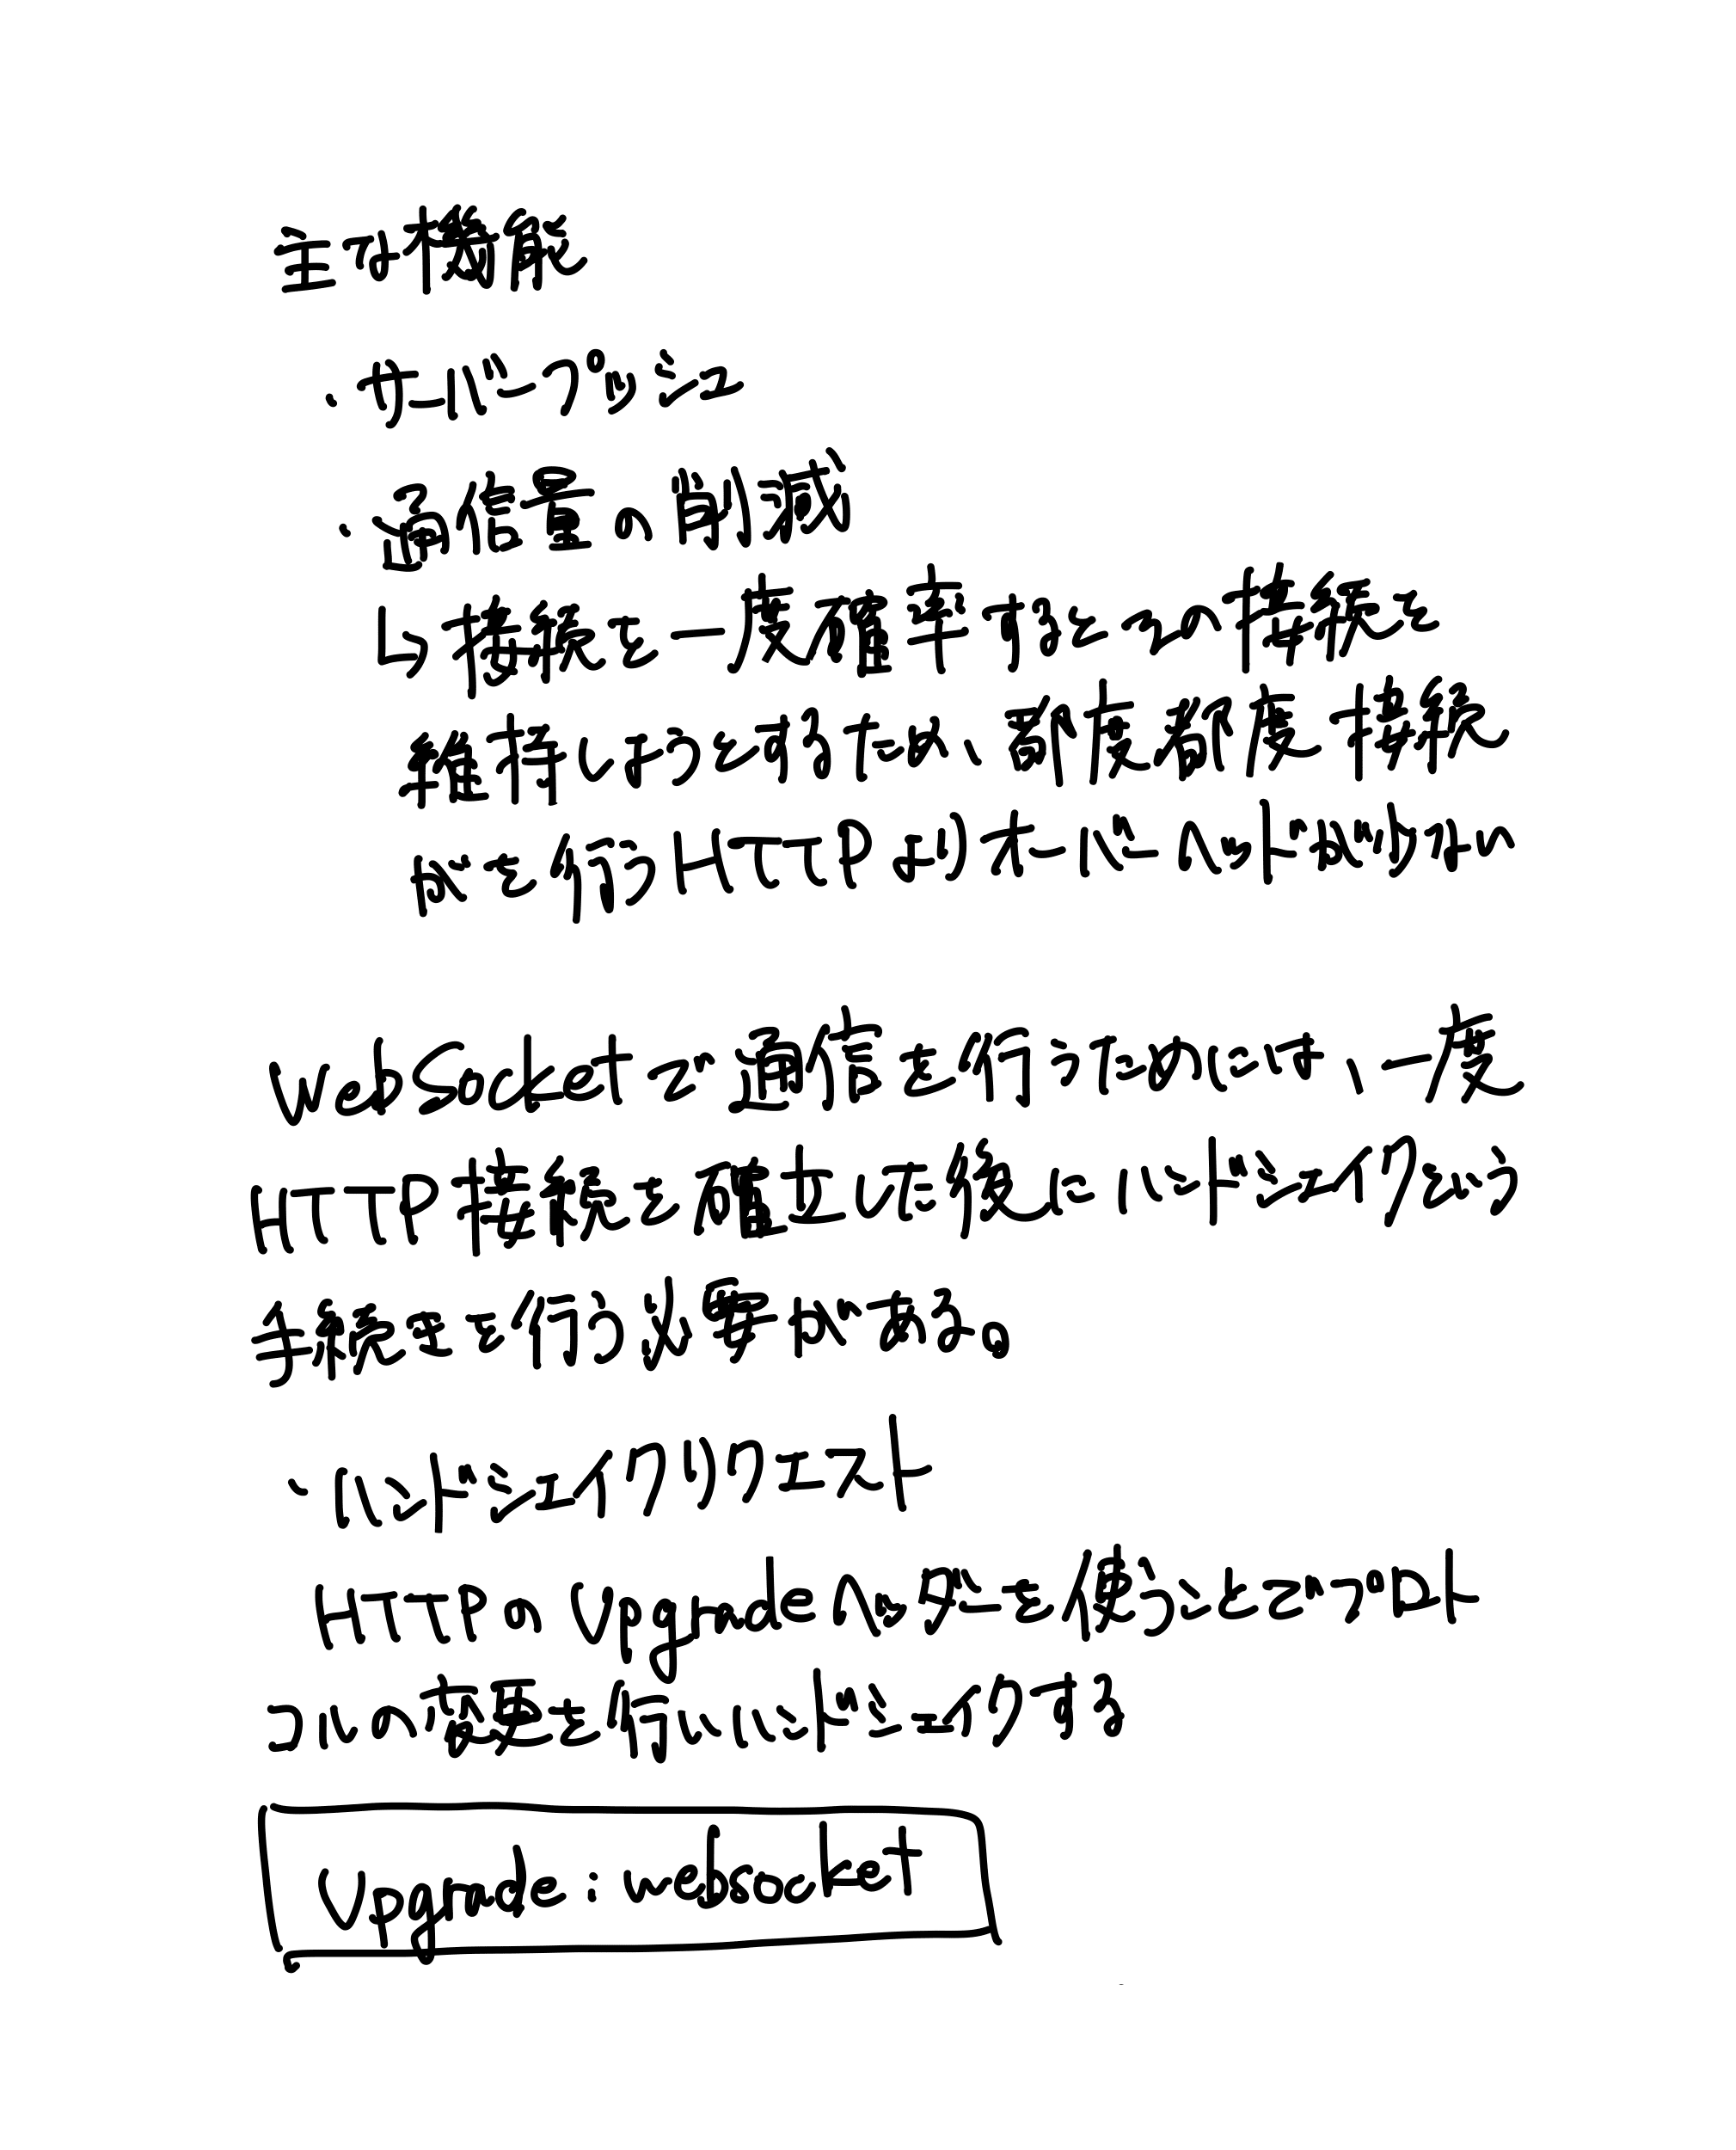
- 主な機能:サーバープッシュ / 通信量の削減(接続を一度確立すると維持しようとするため、都度接続するHTTPよりオーバーヘッドが少ない)。
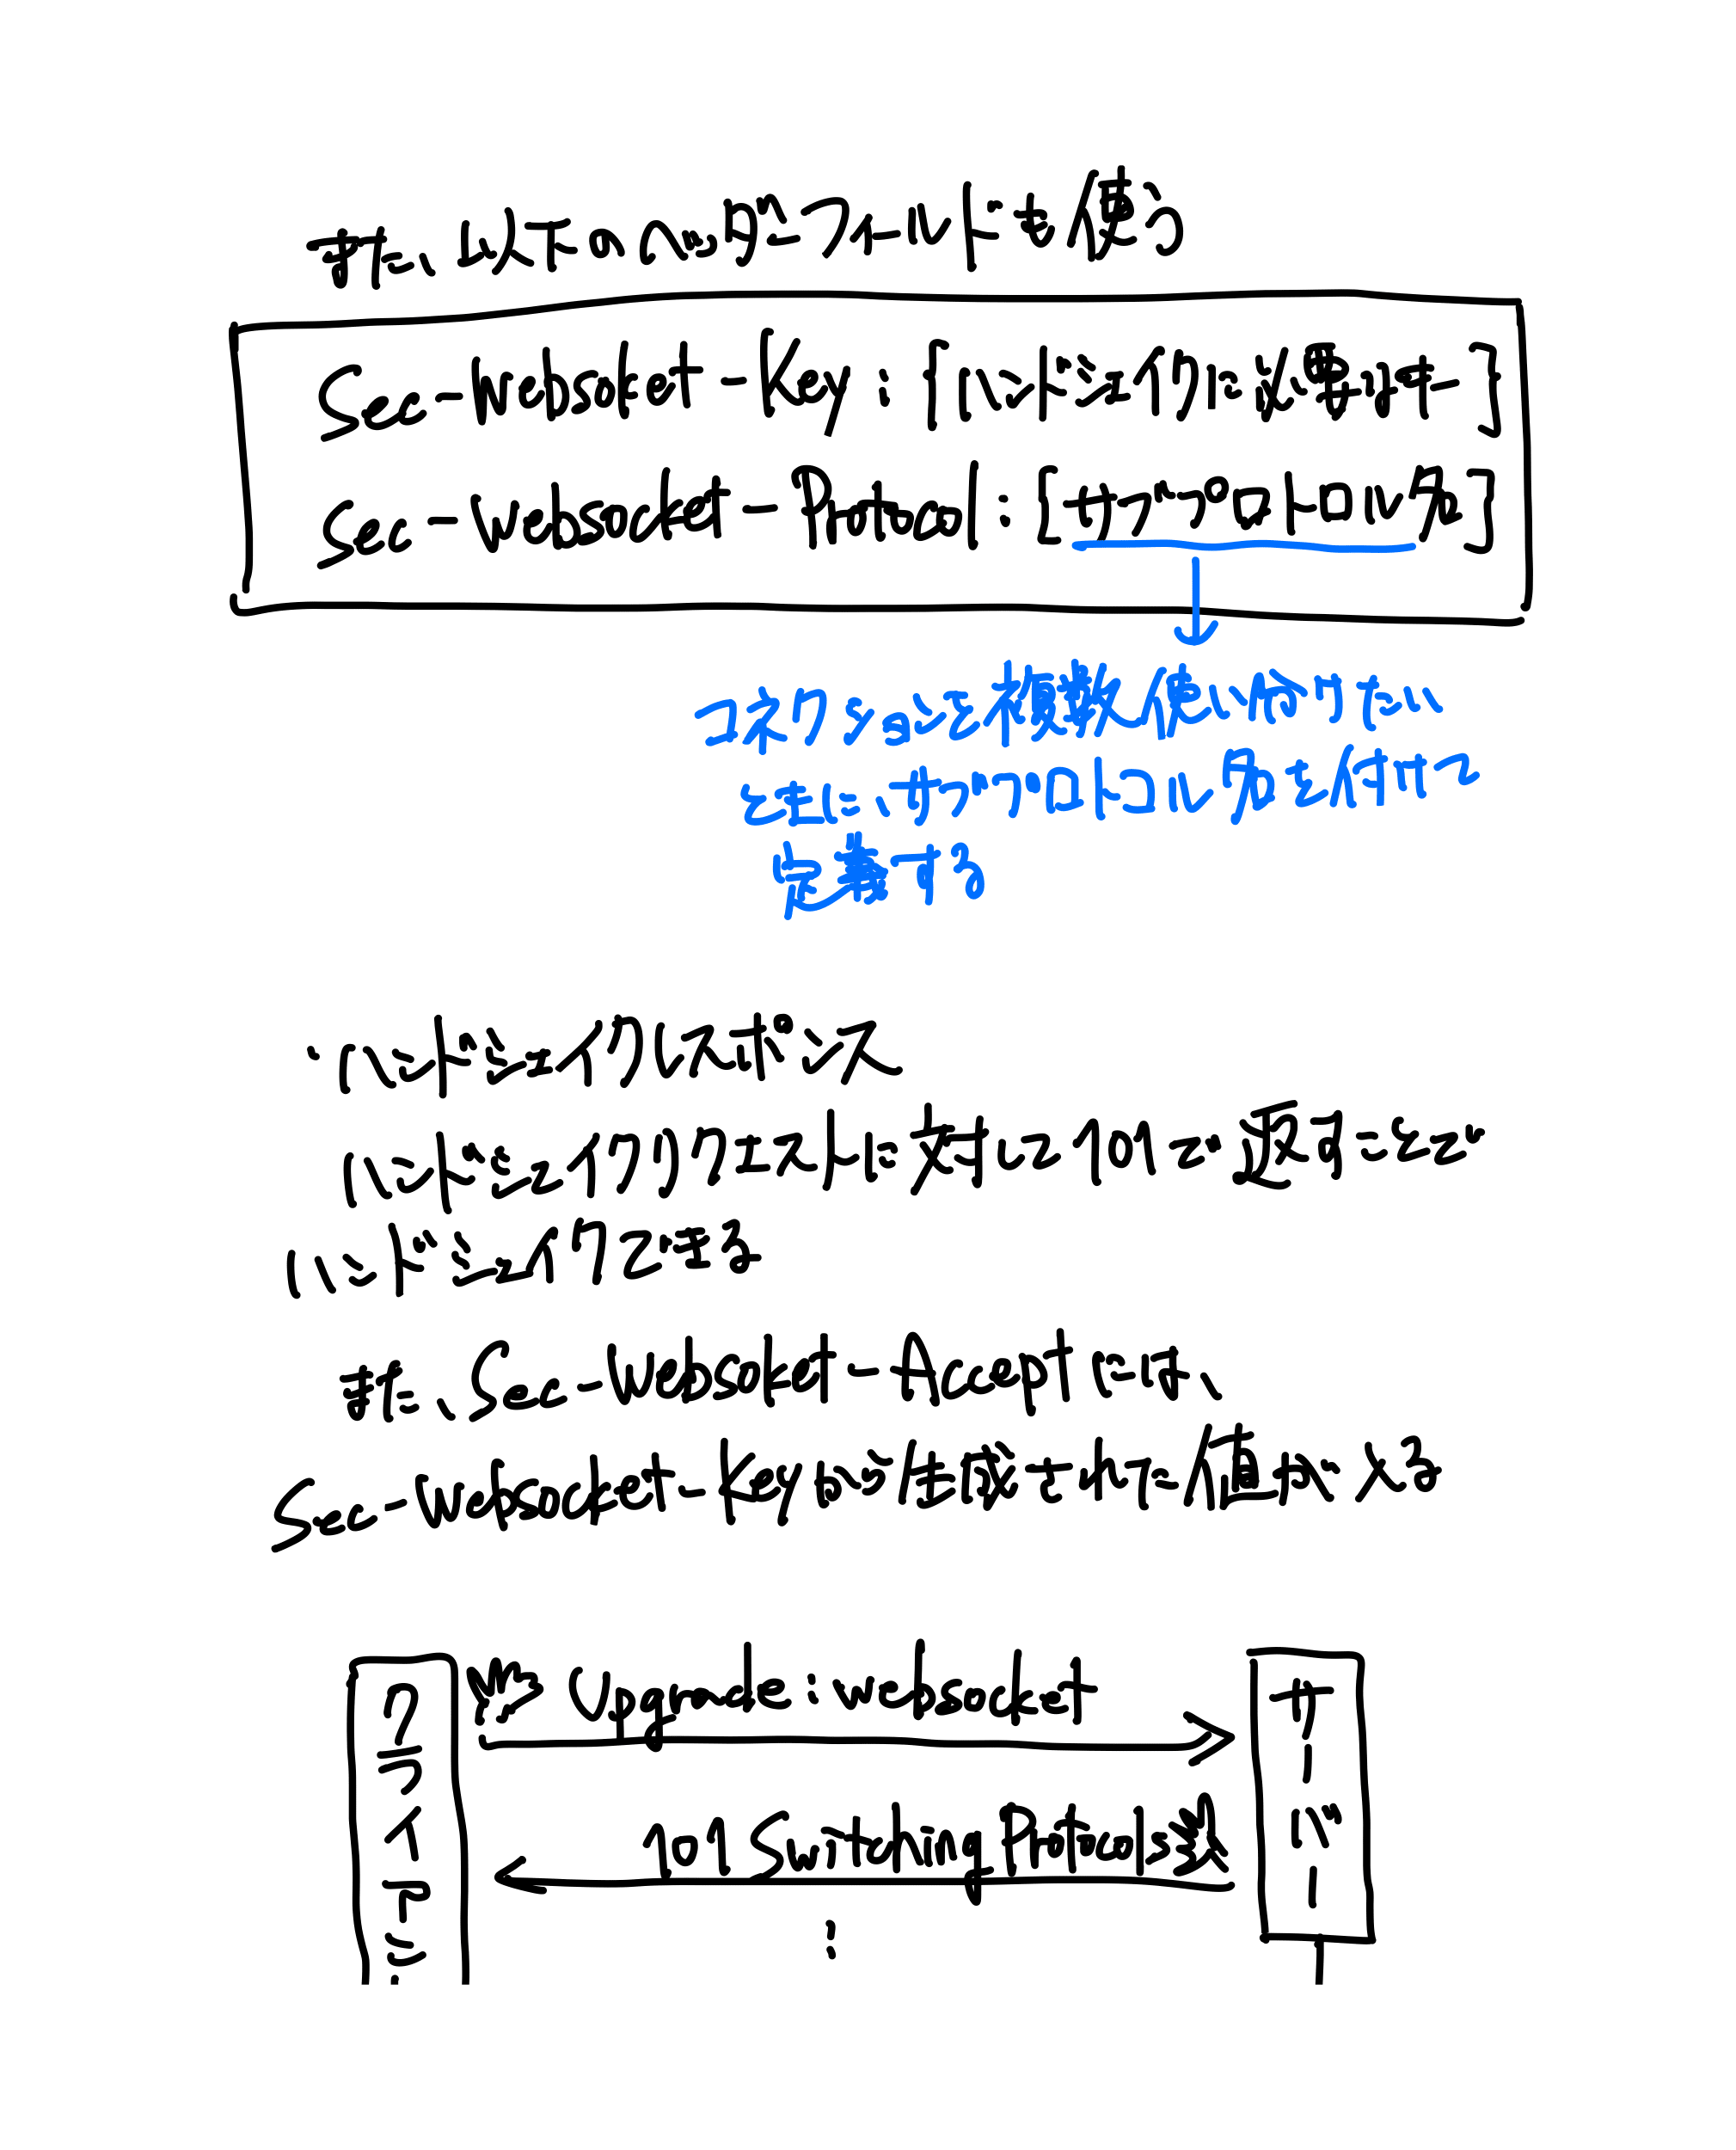
- 通信手順:一度HTTP接続を確立した後にハンドシェイクを行う。
- ハンドシェイクリクエスト → HTTPの Upgrade ヘッダーでプロトコル変更(
Upgrade: websocket)。Sec-WebSocket-Key(必要なキー)、Sec-WebSocket-Protocol(サブプロトコル名)も使う。 - ハンドシェイクレスポンス → 101 で返すことでハンドシェイク成立。
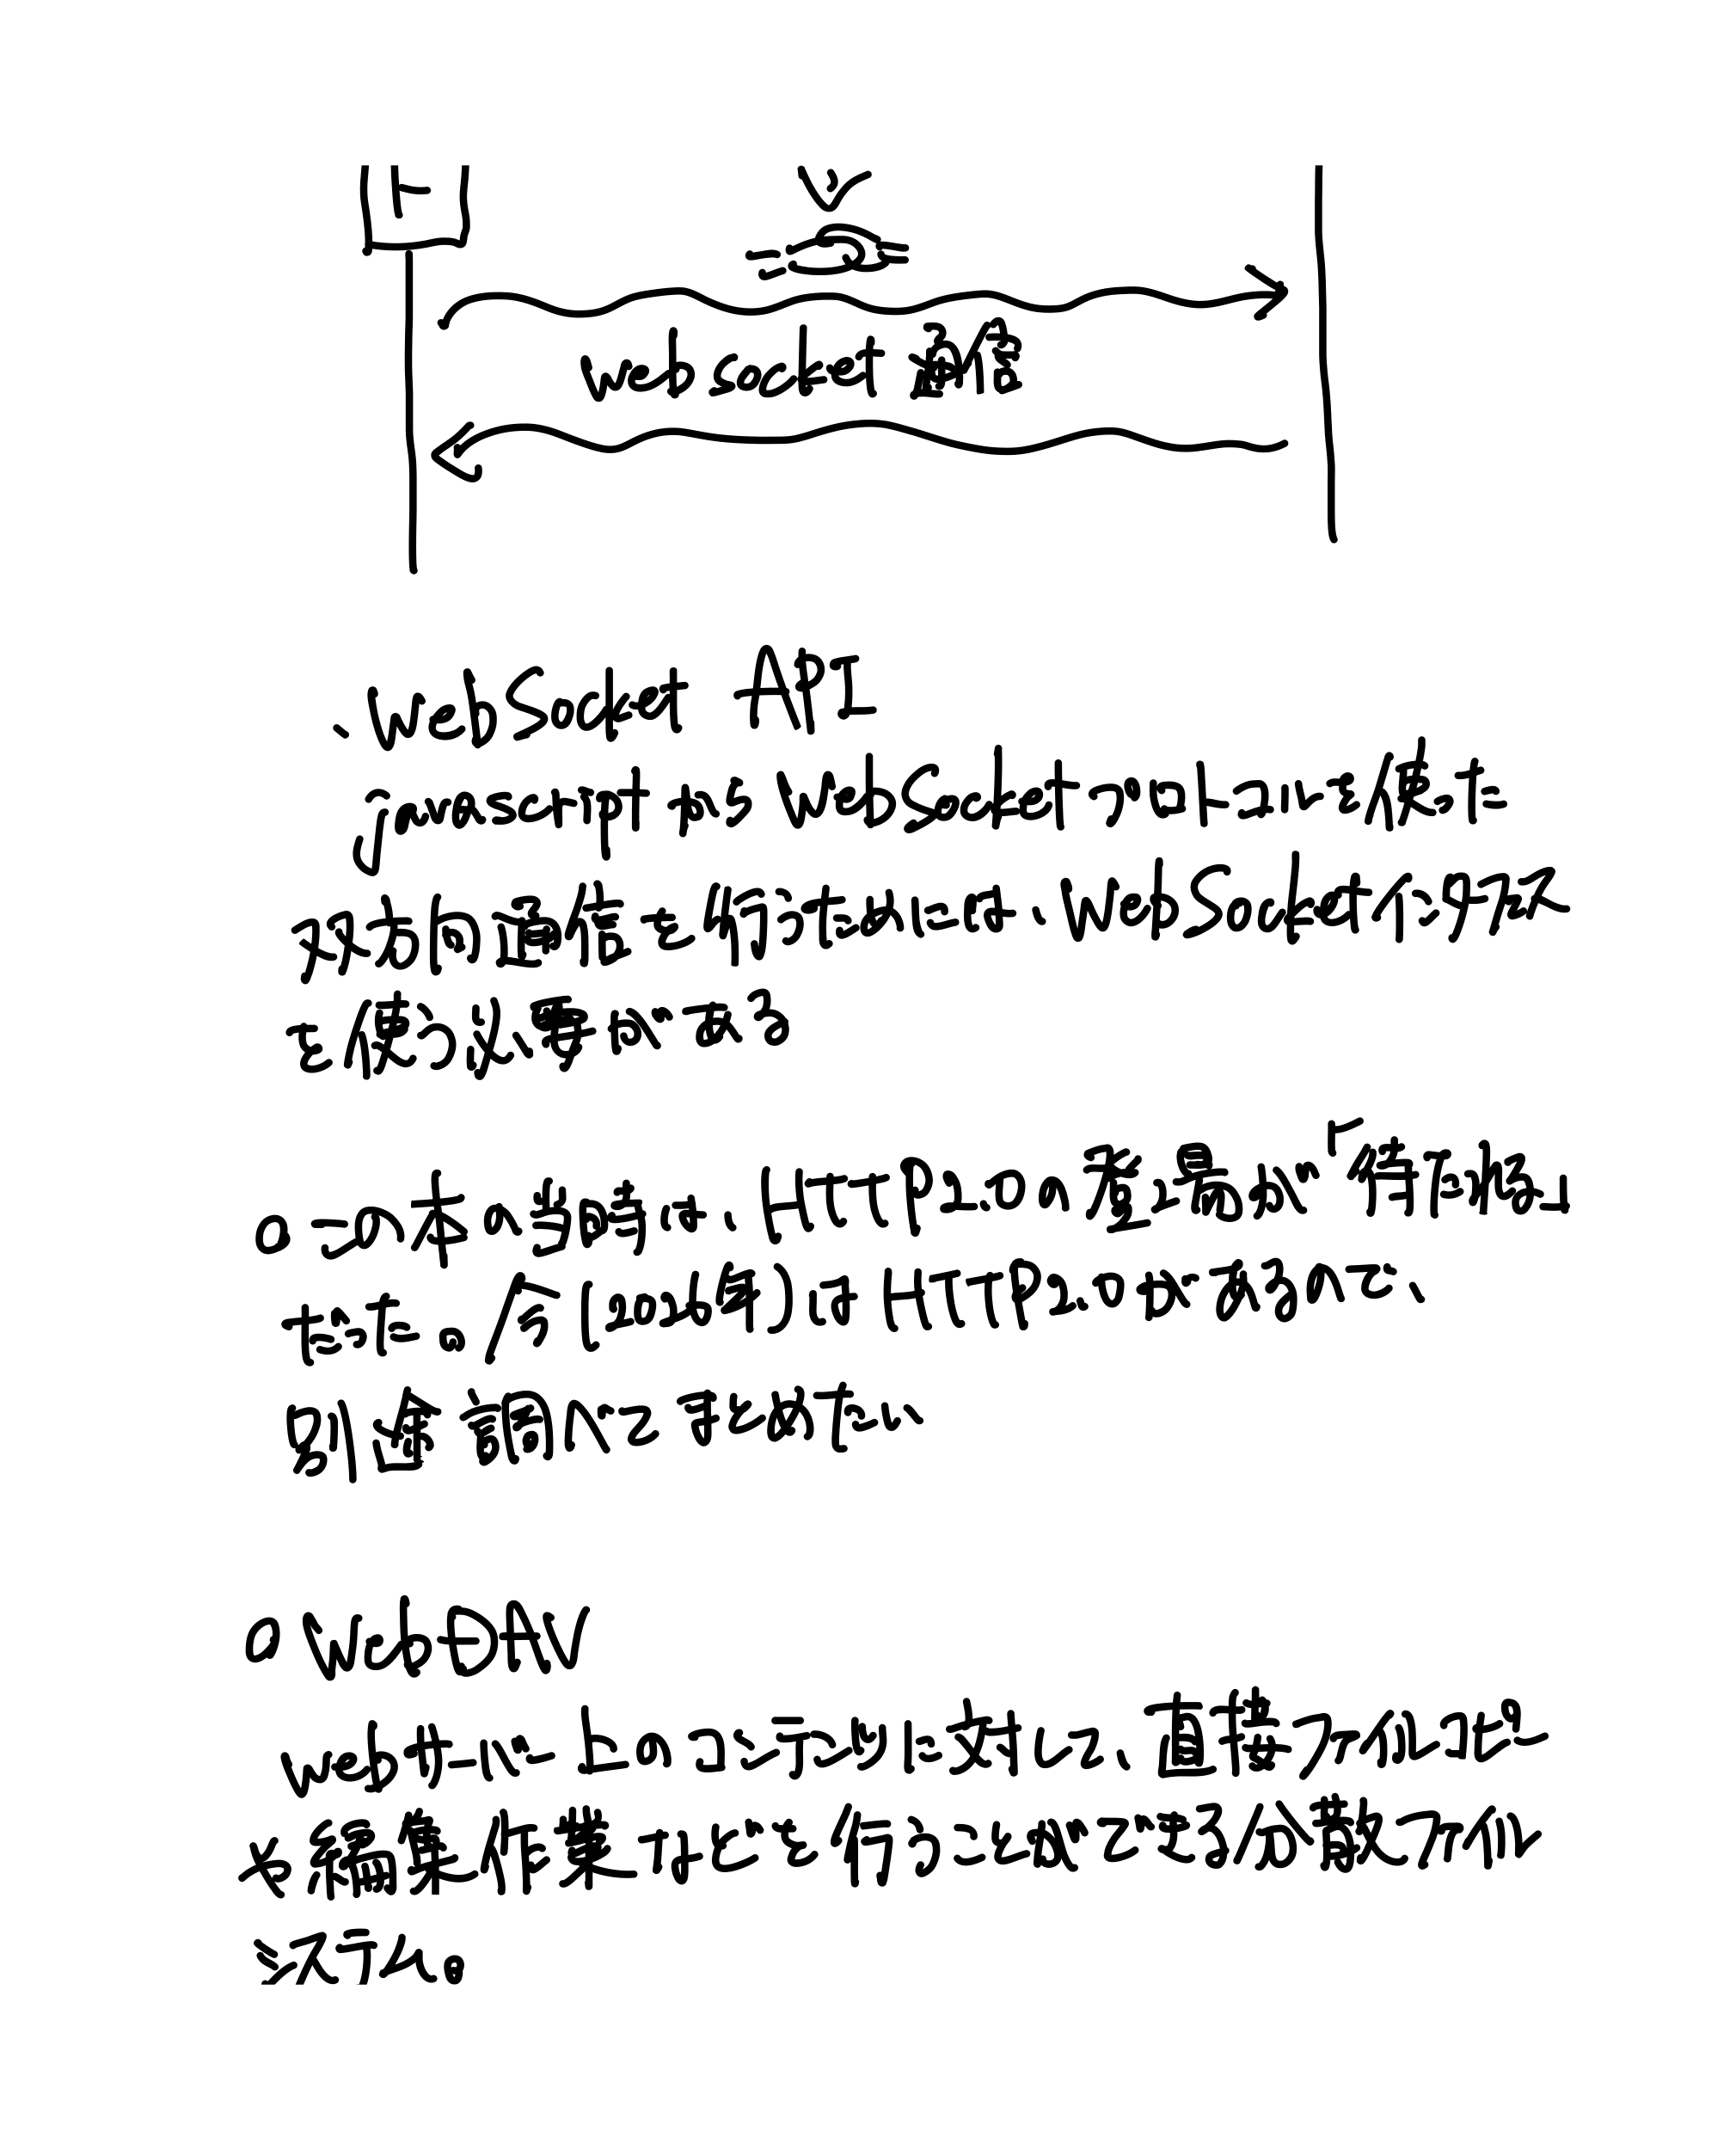
Sec-WebSocket-Acceptには Key から生成された値が入る。 - 以降は WebSocket 通信。
- ハンドシェイクリクエスト → HTTPの Upgrade ヘッダーでプロトコル変更(
- WebSocket API → JS から双方向通信を行うには WebSocket インタフェースを使う。
- ※この本の当時は HTTP2.0 の登場が待たれていた。今(2026年)は HTTP2.0 があるので別途調べてまとめたい。
WebDAV
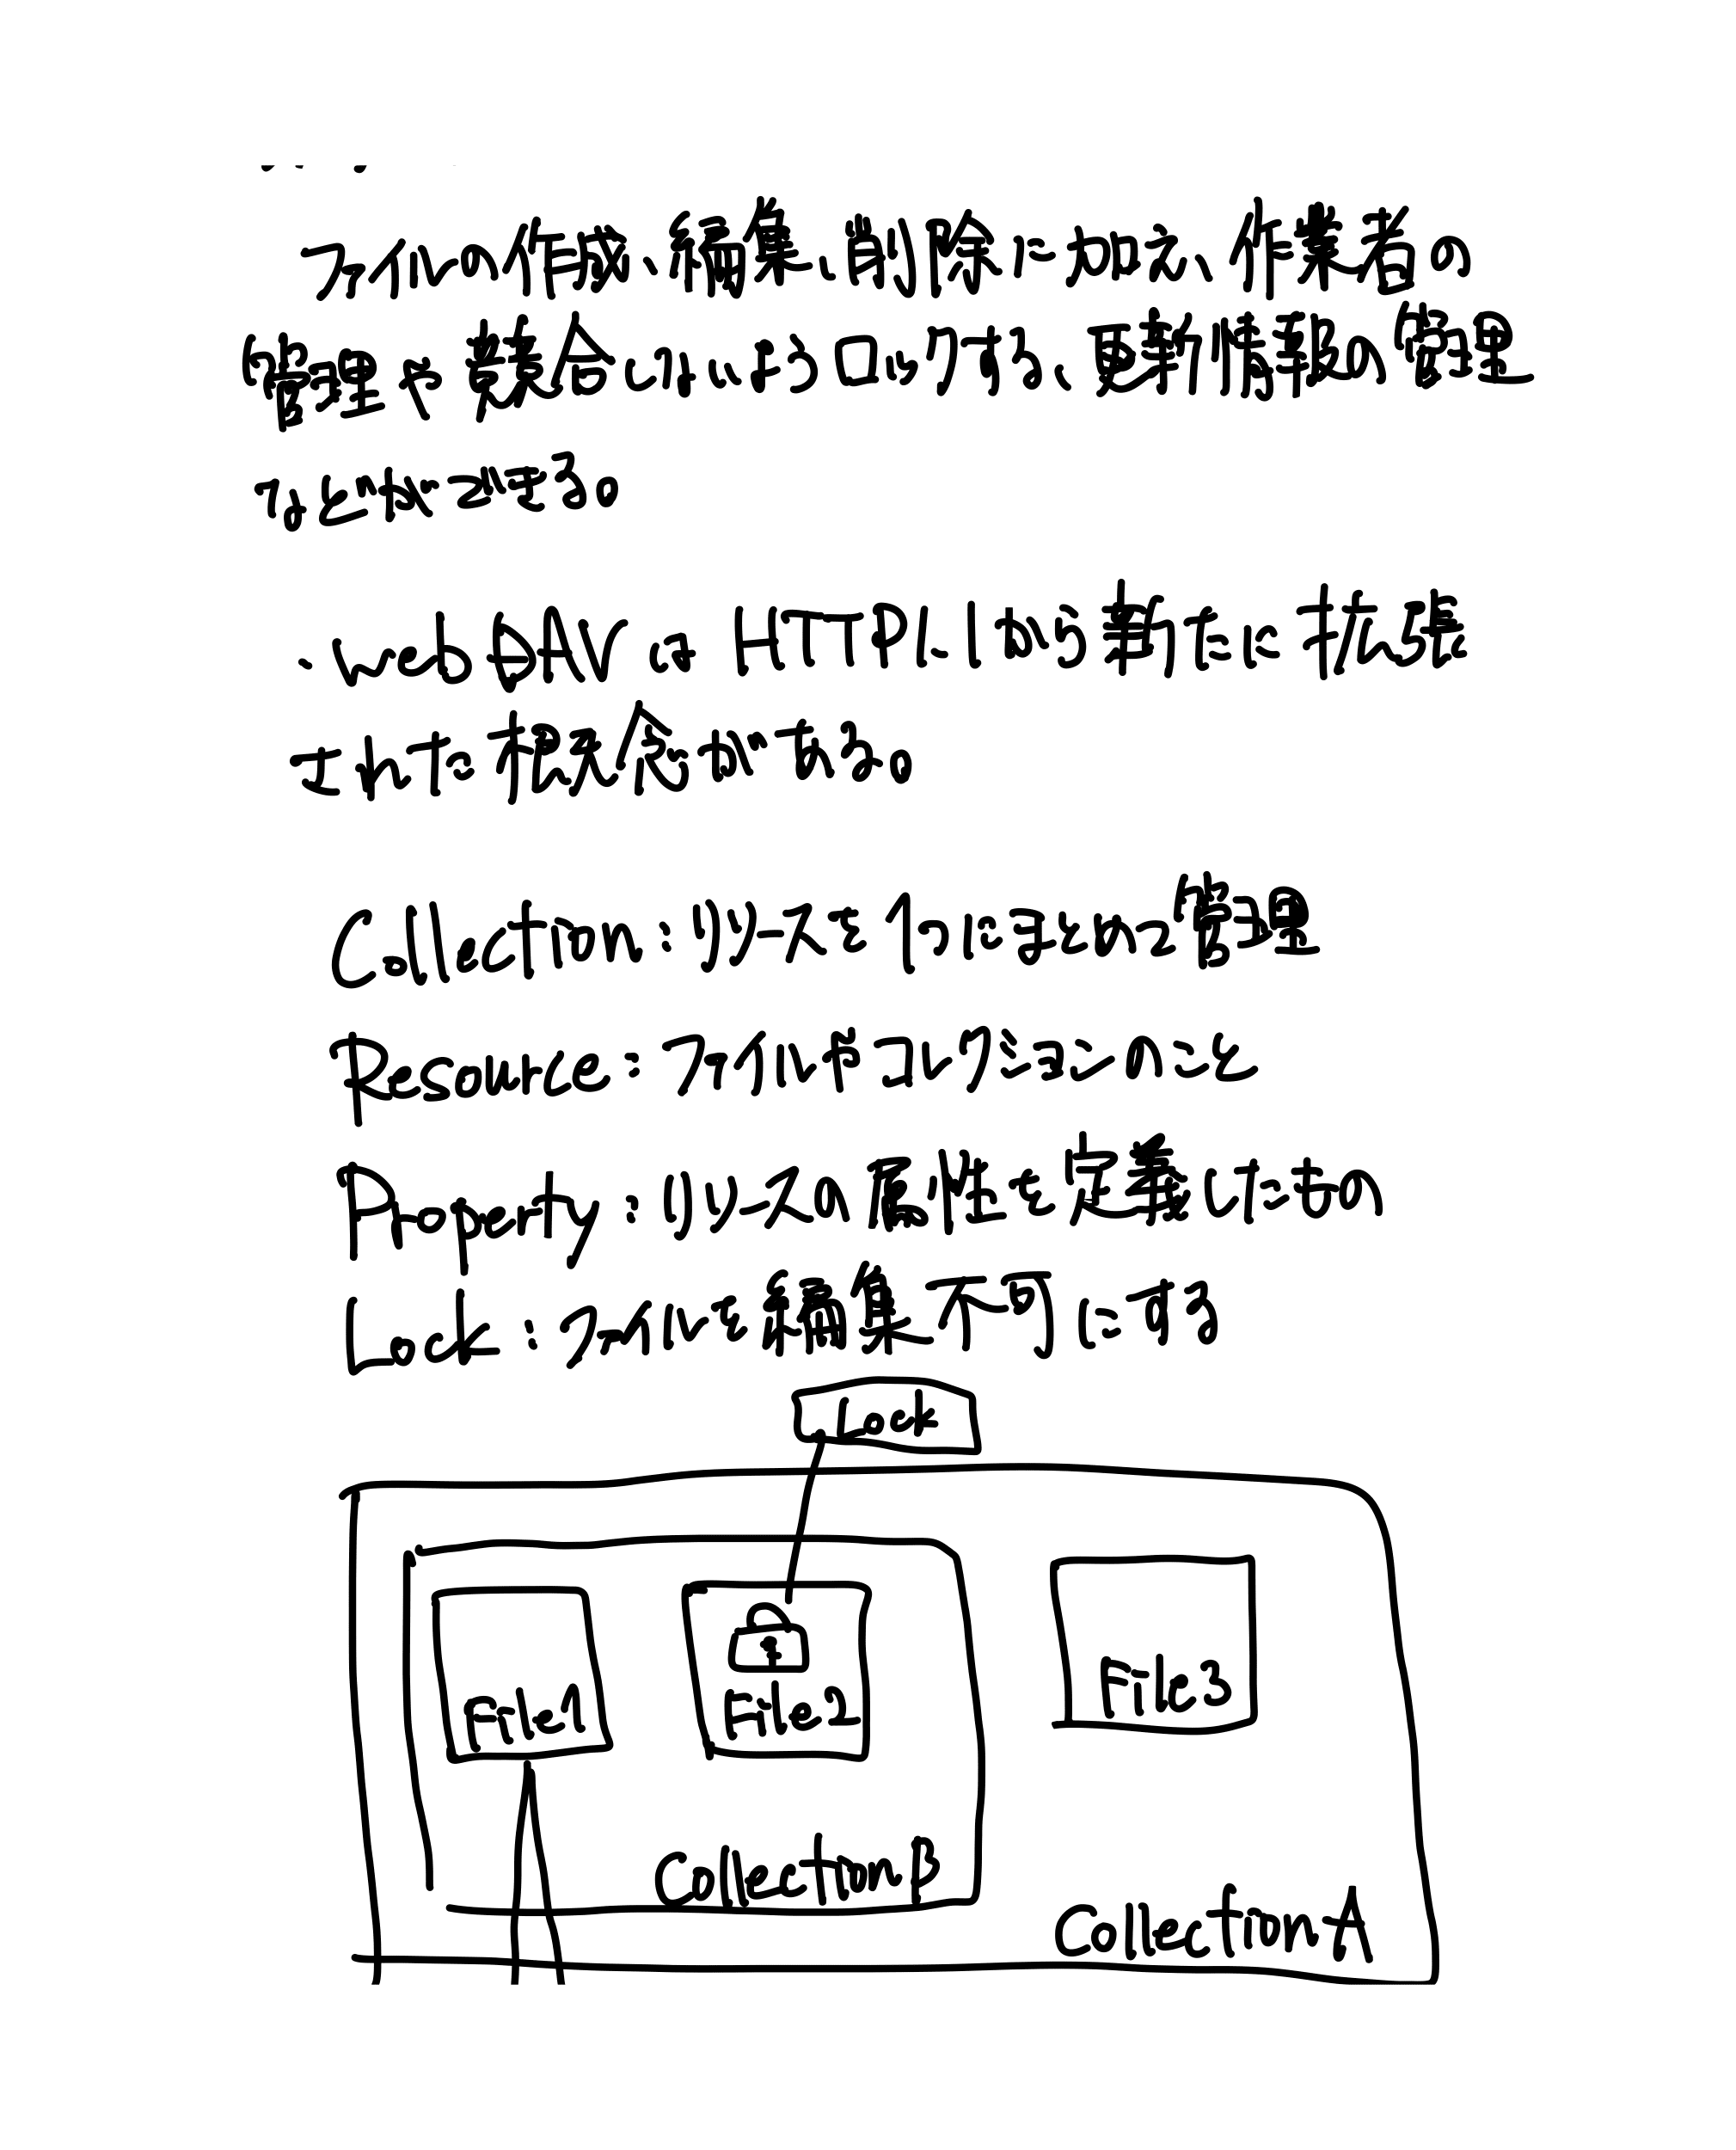
- Webサーバー上のコンテンツに対して直接ファイルコピーや編集を行える分散ファイルシステム。作成・編集・削除に加え、作業者の管理、競合しないようロック、更新情報の管理などができる。
- HTTP1.1 から拡張された概念:
- Collection:リソースを1つにまとめて管理
- Resource:ファイルやコレクションのこと
- Property:リソースの属性を定義したもの
- Lock:ファイルを編集不可にする
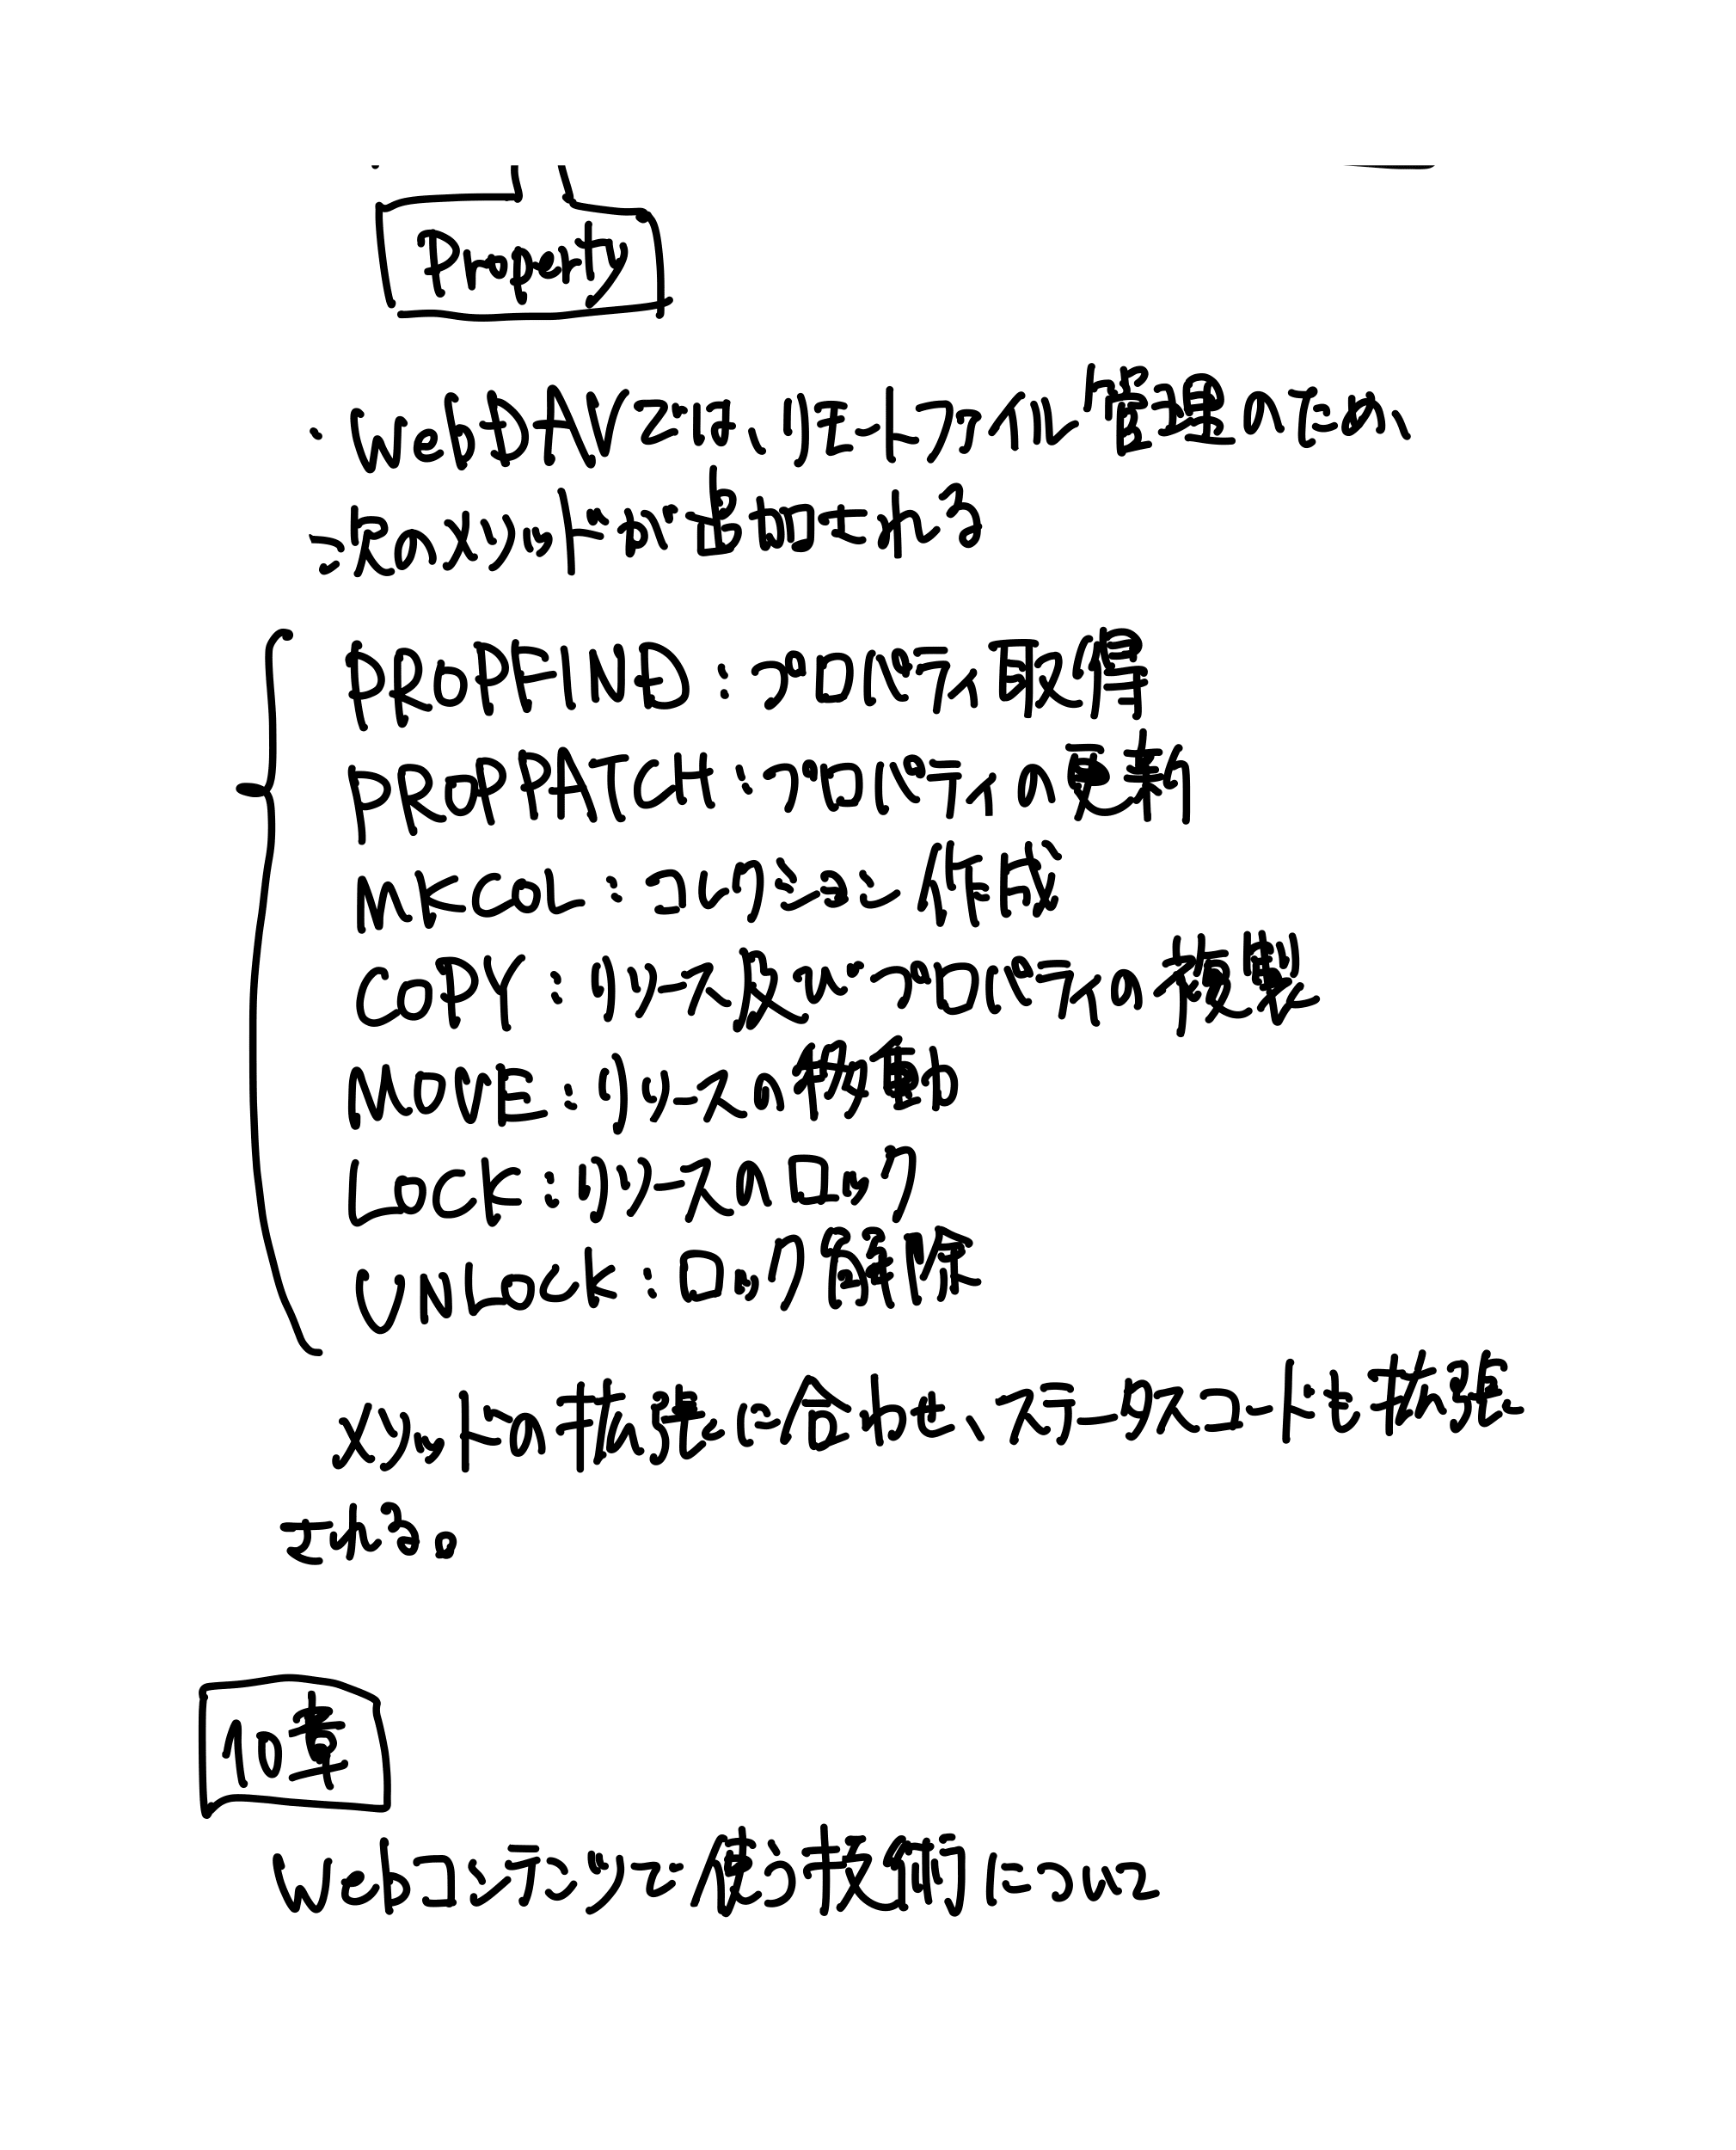
- 追加されるメソッド:
- PROPFIND:プロパティ取得 / PROPPATCH:プロパティ更新 / MKCOL:コレクション作成 / COPY:リソース・プロパティの複製 / MOVE:リソース移動 / LOCK:ロック / UNLOCK:ロック解除
- メソッドの拡張に合わせ、ステータスコードも拡張される。
10章 Webコンテンツで使う技術
- HTML / CSS
- Dynamic HTML → Webページを動的に変更する(Google Maps など)
- Webアプリ(動的コンテンツ / 静的コンテンツ)
- CGI(Common Gateway Interface)→ Webサーバーがクライアントから受け取った req をプログラムに渡す仕組み(Perl、PHP、C など)
- サーブレット(Servlet)→ サーバー上で動的コンテンツを生成するプログラム。CGIは大量reqで高負荷になるが、サーブレットは軽くできる対抗技術として普及。
- データ配信のフォーマット・言語:XML、RSS、Atom、JSON など
11章 Webへの攻撃技術
- HTTPは仕組みが単純でセキュリティの概念がない。Webアプリはセキュリティが重要だが、HTTPには機能がないため、Webアプリ側で1から作る必要がある。そのレベルが不十分だと脆弱性を抱える。
- 攻撃パターンは2つ:
- 能動的攻撃 → サーバーを狙う。SQLインジェクションやOSコマンドインジェクションなど、攻撃者自身の手で実行するもの。
- 受動的攻撃 → ユーザーを狙う。XSSなど、ユーザーが誤って実行するのを待つもの。
- オープンリダイレクト → Webアプリやサーバーの設定不足を狙う攻撃の1つ。
http://hoge.com/fuga?redirect=http://bad.com- ユーザーは
fuga(信頼するドメイン)だけ見て安全と判断しがち。redirectでリダイレクトする機能を悪用し、フィッシングなどにつながる。